

Python三元运算符常见误区:何时不该使用它
深入解析Python三元运算符(条件表达式)的设计原理、五大典型误用场景及重构方案,提供清晰的决策流程图与适用边界对照,帮助开发者编写更清晰、健壮的Python代码。
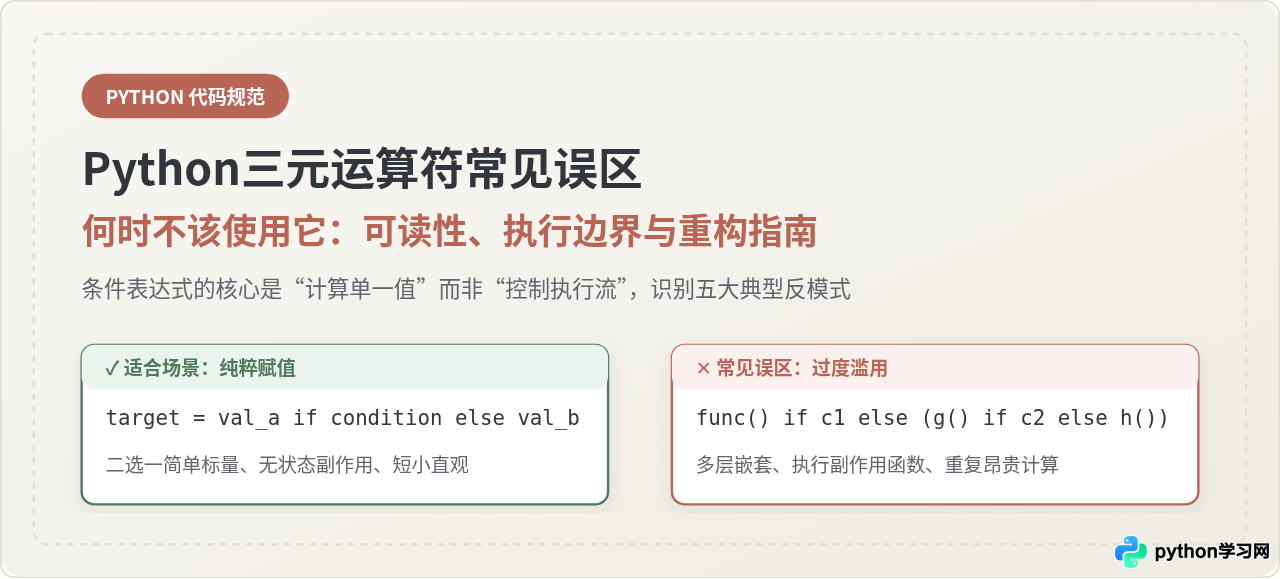
Python 的三元运算符(正式名称为条件表达式,Conditional Expression)为“基于二选一条件计算单值”提供了紧凑的书写形式。然而,在日常开发和代码评审中,它常常被错误地当成普通控制流语句使用,导致代码出现多层嵌套、隐蔽的副作用以及难以排查的性能浪费。本文直接厘清三元运算符的语法本质,深入剖析五个最典型的误用场景,并给出清晰的重构与判断流水线。
一、三元运算符的定位与语法底层逻辑
Python 在 2.5 版本引入了 PEP 308,正式确立了三元条件表达式的语法形式:
# Python 条件表达式的标准形式
value = value_if_true if condition else value_if_false
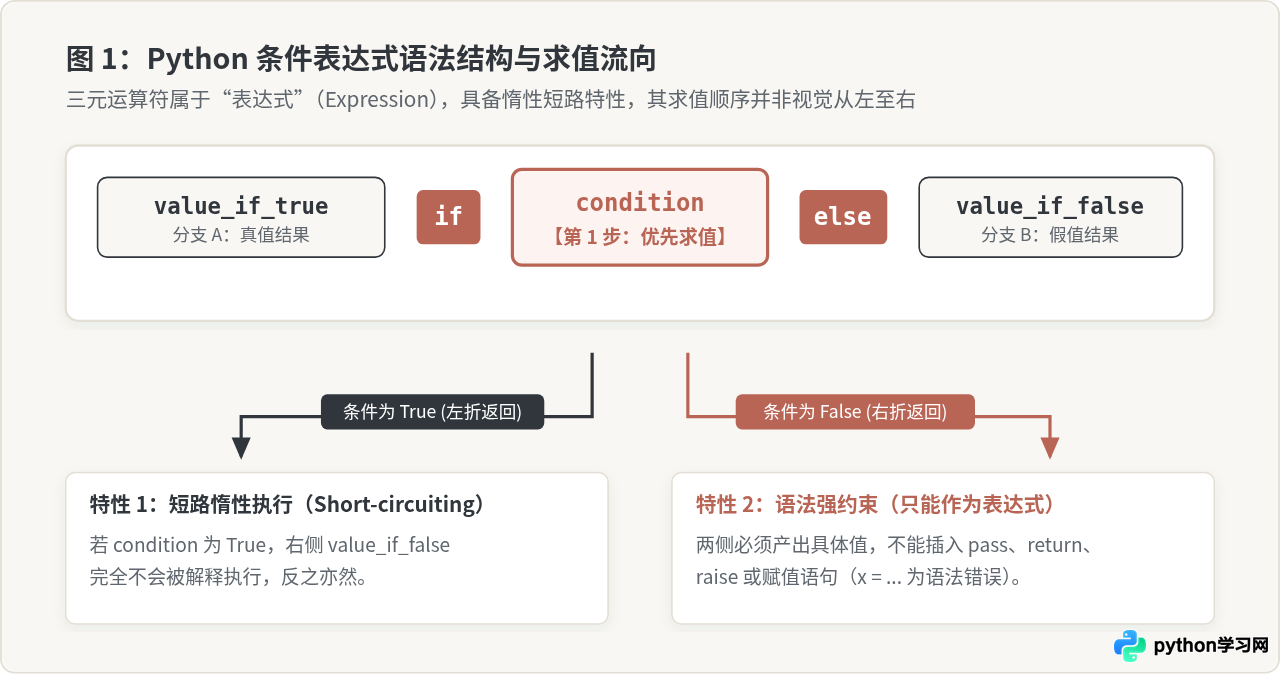
理解“何时不该用它”的前提,是明确它在 Python 语法体系中的定位。三元运算符在本质上是一个表达式(Expression),而不是语句(Statement)。表达式的核心任务是参与运算并返回单一对象的引用。这意味着它的两端必须能够合法产出值,而不能包含变量赋值、异常抛出或 pass 等语句结构。
此外,Python 的三元运算符具有短路求值(Short-circuit evaluation)特性。当 condition 计算为真时,value_if_false 分支完全不会被执行;反之,若条件为假,左侧的 value_if_true 也绝不会被求值。这种机制虽然保证了分支安全性,但其由中间向两端发散的语法顺序(先读左、再看中、后看右),在人类视觉认知上不同于传统的从上至下执行流。
二、常见误区:何时绝对不该使用三元运算符
当一行代码为了追求“简短”而牺牲了“直观与健壮”时,代码就已经退化成了技术负债。以下是五个在实际工程中最常见且危害最大的误用场景:
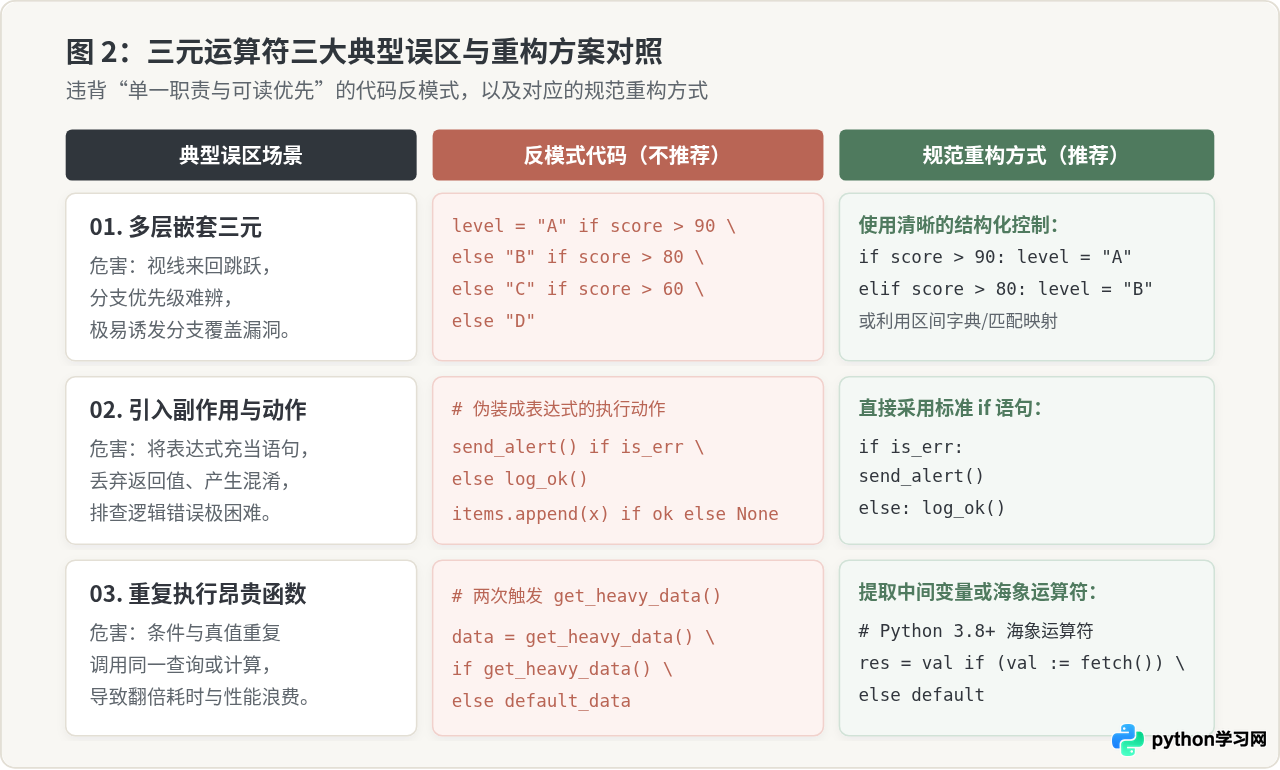
1. 误区一:编写多层嵌套的三元运算符
当判断分支超过两个(即存在三种及以上可能性)时,强行将多个三元运算符级联在一起,是导致代码可读性崩塌的头号元凶。
# ✕ 典型反模式:三层嵌套的条件表达式
status_text = (
    "极高风险" if score > 90
    else "中度预警" if score > 60
    else "低风险" if score > 30
    else "安全"
)
为什么不该这样写:在传统 if-elif-else 结构中,判断条件与执行动作自上而下对齐,逻辑分支泾渭分明。而在级联的三元表达式中,条件关键词 if 和 else 散落在中间与末尾,维护者需要在大脑中反复拼凑结合性优先级,极大增加了单元测试用例遗漏边界条件的风险。
if-elif-else 语句块,或者在 Python 3.10+ 中采用模式匹配 match-case;如果是静态值查找,优先提取为配置字典或元组区间表。
2. 误区二:在分支中执行副作用或过程性动作
三元表达式的设计初衷是“计算值”,而不是“执行动作”。某些开发者为了省略两行代码缩进,将无返回值的函数调用硬塞入分支中:
# ✕ 典型反模式:把表达式充当流程控制语句使用
send_sms_notification(user) if user.is_vip else log_guest_access(user)

# ✕ 典型反模式:为了单行而在分支内操作列表状态
active_users.append(user) if is_valid else None
为什么不该这样写:send_sms_notification 和 list.append 的返回值均为 None。整行代码求值后产出的结果被完全丢弃,这表明此处的真实意图是过程控制而非数据赋值。在代码中留下一个返回 None 的孤立表达式,不仅违背了函数式编程的纯净性,还会让静态类型检查工具(如 Mypy)和代码审查者产生困惑。
3. 误区三:为了塞入长表达式导致单行认知负担超载
当 condition 本身是由多个逻辑运算符(and、or、not)构成的长复合判断,或者真假值部分包含复杂的推导式或字典生成式时,强行放在一行内会彻底破坏扫读体验:
# ✕ 典型反模式:条件极其冗长且包含复杂逻辑运算
payload = {"type": item.kind, "val": item.calc()} if item.is_active and not item.is_expired and (user.role == "admin" or user.has_perm("bypass")) else {}
这种代码即便使用括号换行折叠,也使得视觉锚点难以聚焦。此时正确的做法是提取命名良好的布尔变量(例如 can_access_item),再决定是用标准 if 还是单行三元。
4. 误区四:在推导式中混淆过滤条件与转换条件
在列表推导式或生成器表达式中,条件语句可以出现在两个不同的位置:末尾的元素过滤器(Filter)与开头的元素映射转换(Map)。新手常误将三元运算符写错位置或过度混用:
# ✕ 容易引发歧义与理解混乱的双重条件推导式
result = [
    transform(x) if is_special(x) else default_proc(x)
    for x in raw_dataset
    if x.is_valid()
]
虽然上述语法在 Python 中完全合法,但在一个推导式内同时存在两个 if(前一个负责三元转换,后一个负责数据过滤),极容易导致维护人员在快速扫读时漏看末尾的过滤条件,造成对数据集范围的误判。若转换逻辑复杂,应将映射逻辑剥离成具名生成器函数。
5. 误区五:在需要异常处理和重复昂贵计算时强行拼装
有时开发者希望对可能抛出异常或开销极大的操作做后备兜底,但三元表达式无法捕获异常,导致产生拙劣的重复调用:
# ✕ 典型反模式:由于三元无法捕获异常或无法缓存结果,造成重复查询
result = query_remote_api(param) if query_remote_api(param) is not None else default_cache
上面的代码对远程接口进行了两次完全相同的网络请求,带来了巨大的延迟和性能损耗。即便在 Python 3.8+ 中可以使用海象运算符 := 缓解,但涉及错误捕获(try-except)时,任何尝试用三元运算绕过语句块的做法都是不安全的。
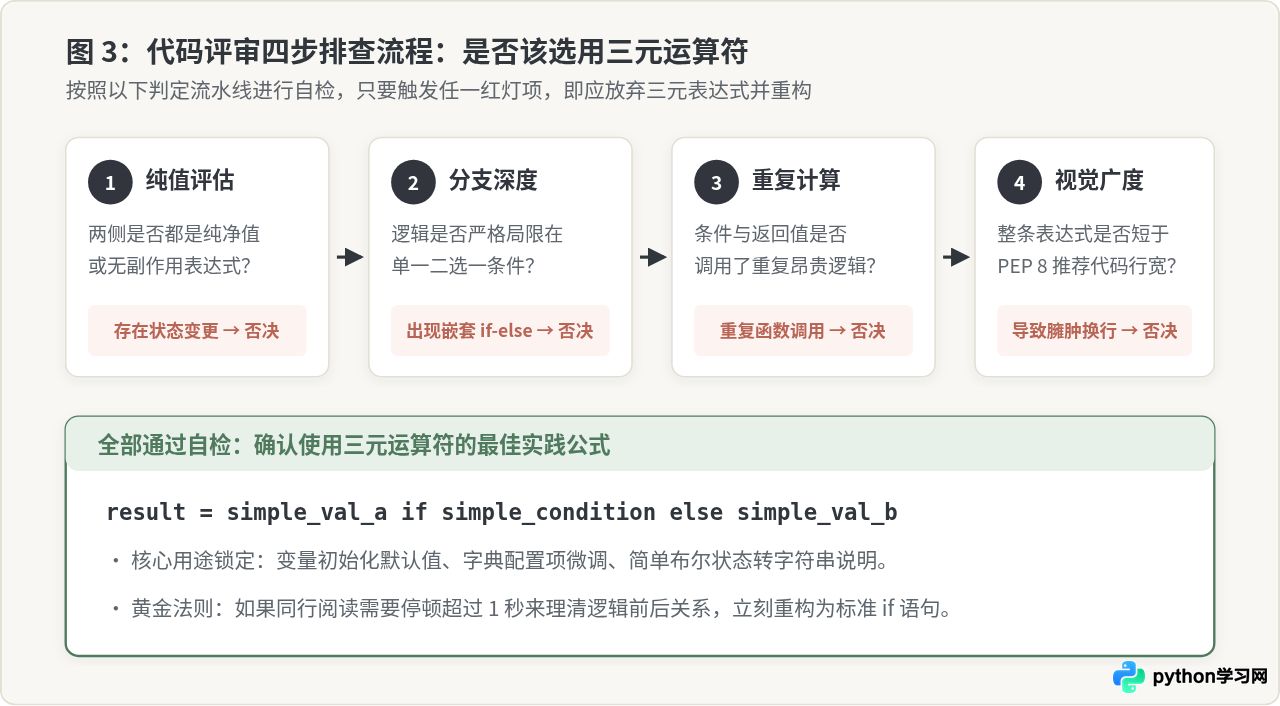
三、判断决策:四步排查是否该弃用三元运算符
在编写或评审一段代码时,如何客观判断是否应当拆解现有的三元表达式?遵循以下四个依序执行的排查步骤,可以迅速得出确切结论:
-
步骤 1:排查是否具有副作用(Side Effect Check)
检查两个分支的表达式是否包含状态改变操作(例如写文件、改数据库、操作列表字典或无返回值的函数)。如果只是想“执行一段动作”,立刻换用标准if语句。 -
步骤 2:检查分支数量与嵌套深度(Branch Depth Check)
数一数该行代码中出现了几个else关键字。只要出现超过 1 个else,意味着进入了嵌套分支逻辑,必须立即放弃三元表达式,改用垂直展开的控制流结构。 -
步骤 3:审查计算开销与重复求值(Redundant Calc Check)
检查condition是否对昂贵操作进行了重复求值。如果是,必须通过局部变量存储中间结果,不能为了强行单行而牺牲性能。 -
步骤 4:评估视觉扫读流畅度(Readability & Line-length Check)
检查表达式的总长度是否超出 PEP 8 标准(一般为 79 或 88 字符)。如果需要折行并拆分括号才能放得下,说明逻辑复杂度已经超出了单行三元的承载极限。
四、何时可以放心使用三元运算符
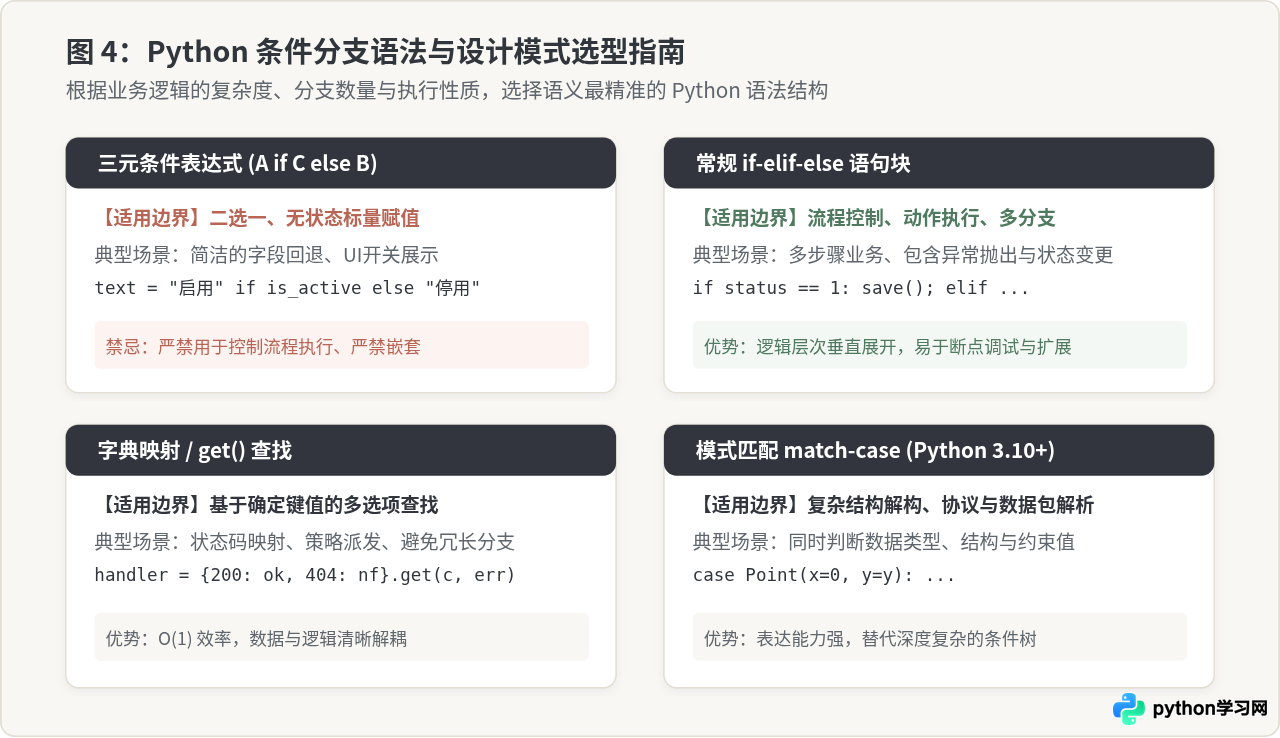
指出不该使用的误区,并非全盘否定三元运算符的价值。在明确满足“纯粹标量取值、二选一互斥、短小直观”的前提下,三元运算符是非常优雅且 Pythonic 的语法工具:
-
简单的默认值与空值回退:例如
display_name = user.nickname if user.nickname else "匿名用户"(或者借助or运算符)。 -
界面状态文案映射:例如
status_label = "运行中" if is_running else "已暂停"。 -
函数调用时的简单传参分支:例如
client.request(timeout=30 if is_prod else 5)。
五、总结与编码原则
代码首先是写给人阅读的,其次才是交给解释器执行。《Python之禅》(The Zen of Python)中明确写道:“Flat is better than nested”(扁平胜于嵌套)以及“Readability counts”(可读性至关重要)。
三元运算符是一把精密的手术刀,适合在表达式级别的局部细微处进行二选一赋值,而决不能作为承载复杂业务判断和控制流调度的通用工具。当面临“用三元写成一行”还是“用四行清晰展示 if-else”的选择时,始终应当优先选择对团队成员和未来的自己更友好的清晰结构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









