PHP 中获取和伪造 HTTP_REFERER 的方法与注意事项
本文详解 PHP 中利用 $_SERVER['HTTP_REFERER'] 获取用户访问来源,并通过底层 Socket 连接手动构造 HTTP Header 来伪造 Referer 的具体操作。同时解析了抓取网页时出现乱码的原因及 file_get_contents 自动处理 gzip 压缩的机制,提供实用的代码实例与排错参考。
2026-10-14
6

本文详解 PHP 中利用 $_SERVER['HTTP_REFERER'] 获取用户访问来源,并通过底层 Socket 连接手动构造 HTTP Header 来伪造 Referer 的具体操作。同时解析了抓取网页时出现乱码的原因及 file_get_contents 自动处理 gzip 压缩的机制,提供实用的代码实例与排错参考。
本文介绍如何通过 PHP 的 cURL 扩展抓取网页中的 AJAX 异步加载数据。核心思路是利用浏览器开发者工具定位异步接口 URL 和参数,然后通过脚本模拟发送请求。文中提供了完整的代码实现,包括 Cookie 处理和 POST 参数构造的详细步骤。
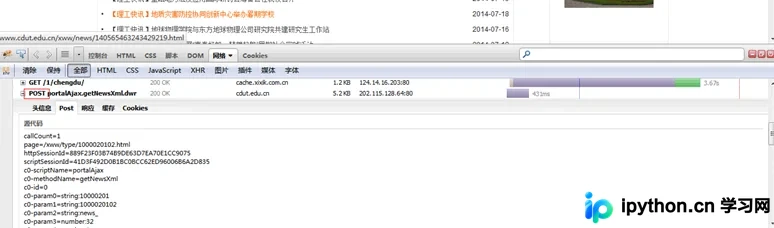
本文详细介绍了 PHP 进行网页数据采集时遭遇 IP 封禁的多种应对策略。核心方法包括伪装搜索引擎爬虫 User-Agent、伪造 Referer 来源、配置 HTTP 代理或 SOCKS 代理、模拟 X-Forwarded-For 头部,以及利用路由器重启获取新 IP 和修改 MAC 地址以规避更深层次的绑定限制。
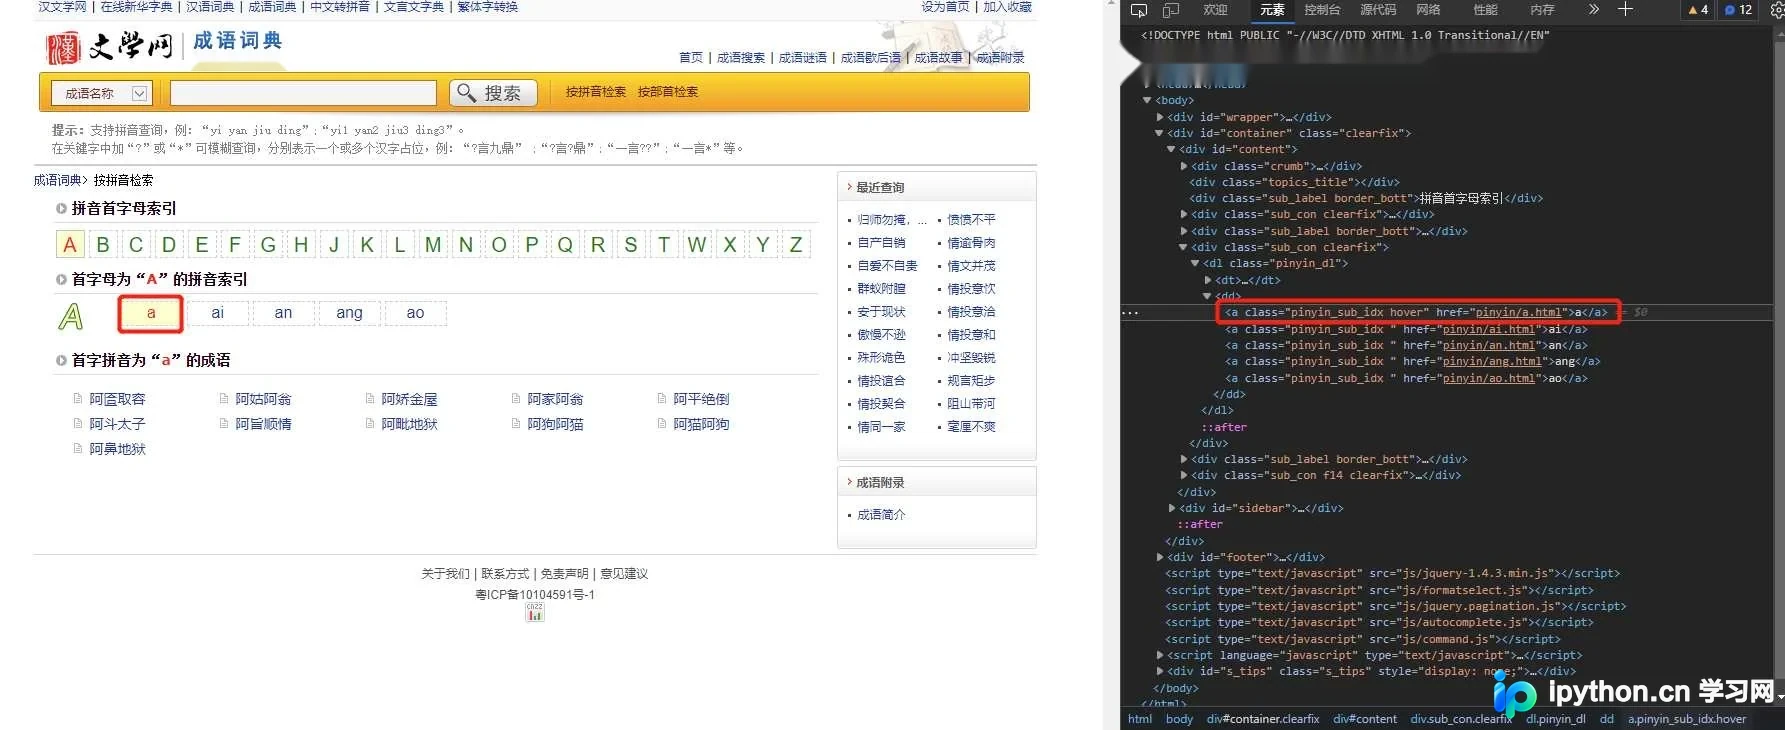
本文介绍如何使用Python开发一个成语接龙小助手。通过爬虫模块获取包含拼音、释义等详细属性的成语数据,并利用前缀树(Trie Tree)构建高效搜索提示功能。程序支持简单与困难两种模式,提供逐步提示、成语详情查看及错误处理,适合Python初学者学习爬虫与数据结构应用。
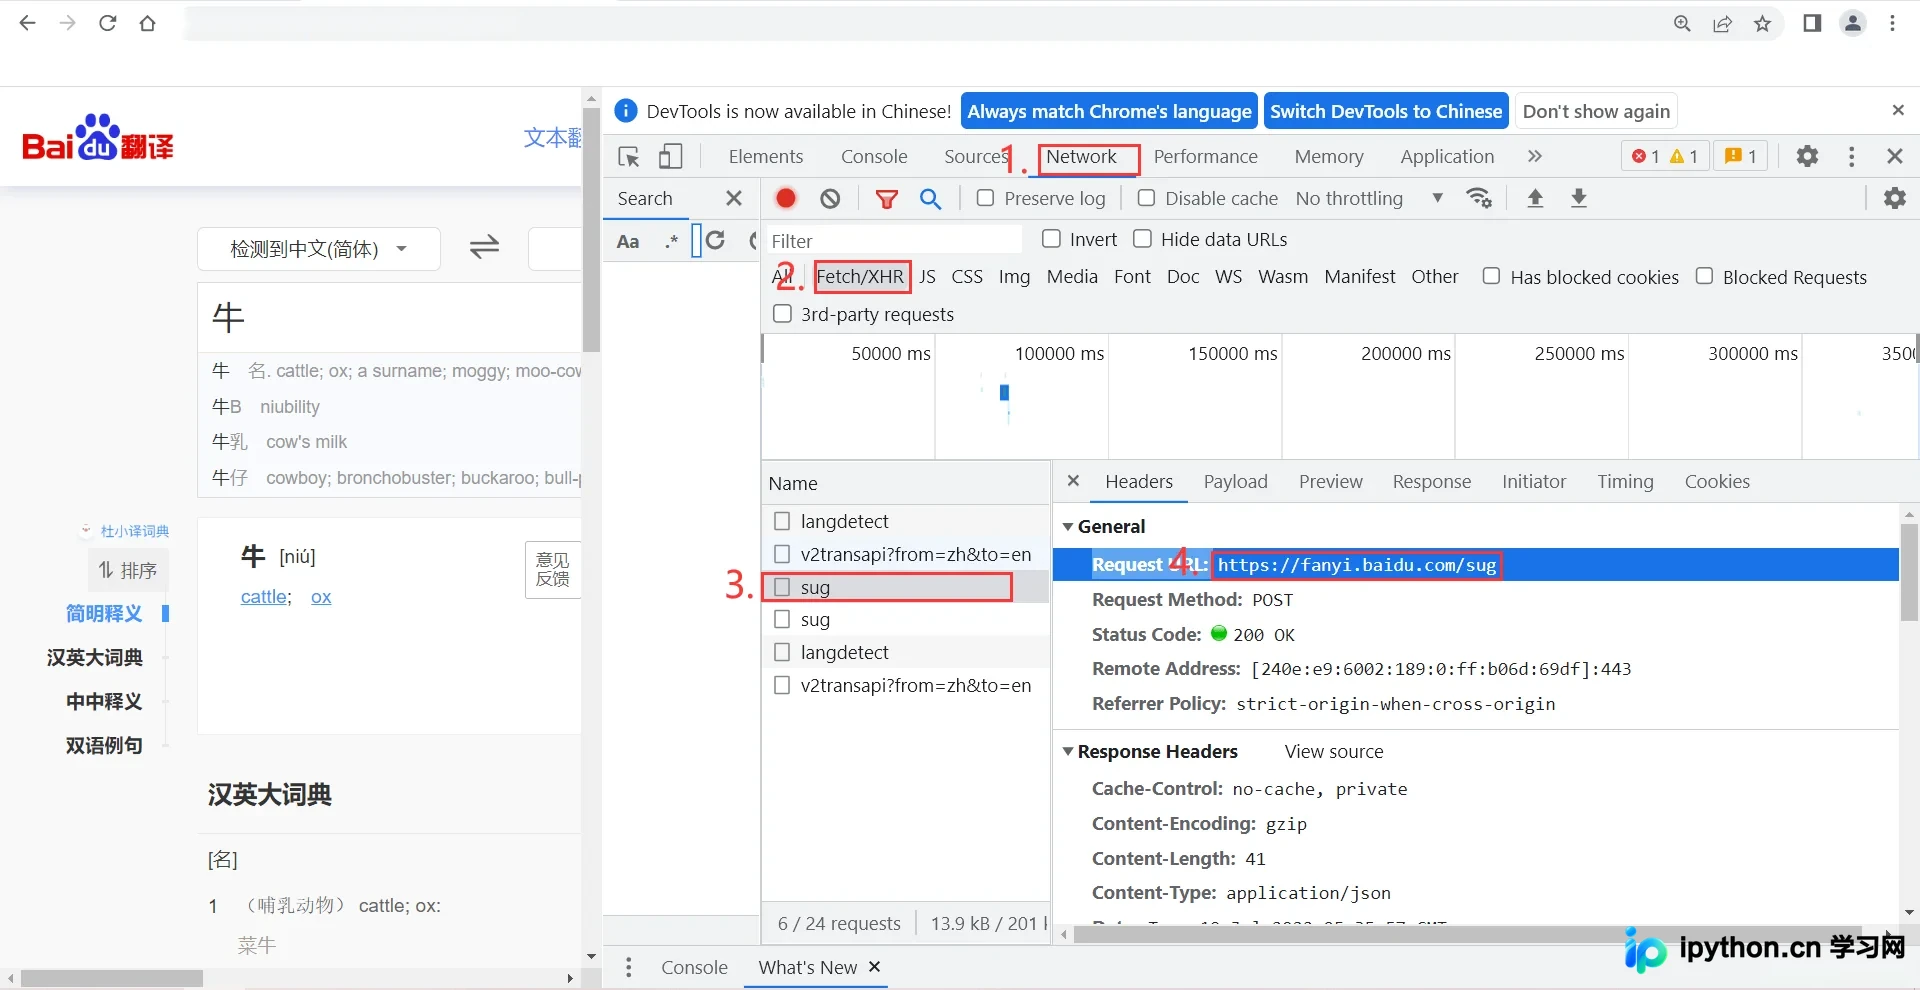
本文详细讲解如何利用Python的requests库对接百度翻译网页接口。通过F12开发者工具分析网络请求,获取SUG接口的URL、Headers及Data参数。文章提供了从导入库、构建请求到解析JSON响应数据的完整代码示例,并演示了如何将功能封装为函数以实现交互式翻译程序,适合Python初学者学习网络请求与数据处理。
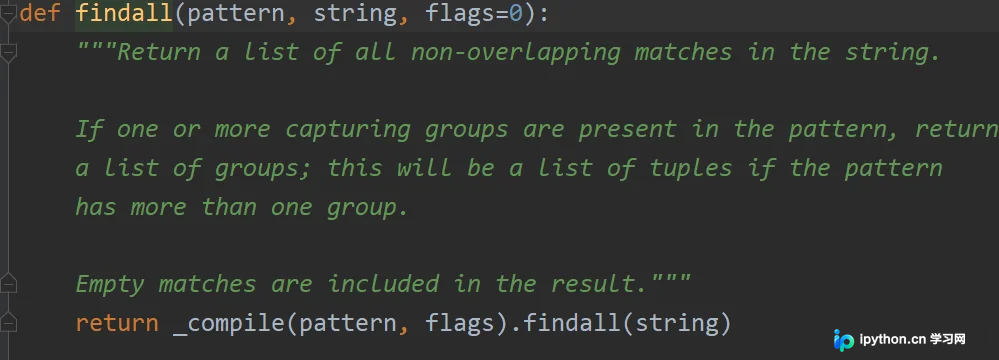
本文详细介绍Python中re模块的findall()函数用法。该函数用于在字符串中查找所有匹配正则表达式的子串,并返回包含所有匹配结果的列表。文章通过多个具体代码示例,演示了基础字符匹配、未找到结果的处理、复杂正则模式(如锚点、字符集、数字匹配及取反)的应用,以及结合requests库提取网页Title的实战场景。
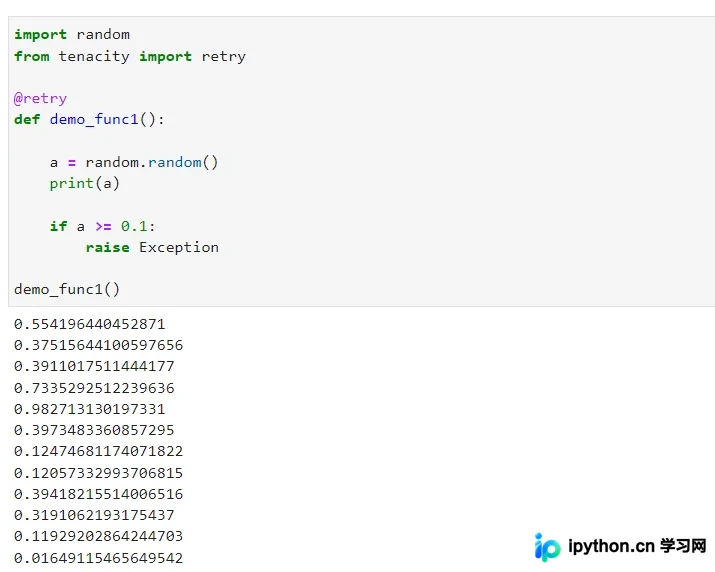
本文深入解析Python中强大的错误重试库tenacity。通过retry装饰器,实现自动重试逻辑。详解如何配置最大重试次数(stop_after_attempt)、超时限制(stop_after_delay)及组合条件。介绍wait_fixed和wait_random设置重试间隔,以及retry_if_exception_type和retry_if_result自定义重试触发条件,助力构建高可用程序。
本文详细介绍如何使用Python编写一个简单的爬虫程序,批量下载电脑壁纸。通过结合Requests进行HTTP请求、XPath解析HTML结构以及Pinyin库处理中文路径,实现从指定类型和页码中自动抓取高清壁纸。文章涵盖工具准备、核心代码逻辑解析及完整可运行代码,旨在提供技术交流参考,非商业用途。
本文详细介绍Python第三方库requests的基本用法,涵盖安装配置、GET与POST请求、参数传递、JSON解析、文件保存、代理设置、Cookie维持及异常处理等核心功能,帮助开发者快速掌握HTTP客户端操作。
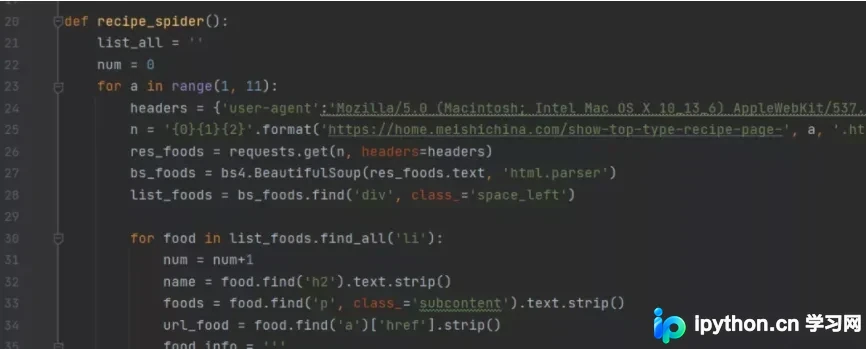
本文介绍如何利用Python实现自动发送周末菜谱提醒的功能。通过编写网络爬虫抓取网页美食信息,结合SMTP协议发送邮件,并配合schedule库设置定时任务。用户只需配置邮箱授权码及收件人,即可定期收到精心挑选的食谱推荐,帮助解决“今天吃什么”的日常难题。
本文深入解析Python多线程原理,并实战演示如何高效抓取英雄联盟英雄及皮肤图片。通过分析异步加载机制与API接口,结合多线程与队列技术,实现高并发数据下载与保存,提供完整代码模板供参考。
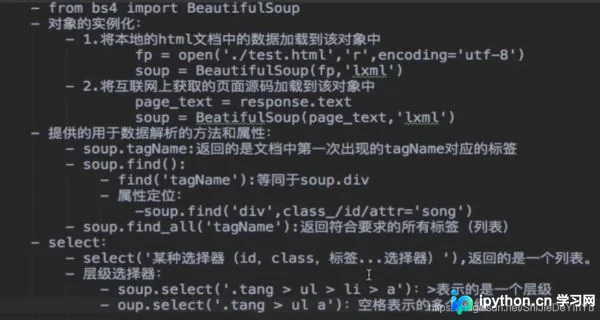
本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。