

Python调用百度翻译API实现网页抓取与数据解析

本文详细讲解如何利用Python的requests库对接百度翻译网页接口。通过F12开发者工具分析网络请求,获取SUG接口的URL、Headers及Data参数。文章提供了从导入库、构建请求到解析JSON响应数据的完整代码示例,并演示了如何将功能封装为函数以实现交互式翻译程序,适合Python初学者学习网络请求与数据处理。
一、分析网页
首先,在浏览器中打开百度翻译网站。按下F12键调出开发者工具,切换到Network(网络)标签页,并筛选Fetch/XHR请求。在翻译输入框中输入任意测试文本,观察网络请求列表,会发现一个名为sug的请求包。点击该请求,查看Headers、Payload、Preview和Response等选项卡。在Headers选项卡中,复制Request URL后的完整网址,该地址将作为后续代码中请求的URL。
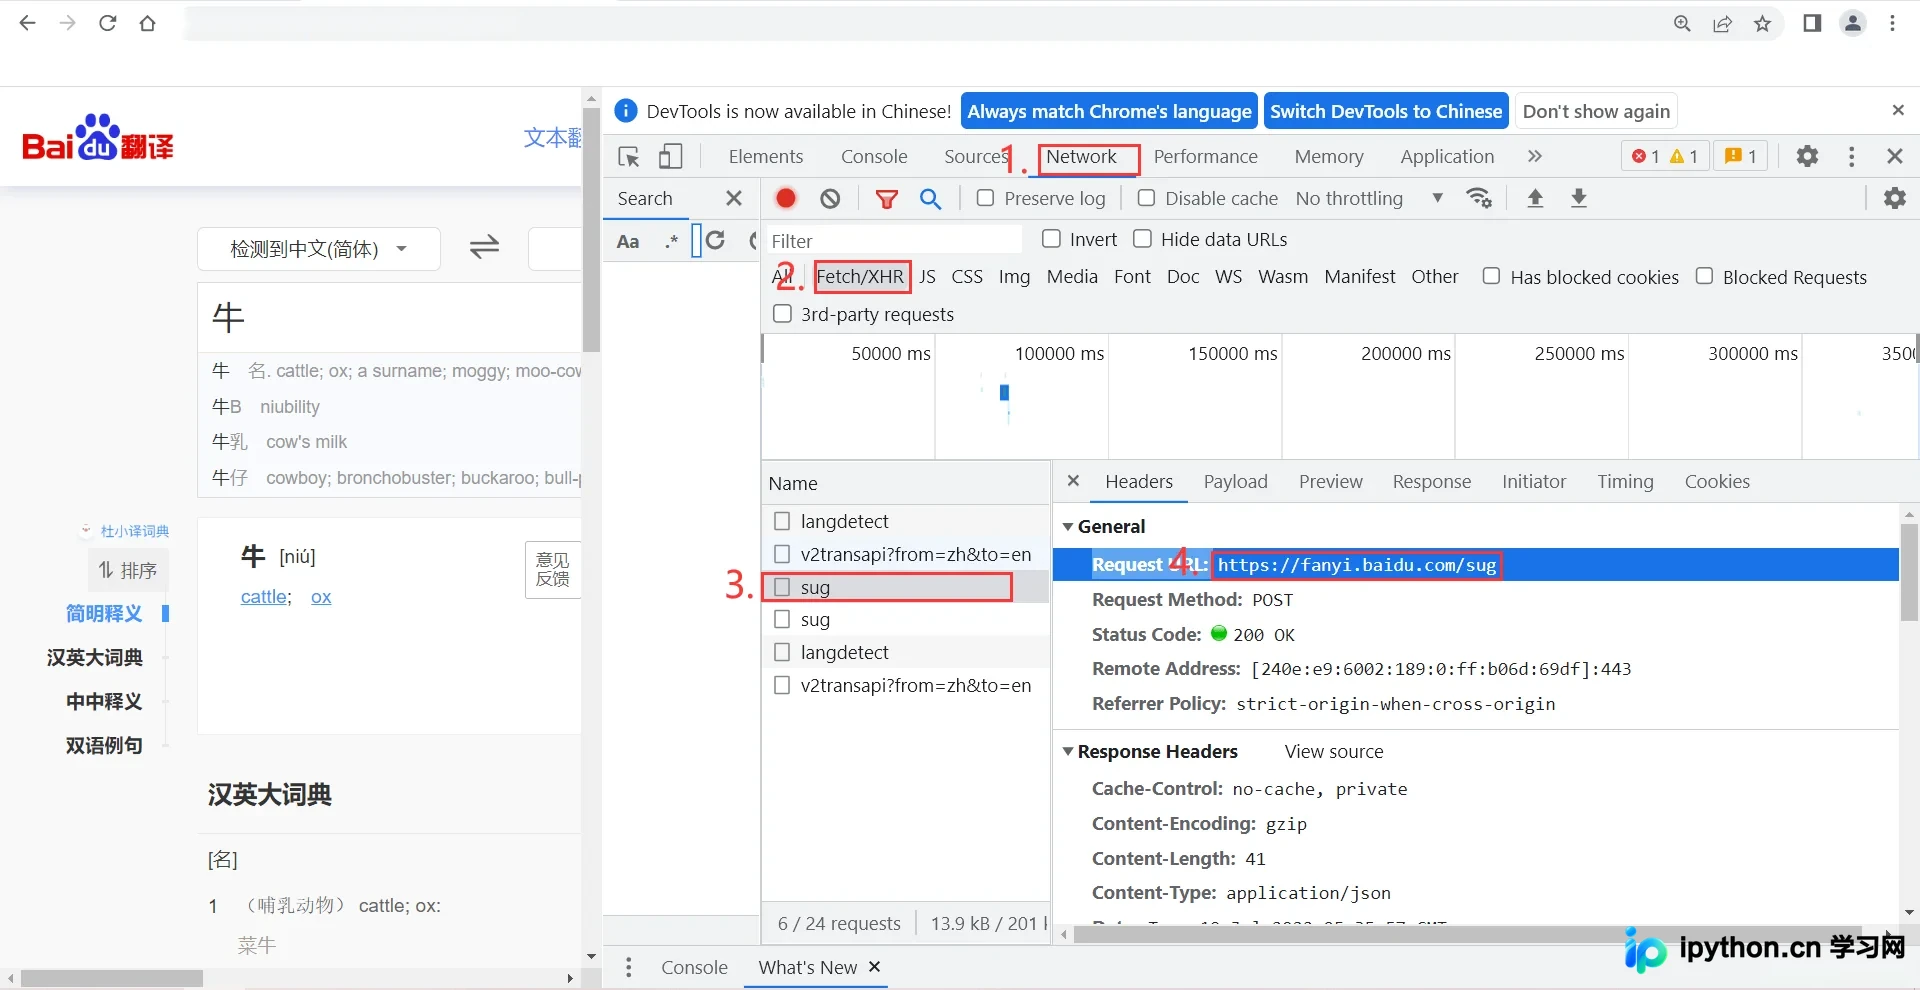
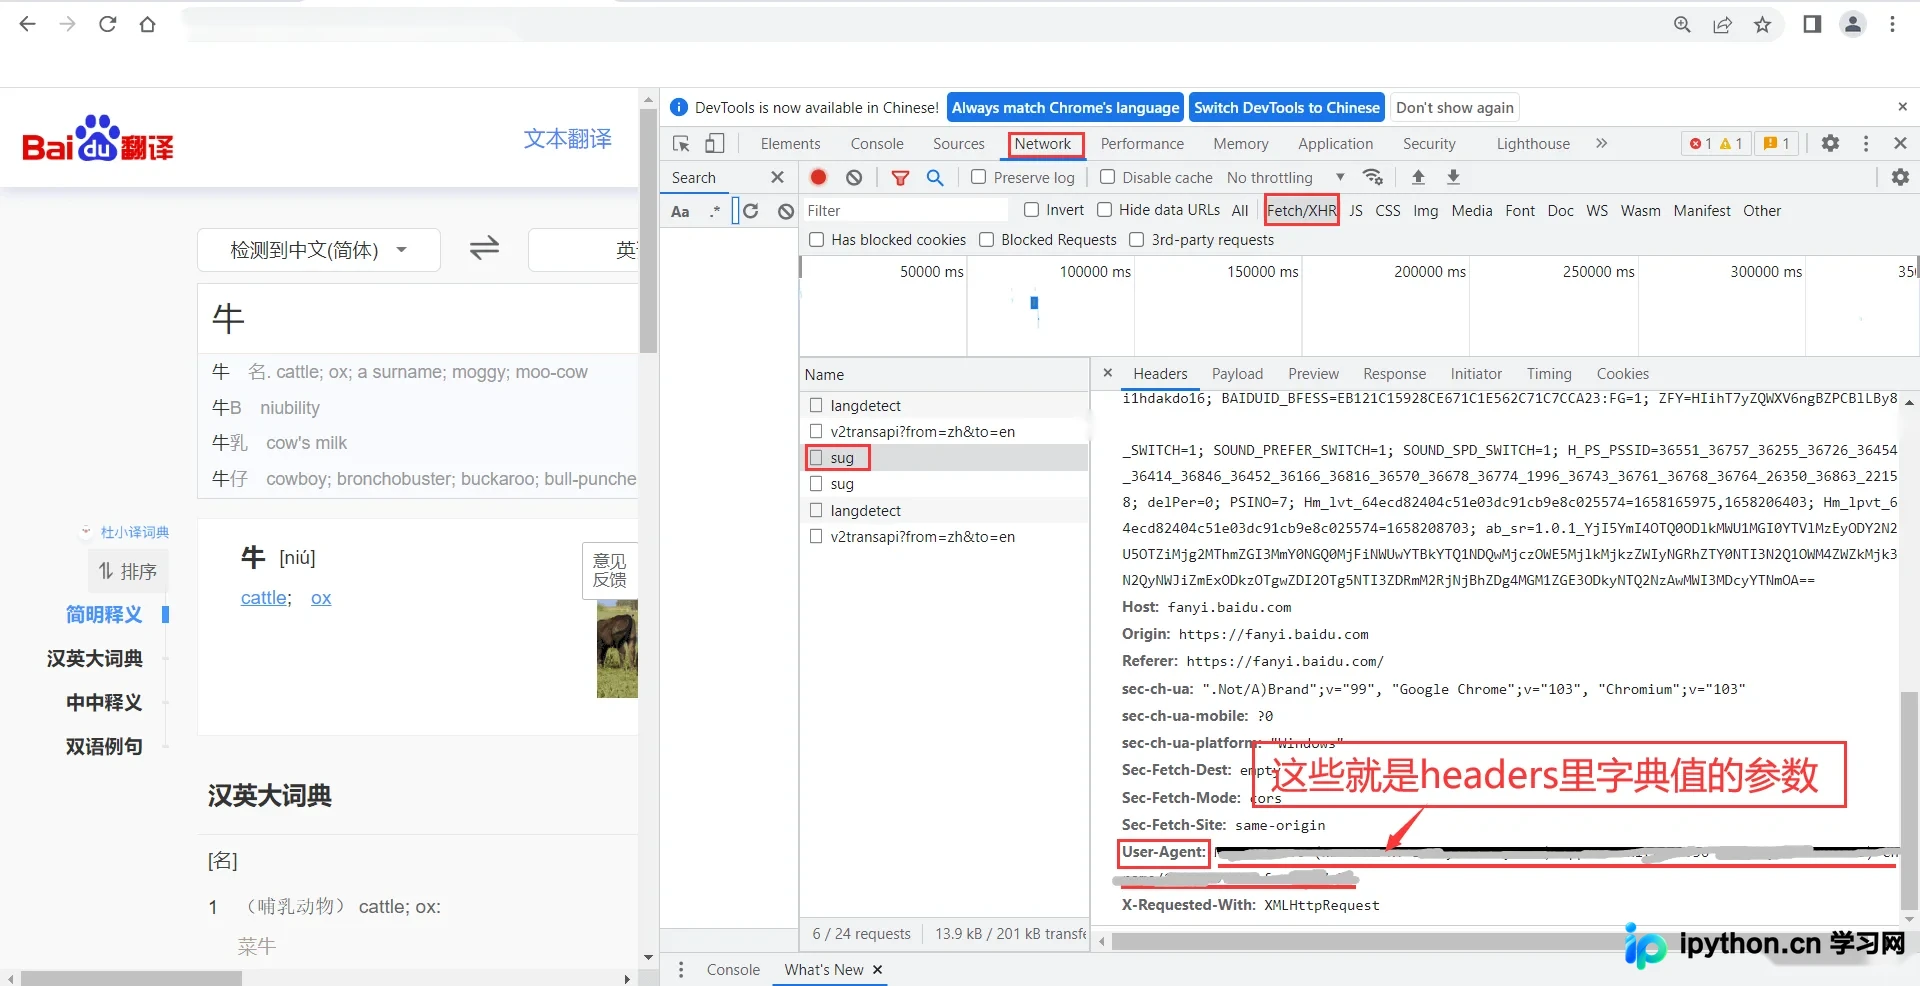
继续在Headers选项卡中滚动至底部,找到User-Agent字段,复制其后的参数值。该值将作为请求头(headers)的一部分,用于模拟浏览器访问。
切换到Payload选项卡,查看Form Data部分,这里包含键值对形式的参数。其中的“键”对应百度翻译的输入字段,而“值”则是用户输入的翻译内容。这部分数据将作为data参数传递,由于data以字典形式提交,因此该“键”(即kw)即为data参数中所需的键名。
完成上述参数的提取后,即可进入代码实现阶段。
二、使用步骤
1.导入库
代码如下(示例):
import requests
import json
2.键盘输入内容
代码如下(示例):
fan_yi = input("请输入要翻译的内容:") # 2.键盘输入翻译内容此处使用的url为网络请求的目标地址。
3.构建url/headers/data参数
headers参数可能因设备或浏览器不同而存在差异,建议根据前述网页分析步骤,获取自己电脑浏览器的具体参数并替换。
注意事项:headers参数必须为字典格式,其键和值均需为字符串类型。此外,User-Agent参数中的“U”和“A”字母必须严格大写,否则会导致请求报错。
代码如下(示例):
import requests     # 1.导入库
import json
fan_yi = input("请输入要翻译的内容:")    # 2.键盘输入翻译内容
url = "https://fanyi.baidu.com/sug"     # 3.写入url
headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) ""AppleWebKit/537.36 "}  # 4.构建headers
data = {"kw":fan_yi}    # 5.构建data
rsponse1 = requests.post(url = url,headers = headers,data = data)   # 6.发起请求
rsponse2 = rsponse1.text    # 获取响应数据
jie_xi = json.loads(rsponse2)   # 解析数据
print(jie_xi)   # 输出结果
4.发起请求响应数据
代码如下(示例):
rsponse1 = requests.post(url = url,headers = headers,data = data)   # 发起请求
rsponse2 = rsponse1.text    # 获取响应数据
5.解析数据输出结果
代码如下(示例):
jie_xi = json.loads(rsponse2)   # 解析数据
print(jie_xi)   # 输出结果
三、完整代码
注意事项:headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) ""AppleWebKit/537.36 "} 这一部分中的"Mozilla/5.0 (Windows NT 10.0; Win64; x64) ""AppleWebKit/537.36 "我已经删减所以直接复制过去运行会报错,因按照如下图找到自己电脑浏览器的User-Agent:后面的参数复制进代码修改才行。
重要的事情讲三遍!!!:headers参数是以字典的形式存在的,其键和值都是字符串格式,还有User-Agent参数中的U字母和A字母都必须是大写,如果粗心写错了是会报错的哟。
重要的事情讲三遍!!!:headers参数是以字典的形式存在的,其键和值都是字符串格式,还有User-Agent参数中的U字母和A字母都必须是大写,如果粗心写错了是会报错的哟。
重要的事情讲三遍!!!:headers参数是以字典的形式存在的,其键和值都是字符串格式,还有User-Agent参数中的U字母和A字母都必须是大写,如果粗心写错了是会报错的哟。
方法一:中规中矩写
代码如下(示例):
import requests     # 导入库
import json
fan_yi = input("请输入要翻译的内容:")    # 键盘输入翻译内容
url = "https://fanyi.baidu.com/sug"     # 写入url
# 构建headers
headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) ""AppleWebKit/537.36 "}
data = {"kw":fan_yi}    构建data
rsponse1 = requests.post(url = url,headers = headers,data = data)   # 发起请求
rsponse2 = rsponse1.text    # 获取响应数据
jie_xi = json.loads(rsponse2)   # 解析数据
print(jie_xi)   # 输出结果
方法二:将代码封装到函数里
def fangYi(data1):
    url = "https://fanyi.baidu.com/sug"
    headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64)
    data = {"kw":data1}
    rsponse1 = requests.post(url = url,headers = headers,data = data)
    rsponse2 = rsponse1.content.decode()
    json1 = json.loads(rsponse2)
    print(json1)
if __name__ == '__main__':
    while True:
        data1 = input("+++++请在下方输入要翻译的内容,退出请输入”no“+++++\n\t请输入要翻译的内容:")
        if data1 == "no":
            break
        else:
            fangYi(data1)
到此这篇关于python接入使用百度翻译流程的文章就介绍到这了,更多相关python百度翻译内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









