

Python3 下载网络图片的两种常用方法
本文介绍了在已获取图片链接的前提下,使用 Python3 下载网络图片的两种主要方式。第一种通过 urllib2 模块进行文件读写,第二种利用 urllib.request 中的 urlretrieve 方法。文章提供了相应的代码示例,帮助开发者快速实现图片下载功能。
2026-10-13
6

本文介绍了在已获取图片链接的前提下,使用 Python3 下载网络图片的两种主要方式。第一种通过 urllib2 模块进行文件读写,第二种利用 urllib.request 中的 urlretrieve 方法。文章提供了相应的代码示例,帮助开发者快速实现图片下载功能。
本文详细介绍如何在Python中使用Requests库配置Socks5代理,以解决网络爬虫中因频繁访问导致的IP封禁问题。通过安装支持socks的requests版本,并正确设置代理地址协议(http/https),可轻松实现代理连接。
本文提供基于Python的微信爬虫完整代码示例,分别演示单线程与多线程两种实现方式。通过urllib库抓取网页内容并保存为HTML文件,多线程版本引入Queue和Thread模块提升效率。代码包含User-Agent设置、代理预留接口及异常处理,适合Python初学者参考学习并发编程与网络爬虫基础。
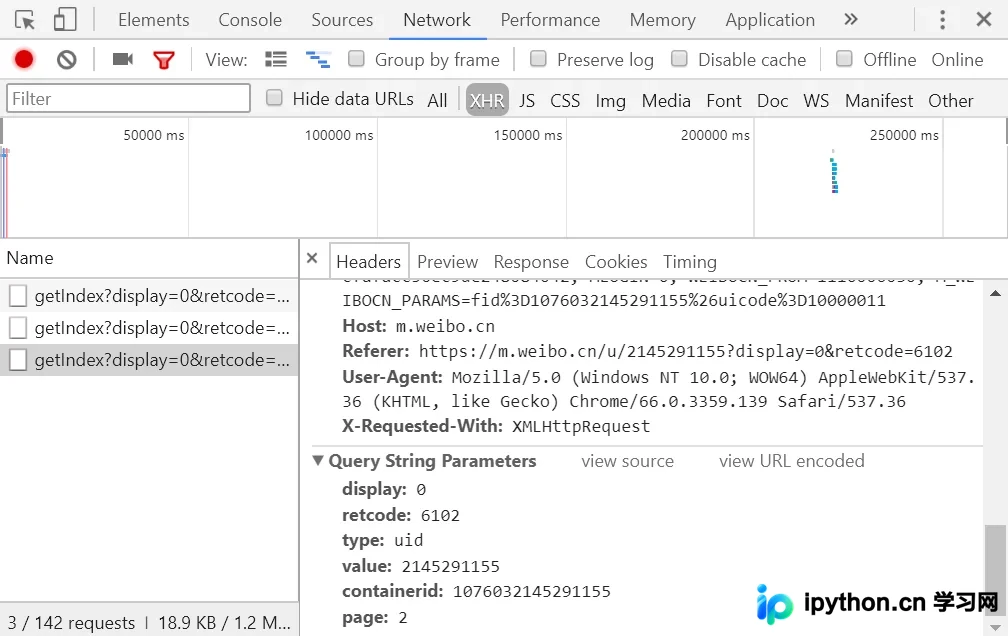
本文通过Python代码演示如何抓取马云的微博内容。首先利用浏览器开发者工具分析Ajax请求,识别GET请求中的关键参数及分页机制。接着解析返回的JSON数据,提取cardlistInfo中的总数量及cards中的微博正文、点赞、评论和转发数。最后结合Requests与PyQuery库,实现批量获取并保存微博信息至本地文件。
本文介绍如何使用Python实现桌面壁纸的自动切换功能。通过requests库从指定网站抓取图片URL并下载,结合win32api和win32gui模块修改Windows注册表及调用SystemParametersInfo接口,实现定期自动更换壁纸。代码包含完整的抓取、下载及设置流程,适合希望自定义桌面环境的用户参考。
本文详细介绍Python库urllib3的核心特性,包括线程安全、连接池管理、SSL/TLS验证及代理支持。通过具体代码示例,演示如何使用urllib3发起GET/POST请求、处理JSON数据、上传文件、设置超时与重试机制,并解决HTTPS证书验证警告问题,帮助开发者高效构建网络请求应用。
本文介绍使用Python爬取个性签名的具体代码实现。通过tkinter构建图形界面,结合requests和re库获取网页数据,并处理编码转换问题,最终生成并展示个性签名图片。
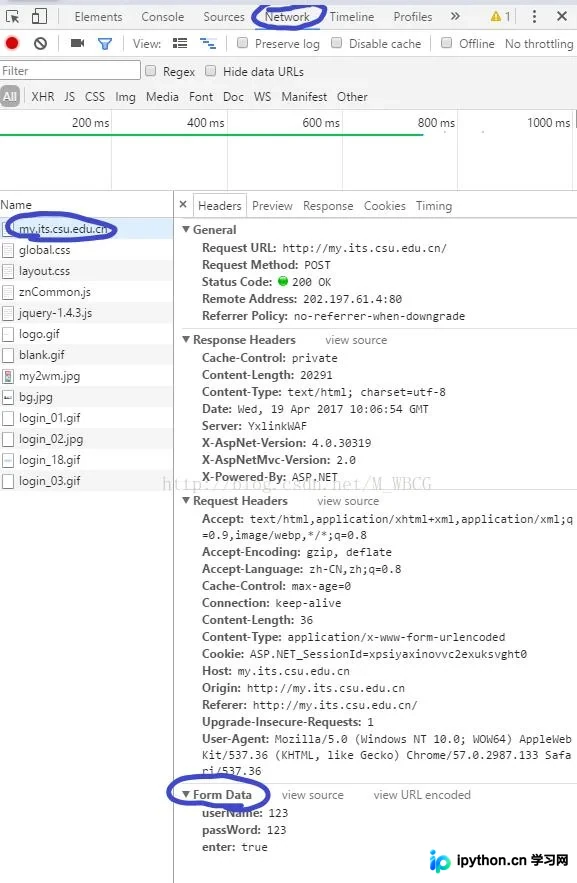
本文详解利用Python进行网站模拟登录的完整流程。通过开发者工具分析Network请求,提取登录所需的隐藏参数,并使用requests库建立Session以维持状态。文章展示了如何获取HTML源码、正则提取数据、提交POST请求以及获取登录后页面内容,提供基础代码参考。
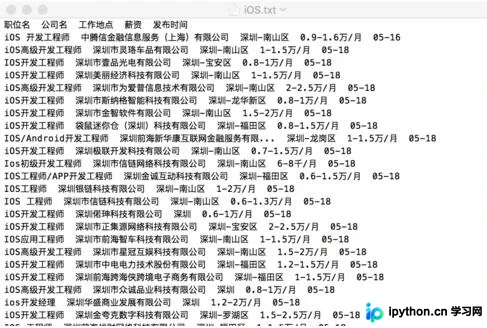
本文分享一个基于Python 2.7编写的简单网络爬虫Demo,旨在帮助初学者理解网页数据抓取流程。代码通过BeautifulSoup解析51job网站,提取职位名、公司、薪资及发布时间等关键信息,并演示了如何将数据写入MySQL数据库。文中包含完整代码及抓取结果展示,适合入门学习参考。
本文介绍如何在Python3中利用requests库结合IP代理池实现随机IP生成。通过从预设代理列表随机选择IP,配置请求头信息,并访问测试网站验证当前IP。该方法适用于需要隐藏真实IP或进行网络爬虫开发的场景,代码简洁实用,可直接参考使用。
本文介绍Python网络爬虫的三种常见网页抓取方法:正则表达式、Beautiful Soup和Lxml。重点对比了各模块的性能与适用场景,指出Lxml因基于C语言实现而兼具速度与健壮性。文章提供了Lxml及其依赖模块cssselect的详细安装命令,并附带完整的Python代码示例,演示如何利用urllib和lxml下载网页、解析HTML并批量保存图片。
本文介绍如何使用Python的requests库进行数据抓取。通过对比Java等语言,突出Python在集成工具库方面的便捷性。详细讲解了设置请求参数、Headers、代理以及处理不同响应格式(文本、JSON、二进制)的具体代码示例,帮助开发者快速上手网络爬虫开发。