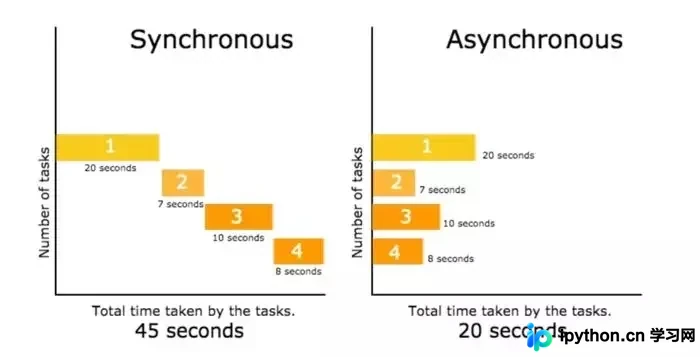
Python爬虫实战:同步与异步对比及gevent异步编程详解
本文详解Python爬虫中同步与异步的区别,对比requests与aiohttp库的使用。重点介绍gevent库通过Greenlet实现轻量级协程的原理,以及利用猴子补丁将阻塞式requests转换为异步的方法。包含有道词典爬取实战、高并发下的限流策略及列表分批处理代码示例,帮助开发者提升爬虫效率。
2026-10-13
6

本文详解Python爬虫中同步与异步的区别,对比requests与aiohttp库的使用。重点介绍gevent库通过Greenlet实现轻量级协程的原理,以及利用猴子补丁将阻塞式requests转换为异步的方法。包含有道词典爬取实战、高并发下的限流策略及列表分批处理代码示例,帮助开发者提升爬虫效率。
本文深入解析Python构建网页爬虫的核心原理,涵盖从单线程基础实现到分布式系统扩展的关键环节。重点讨论抓取频率控制、URL去重策略(如布隆过滤器)、HTML解析挑战及性能瓶颈优化,为系统设计面试提供完整解决方案。
本文详细解析Python2与Python3中urllib库的模块合并与API变更,重点介绍Python3环境下urllib.request的核心功能。内容涵盖发送GET/POST请求、处理URL参数与中文编码、定制请求头以规避403错误、下载远程资源、配置代理IP以及Cookie会话维持和异常处理机制,为网络爬虫开发提供完整参考。
本文针对Python爬虫突然报错Http 800 Internal internet error的问题,分析原因为目标网站启用了反爬虫程序。通过对比修改前后的代码,演示如何为urllib.request.Request对象添加User-Agent头部信息,伪装成浏览器请求以绕过限制,恢复爬虫正常运行。
本文介绍如何利用Python编写网络爬虫程序,自动抓取万维网上的电商售卖信息。通过示例代码展示如何使用Requests发起HTTP请求,并结合BeautifulSoup解析HTML页面结构,提取商品标题、价格、发布时间及地区等关键字段。该示例以58同城电脑售卖信息为对象,演示了URL列表获取与详情页数据提取的基本流程,旨在帮助开发者掌握基础的数据爬取技巧。
本文介绍如何在Python的requests库中通过proxies参数配置HTTP和HTTPS代理。通过示例代码展示具体用法,并提供使用chinaz.com网站验证代理是否生效的方法。同时附带解决乱码和添加cookies的参考链接,帮助开发者顺利处理网络请求中的代理配置问题。
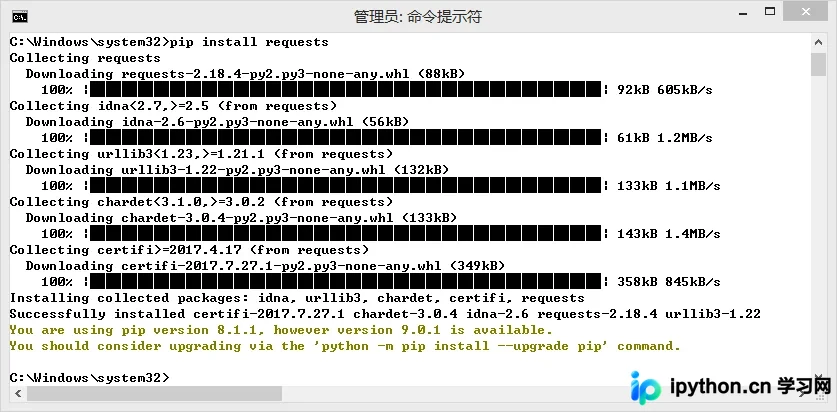
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
本文详细介绍 Python 实现网站模拟登录的两种方法。重点在于获取表单提交地址并携带 Cookie 进行 POST 数据提交。通过普通脚本方式与面向对象封装两种方式,演示如何利用 urllib 和 http.cookiejar 模块完成身份验证及后续页面访问,帮助开发者掌握抓取需登录权限网页的核心技术。
本文介绍如何使用Python编写工具扫描并获取可用的代理IP。通过解析西刺代理网站结构,利用requests和BeautifulSoup提取IP、端口及协议信息,并结合多线程与队列机制提高抓取效率。随后通过请求特定网站验证代理有效性,最终将可用代理保存至文件,适用于需要大量代理资源的爬虫场景。
本文提供基于Python的手机号归属地查询示例,通过读取包含手机号码的文本文件,利用urllib获取网页源码,并结合正则表达式解析归属地、运营商、区号及邮编等关键信息,最终将结果写入日志文件。
本文系统讲解Python函数的基础知识,涵盖内置函数库(字符串、数学、网络、OS)的使用方法,详细演示httplib2第三方库在Windows下的安装步骤及网页爬虫示例,并深入解析自定义函数的定义、返回值处理及参数预设规则,帮助初学者掌握Python编程核心技能。
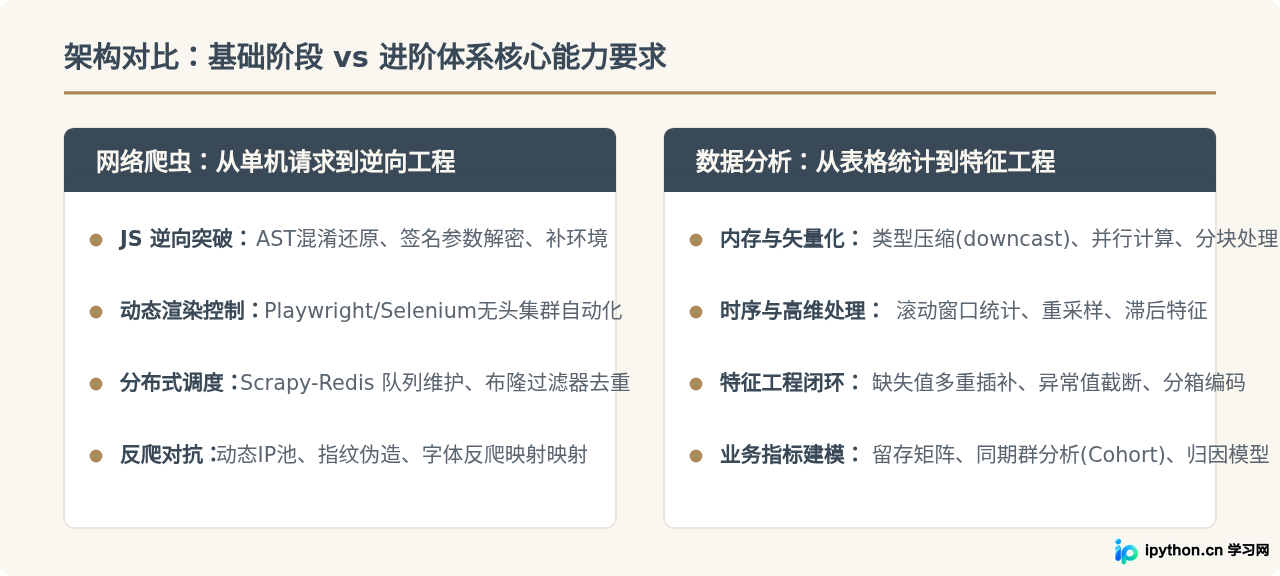
针对Python进阶学习者,提供高质量数据分析与网络爬虫百度网盘课程与配套资源的筛选标准、核心内容构成、实操获取与验证方法,帮助读者避开失效与低质资料。