Celery在Python爬虫中实现定时任务的完整流程
本文详解如何在Python爬虫中使用Celery实现定时任务。通过配置Celery Worker与Beat服务,解决爬虫增量抓取及防止Cookie过期等需求。文章涵盖tasks.py配置、Worker重启及Beat启动命令,提供从代码编写到服务运行的完整操作指南,帮助开发者自动化数据获取流程。
2026-10-14
6

本文详解如何在Python爬虫中使用Celery实现定时任务。通过配置Celery Worker与Beat服务,解决爬虫增量抓取及防止Cookie过期等需求。文章涵盖tasks.py配置、Worker重启及Beat启动命令,提供从代码编写到服务运行的完整操作指南,帮助开发者自动化数据获取流程。
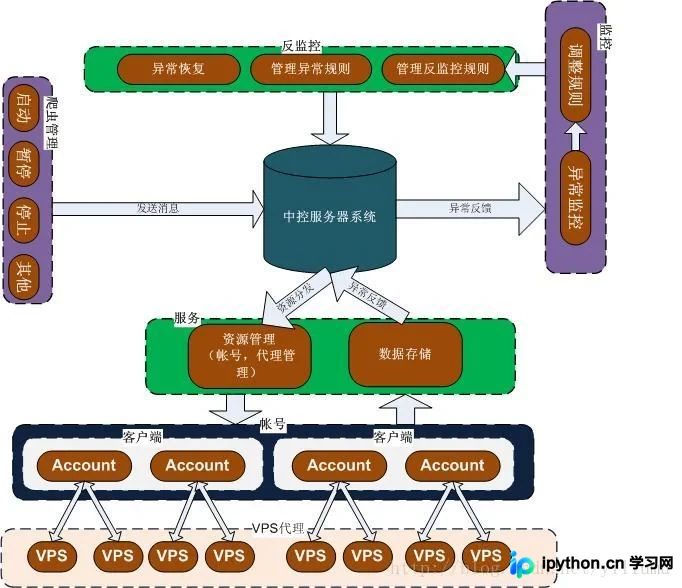
本文详解Python分布式爬虫的实现方法,重点介绍如何利用Celery将抓取任务分发至多台服务器。通过配置不同的Worker队列(如login_queue、user_crawler等),实现登录、用户信息、粉丝关注等任务的隔离与并行处理,提升数据采集效率。
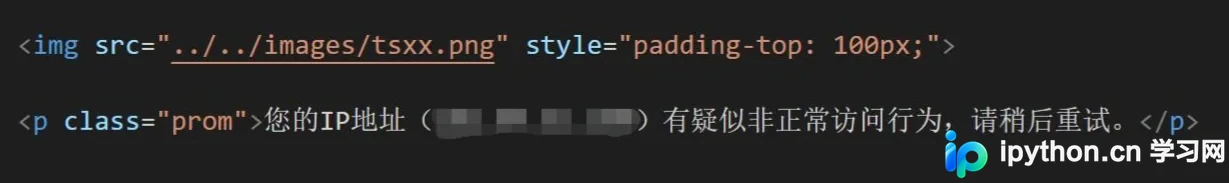
本文梳理Python爬虫应对网站反爬措施的实用方法。针对基于知道创宇等安全服务的IP频率限制,通过构造包含User-Agent和Cookie的消息头模拟浏览器行为,利用随机延时(2-5秒)降低请求频率,并结合代理IP池规避IP封禁。旨在帮助开发者建立系统的反爬应对框架,确保数据获取的稳定性与合规性。
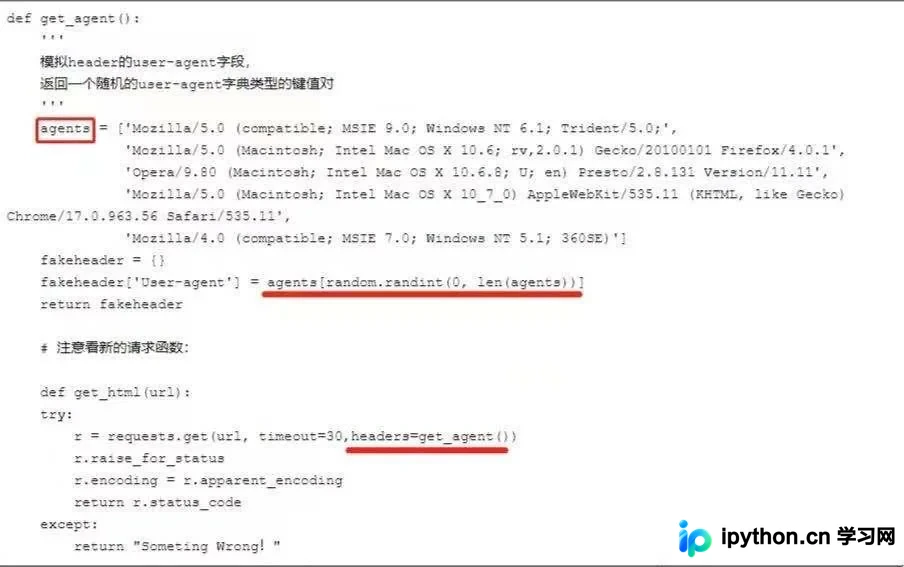
本文深入分析Python爬虫中两种主流反反爬策略:User-Agent伪装与IP代理池。通过对比两者在技术实现、成本及稳定性上的差异,指出UA易被伪造但成本低,而代理池虽能绕过IP限制却面临质量参差不齐的挑战。文章旨在帮助开发者根据实际场景选择最优方案,平衡抓取效率与合规性。
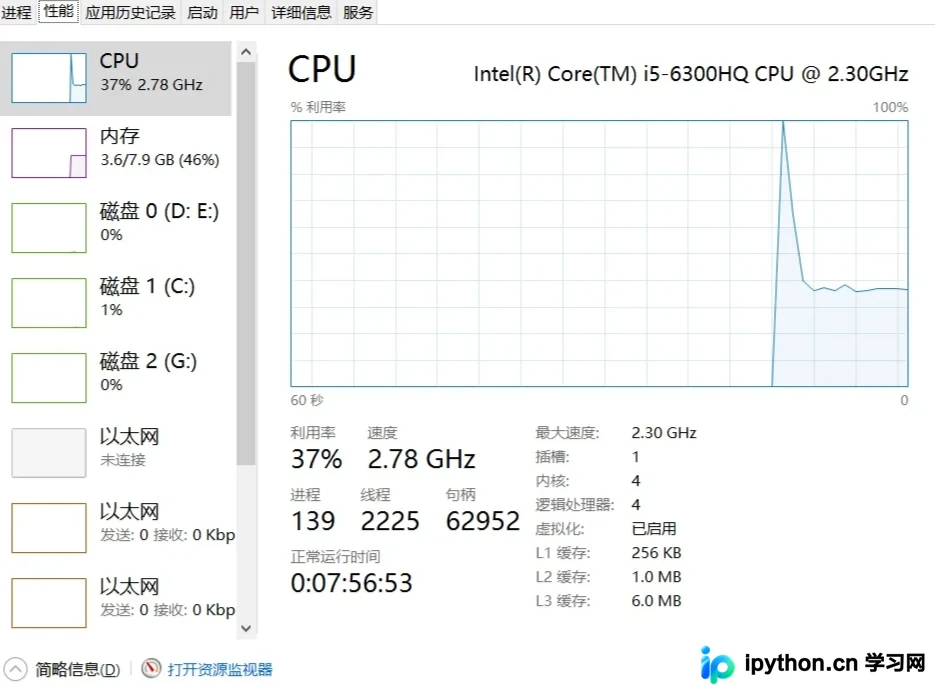
本文深入解析Python3爬虫开发中GIL(全局解释器锁)对多线程性能的制约。通过对比多线程与多进程在4核CPU下的资源占用情况,揭示Python多线程无法利用多核的底层原因,并展示如何利用多进程实现CPU 100%利用率,为高并发爬虫场景提供优化思路。
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。
本文详解Python中requests库模拟登录的三种方式。首先区分Cookie与Session机制,随后介绍直接使用抓包Cookie、通过字典参数传递Cookie以及利用Session对象保持会话状态的方法。文章涵盖代码示例与注意事项,帮助开发者高效实现网页数据抓取与自动化请求。
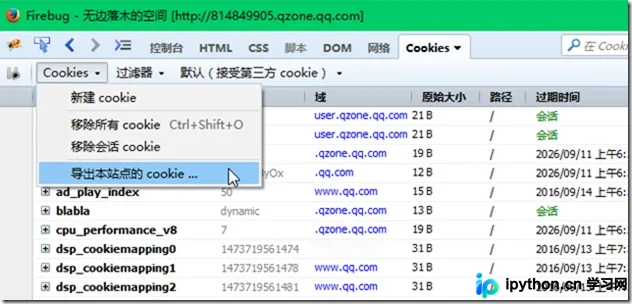
本文详解Python爬虫中Cookie的正确使用方法,解决需登录页面抓取难题。通过Firefox浏览器导出Netscape格式Cookie文件,修正格式错误后配合MozillaCookieJar实现自动登录模拟。文章还提供动态获取Cookie及Header注入两种进阶方案,帮助开发者高效绕过验证码与登录限制。
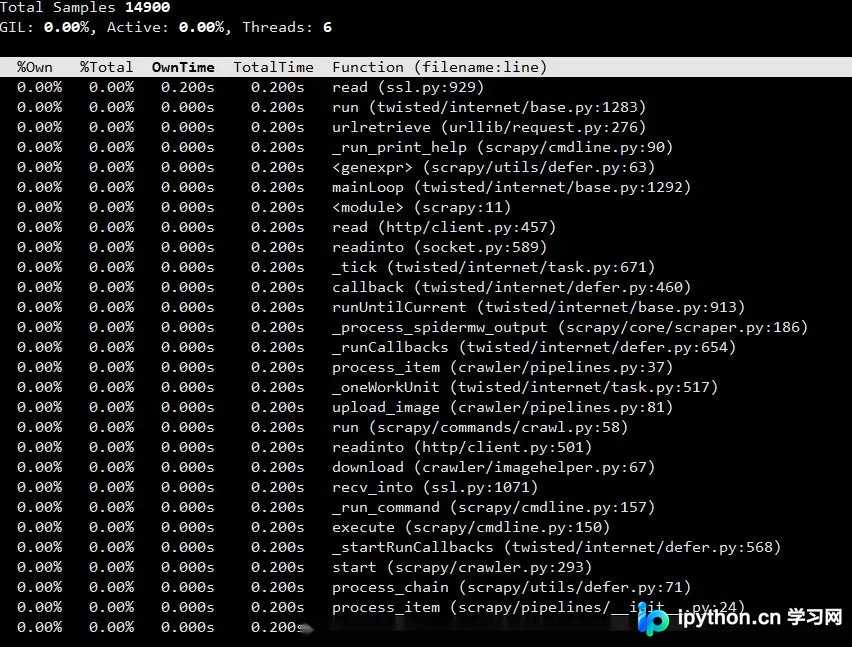
本文介绍如何使用py-spy工具排查Scrapy爬虫因网络IO导致的进程卡死问题。通过定位耗时函数发现urllib.urlretrieve缺乏超时参数,进而封装支持timeout的urlopen方法,有效解决爬虫进程堆积和数据延迟问题。
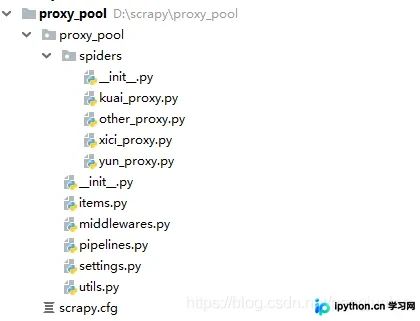
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
本文详细记录了使用Charles工具抓取微信小程序数据并配合Python进行解析的全过程。内容涵盖Windows与iPhone的网络环境配置、Charles代理安装、SSL证书在电脑及iOS设备上的正确部署方法,以及针对证书信任失败、网络不通等常见问题的排查方案。通过获取接口URL及参数,可直接利用Python爬虫获取JSON数据,为移动端小程序数据分析提供有效技术手段。
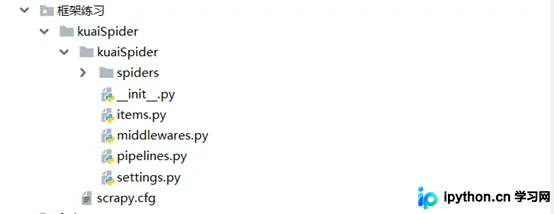
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。