

Python爬虫应对反爬机制的常见策略与实施要点

发布时间:2026-10-14| 6人浏览过
本文梳理Python爬虫应对网站反爬措施的实用方法。针对基于知道创宇等安全服务的IP频率限制,通过构造包含User-Agent和Cookie的消息头模拟浏览器行为,利用随机延时(2-5秒)降低请求频率,并结合代理IP池规避IP封禁。旨在帮助开发者建立系统的反爬应对框架,确保数据获取的稳定性与合规性。
反爬虫应对策略概述
登山路径各异,难度随之不同。近期在讲解数据获取时,已陆续涉及Header、IP地址等要素。在大家基本掌握具体爬取流程的基础上,本文旨在系统梳理应对反爬虫的策略,通过回顾与查漏补缺,构建完整的爬虫知识体系。
首先需分析目标网站性质。以信息查询系统为例,获取特定Case页面通常依赖于Case ID或Name字段进行搜索。理解这一逻辑是后续绕过限制的基础。
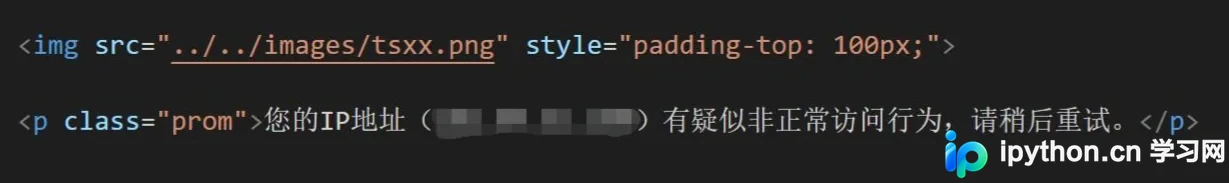
出于安全考量,部分网站会部署反爬机制,如验证User-Agent和Cookies,或检测IP在短时间内的高频访问。例如,使用知道创宇安全服务的网站在频繁访问时会提示“IP行为异常”,从而触发限制。
浏览器本质上也是应用程序。只要IP未被封禁,既然浏览器可以正常访问,理论上通过程序模拟请求也应可行。关键在于如何模拟浏览器的行为特征。
常见绕过反爬措施详解
常见的绕过反爬虫措施主要包括以下几种:
- 构造消息头:将User-Agent和Cookies包含在请求头中,模拟真实浏览器的标识,以通过基础的身份验证。
- 延长请求间隔:快速频繁的请求会占用大量服务器资源,易被安全系统检测并封禁IP。建议设置随机延时(如2至5秒)再发送下一次请求,以降低被识别的风险。
- 使用代理IP:通过更换IP地址解决单一IP因高频访问被检测或封禁的问题,确保请求的持续性。
上述仅为常用方法的简述,其他绕过反爬虫的技术细节可参考往期文章。
本文介绍了Python中应对反爬虫的几种核心方法。如需了解更多相关技巧,建议查阅本站历史文章或关注后续更新。感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









