

Python爬虫实战:利用Firefox导出Cookie绕过登录验证

本文详解Python爬虫中Cookie的正确使用方法,解决需登录页面抓取难题。通过Firefox浏览器导出Netscape格式Cookie文件,修正格式错误后配合MozillaCookieJar实现自动登录模拟。文章还提供动态获取Cookie及Header注入两种进阶方案,帮助开发者高效绕过验证码与登录限制。
Python爬虫Cookie使用原理与Firefox导出方法
在网页抓取过程中,许多有价值的数据(如知乎回答、QQ空间好友列表、微博关注列表等)通常要求用户先登录才能查看。直接编写爬虫进行登录抓取面临两大难点:复杂的网站登录规则以及验证码识别。为规避这些问题,可采用一种间接策略:先在浏览器中手动完成登录,从浏览器中提取登录后的身份凭证(即Cookie),然后在爬虫程序中加载该凭证,以模拟已登录用户的身份继续执行数据抓取任务。
本文将以Python语言结合Cookie技术,演示如何抓取QQ空间的好友列表。所需工具包括FireFox浏览器、FireBug插件以及Python环境。
获取Cookie
首先,在FireFox浏览器中登录QQ空间。接着启动FireBug插件,切换到Cookies页签。点击页签中的Cookies按钮菜单,选择“导出本站点的cookie”选项,即可完成Cookie数据的导出操作。
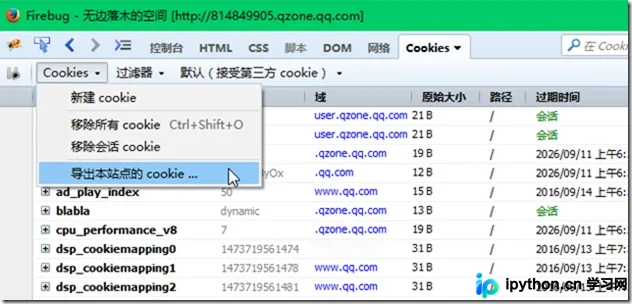
导出的Cookie数据将保存为一个名为cookies.txt的文本文件。
基于MozillaCookieJar的程序实现与格式修正
程序实现
接下来,我们需要利用获取到的Cookie创建一个opener对象,用以替换默认请求处理中的opener。将导出的cookies文件复制到程序所在目录,并编写如下Python脚本:
#!python
# encoding: utf-8
from http.cookiejar import MozillaCookieJar
from urllib.request import Request, build_opener, HTTPCookieProcessor

DEFAULT_HEADERS = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:43.0) Gecko/20100101 Firefox/43.0"}
DEFAULT_TIMEOUT = 360


def grab(url):
    cookie = MozillaCookieJar()
    cookie.load('cookies.txt', ignore_discard=True, ignore_expires=True)
    req = Request(url, headers=DEFAULT_HEADERS)
    opener = build_opener(HTTPCookieProcessor(cookie))
    response = opener.open(req, timeout=DEFAULT_TIMEOUT)
    print(response.read().decode('utf8'))


if __name__ == '__main__':
    grab(<a href="http://user.qzone.qq.com/QQ号/myhome/friends" rel="external nofollow" >http://user.qzone.qq.com/QQ号/myhome/friends</a>)
由于我们使用的是从FireFox浏览器导出的Cookie文件,因此在代码中必须使用MozillaCookieJar类来加载和处理Cookie。
运行上述脚本后,程序报错:
Traceback (most recent call last):
  File "D:/pythonDevelop/spider/use_cookie.py", line 17, in <module>
    start()
  File "D:/pythonDevelop/spider/use_cookie.py", line 9, in start
    cookie.load('cookies.txt', ignore_discard=True, ignore_expires=True)
  File "D:\Program Files\python\python35\lib\http\cookiejar.py", line 1781, in load
    self._really_load(f, filename, ignore_discard, ignore_expires)
  File "D:\Program Files\python\python35\lib\http\cookiejar.py", line 2004, in _really_load
    filename)
http.cookiejar.LoadError: 'cookies.txt' does not look like a Netscape format cookies file
错误原因在于cookies.txt文件的格式不符合Python解析器的预期,提示其不像标准的Netscape格式Cookie文件。解决方法很简单:只需在cookies.txt文件的第一行添加特定的头部声明即可。
# Netscape HTTP Cookie File添加该行内容后,Python的Cookie解析器便能识别这是适用于FireFox浏览器的Cookie格式文件。
再次运行脚本,依然报错,此处仅展示关键错误信息:
http.cookiejar.LoadError: invalid Netscape format cookies file 'cookies.txt': '.qzone.qq.com\tTRUE\t/\tFALSE\tblabla\tdynamic'错误提示表明Cookie文件中存在格式错误的行。要解决此问题,需先了解FireFox浏览器导出的Cookie格式规范。MozillaCookieJar要求每行Cookie数据由制表符分隔,并包含以下字段:
| 名称 | domain | domain_specified | path | secure | expires | name | value |
| 类型 | 字符串 | 布尔型 | 字符串 | 布尔型 | 长整型 | 字符串 | 字符串 |
| 说明 | 域名 | — | 适用路径 | 是否使用安全协议 | 过期时间 | 名称 | 值 |
关于其中domain_specified字段的含义,此处暂不深究,后续若明确再行补充。观察我们导出的Cookie文件部分行内容如下:
user.qzone.qq.com	FALSE	/	FALSE	814849905_todaycount	0
user.qzone.qq.com	FALSE	/	FALSE	814849905_totalcount	0
.qzone.qq.com	TRUE	/	FALSE	1473955201	Loading	Yes
.qzone.qq.com	TRUE	/	FALSE	1789265237	QZ_FE_WEBP_SUPPORT	0
对比可见,前两行格式错误,缺失了“expires”(过期时间)属性;后两行格式正确。解决办法是手动补全缺失的expires属性。可以从其他正确的Cookie行中复制一个时间戳值,填入错误行的对应位置即可修复。
补全Cookie格式后再次执行脚本,程序运行正常且未报错。但控制台并未打印出预期的好友信息,原因是请求的URL地址有误。通过FireBug可以定位到正确的请求地址:
https://h5.qzone.qq.com/proxy/domain/r.qzone.qq.com/cgi-bin/tfriend/friend_ship_manager.cgi?uin=QQ号&do=1&rd=0.44948123599838985&fupdate=1&clean=0&g_tk=515169388使用该正确地址后,成功抓取到好友列表数据。返回的好友列表数据为一个JSON字符串。
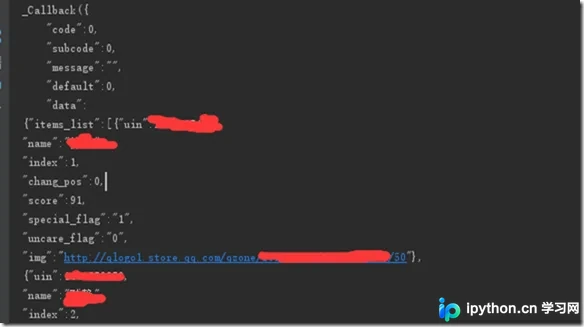
关于如何解析该JSON数据,将在后续章节中详细说明。
动态获取Cookie与请求头注入方案
动态获取Cookie
需要注意的是,Cookie具有有效期。若需长期进行网页抓取,必须定期更新Cookie。若每次都依赖从FireFox浏览器手动导出,效率较低。实际上,从浏览器获取的Cookie仅作为初始入口,后续请求应依靠Python程序主动获取并更新Cookie。以下代码演示了如何动态获取Cookie:
#!python
# encoding: utf-8
from http.cookiejar import CookieJar
from urllib.request import Request, HTTPCookieProcessor, build_opener

DEFAULT_HEADERS = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:43.0) Gecko/20100101 Firefox/43.0"}
DEFAULT_TIMEOUT = 360


def get(url):
    cookie = CookieJar()
    handler = HTTPCookieProcessor(cookie)
    opener = build_opener(handler)
    req = Request(url, headers=DEFAULT_HEADERS)
    response = opener.open(req, timeout=DEFAULT_TIMEOUT)
    for item in cookie:
        print(item.name + " = " + item.value)
    response.close()
示例程序展示了如何获取Cookie,并打印其name和value属性。通过实例可见,每次执行HTTP请求时,程序都会重新获取最新的Cookie。因此,我们可以优化程序逻辑:在第一次请求时使用从浏览器手动获取的Cookie,而在后续的每次请求中,直接使用上一次请求时程序自动获取的Cookie。调整后的程序代码如下:
#!python
# encoding: utf-8
from http.cookiejar import MozillaCookieJar, CookieJar
from urllib.request import Request, build_opener, HTTPCookieProcessor, urlopen

DEFAULT_HEADERS = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:43.0) Gecko/20100101 Firefox/43.0"}
DEFAULT_TIMEOUT = 360


def gen_login_cookie():
    cookie = MozillaCookieJar()
    cookie.load('cookies.txt', ignore_discard=True, ignore_expires=True)
    return cookie


def grab(cookie, url):
    req = Request(url, headers=DEFAULT_HEADERS)
    opener = build_opener(HTTPCookieProcessor(cookie))
    response = opener.open(req, timeout=DEFAULT_TIMEOUT)
    print(response.read().decode("utf8"))
    response.close()


def start(url1, url2):
    cookie = gen_login_cookie()
    grab(cookie, url1)
    grab(cookie, url2)


if __name__ == '__main__':
    u1 = "https://user.qzone.qq.com/QQ号/myhome/friends"
    u2 = "https://h5.qzone.qq.com/proxy/domain/r.qzone.qq.com/cgi-bin/tfriend/friend_ship_manager.cgi?uin=QQ号&do=2&rd=0.44948123599838985&fupdate=1&clean=0&g_tk=515169388"
    start(u1, u2)
至此,基本流程结束。
其他
在登录QQ空间时,使用Cookie还有另一种替代方案:通过观察网络请求,可以直接在HTTP请求头中添加Cookie信息。
获取请求头中Cookie的方法如下:打开FireFox浏览器,激活FireBug的network页签,在浏览器中登录QQ空间。在FireBug的网络请求列表中,找到登录页面的请求,即可查看该请求头中包含的Cookie信息。
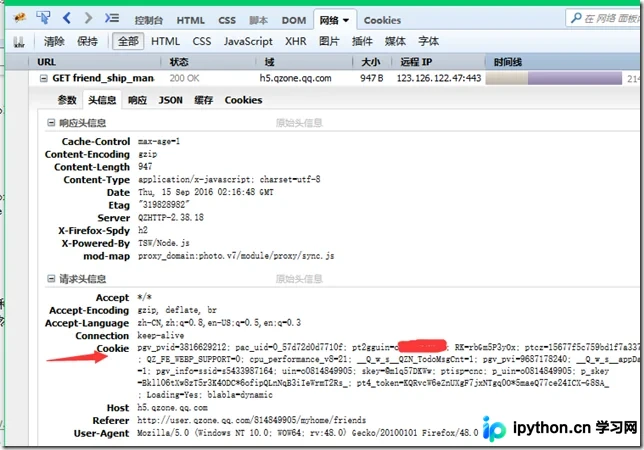
将获取到的Cookie信息整理为单行字符串,并添加到HTTP请求头中,即可直接访问受保护页面。这种方法相对简单,省去了修改Cookie文件的步骤。
此外,有博客文章提供了直接登录QQ空间的方案,这被视为目前已知较优的方法。只要腾讯不更改登录规则,该方法即可简单地执行请求并获取Cookie。不过,由于该方案年代较久,其适用性可能随平台规则变更而改变。
以上即为Python爬虫正确使用Cookie的详细内容,更多关于Python爬虫使用Cookie的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









