Python多线程爬取西刺代理的完整实现与格式转换
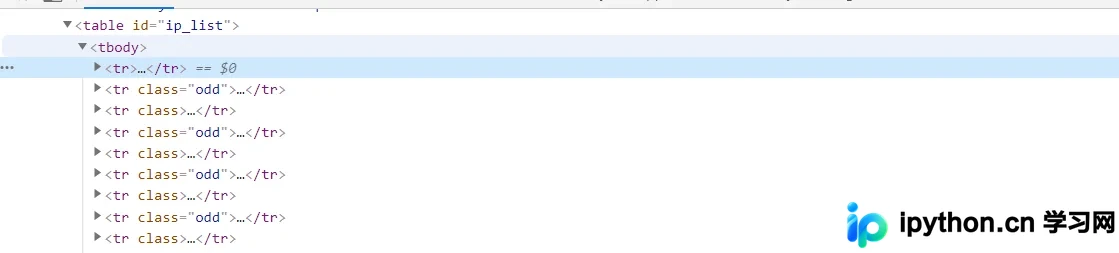
本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
2026-10-14
6

本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
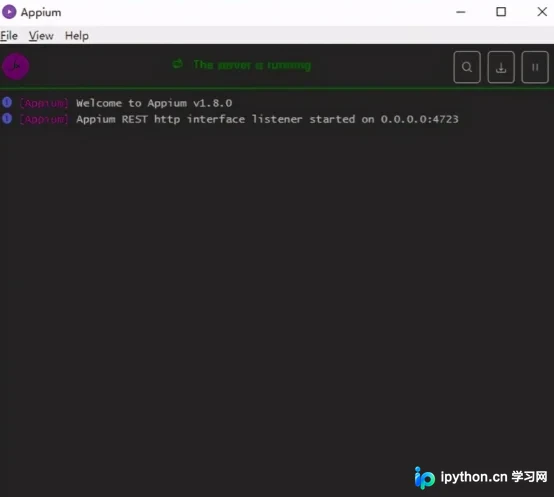
本文详细解析如何利用Python结合mitmproxy进行流量抓包,以及使用Appium模拟Android手机操作来抓取抖音视频。通过启动Appium服务、创建Session驱动抖音App,并配合Python脚本处理请求,实现视频文件的自动下载与保存。
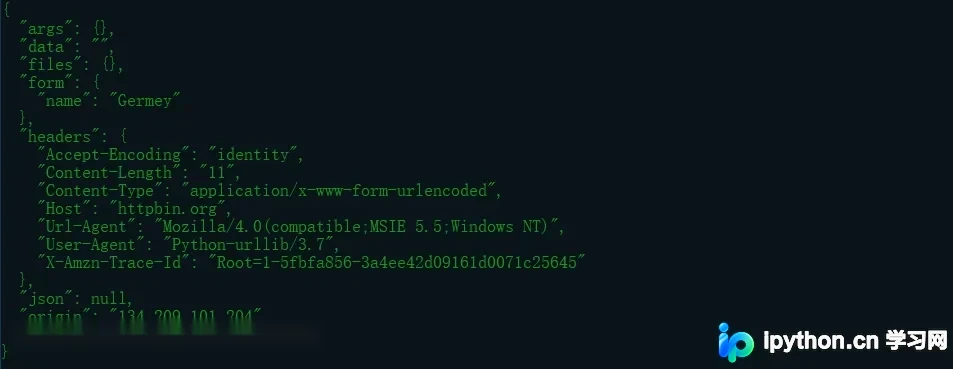
本文深入解析Python标准库urllib.request模块。详细讲解Request类的构造参数与数据编码,阐述Handler与Opener的协作机制。通过身份验证、代理配置及Cookie持久化(Mozilla与LWP格式)的完整代码示例,展示如何灵活构建HTTP请求处理器,适用于Python网络编程与爬虫开发场景。
本文详解在Python爬虫中获取指定class样式的div标签的三种方法。对比字符串查找与正则表达式的局限性,重点介绍BeautifulSoup库的使用技巧。通过字典形式赋值attrs参数解决官方文档示例无效的问题,并提供完整代码示例及图片下载实战,帮助开发者高效准确提取网页数据。
本文介绍当Selenium的.text方法无法直接获取Script标签内的JSON数据时,如何结合BeautifulSoup提取源码,并通过json模块将字符串转换为字典对象,从而精准获取嵌套数据。
本文详解Python Selenium中关闭浏览器的两种方法:close()用于关闭当前窗口,quit()用于关闭所有窗口并释放驱动。通过代码示例展示如何在多窗口场景下遍历句柄并逐一关闭,帮助开发者正确管理浏览器资源。
本文详解Python Selenium中处理JavaScript三种弹窗(Alert、Confirm、Prompt)的方法。通过switch_to.alert定位弹窗,利用text获取内容,accept()确认,dismiss()取消,以及send_keys()输入文本。结合百度设置实例,展示完整操作流程与代码实现。
本文详解Python Selenium中多窗口切换的核心方法。通过current_window_handle获取当前句柄,利用window_handles获取所有窗口列表,并结合switch_to.window()实现窗口切换。文章提供完整代码示例,演示从百度首页跳转至注册页后的窗口切换与标题打印逻辑,帮助开发者解决新窗口操作难题。
本文详细解析Python Selenium中ActionChains类的鼠标操作方法,涵盖右键点击、悬停、双击及拖拽等常用功能。通过百度和菜鸟教程的实战代码示例,演示如何定位元素并执行鼠标动作,特别针对iframe嵌套页面提供了切换框架的处理方案,帮助开发者掌握自动化测试中的复杂交互技巧。
本文详细讲解如何使用Python爬虫获取百度指数数据。针对百度指数接口变更的情况,提供了包含请求头设置、Cookie处理及数据解密逻辑的完整代码示例。通过解析API返回的加密数据,实现关键词搜索量的获取,适用于数据分析及股票趋势观察等场景。
本文整理Python爬虫开发中常见的数据采集问题,重点讲解如何通过cookielib模块携带Cookie实现模拟登录以获取受限数据,以及如何处理网站GBK与数据库UTF-8编码不一致导致的乱码问题。通过具体代码示例,提供实用的解决思路与操作代码,帮助开发者避开常见陷阱,提升爬虫稳定性。
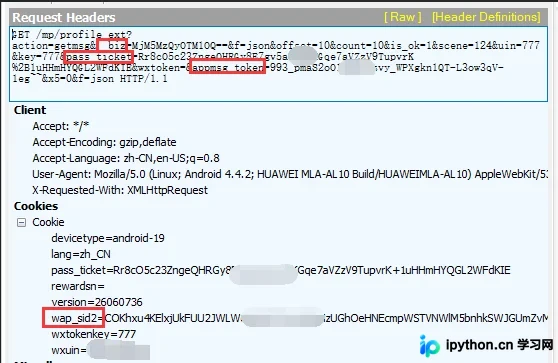
本文介绍利用Python模拟安卓微信App操作,通过抓包获取__biz、appmsg_token等关键参数,进而构造HTTP请求直接调用API接口,实现指定公众号历史文章数据的批量采集。