从零开始写Python爬虫:HTTP协议基础与请求头构造详解
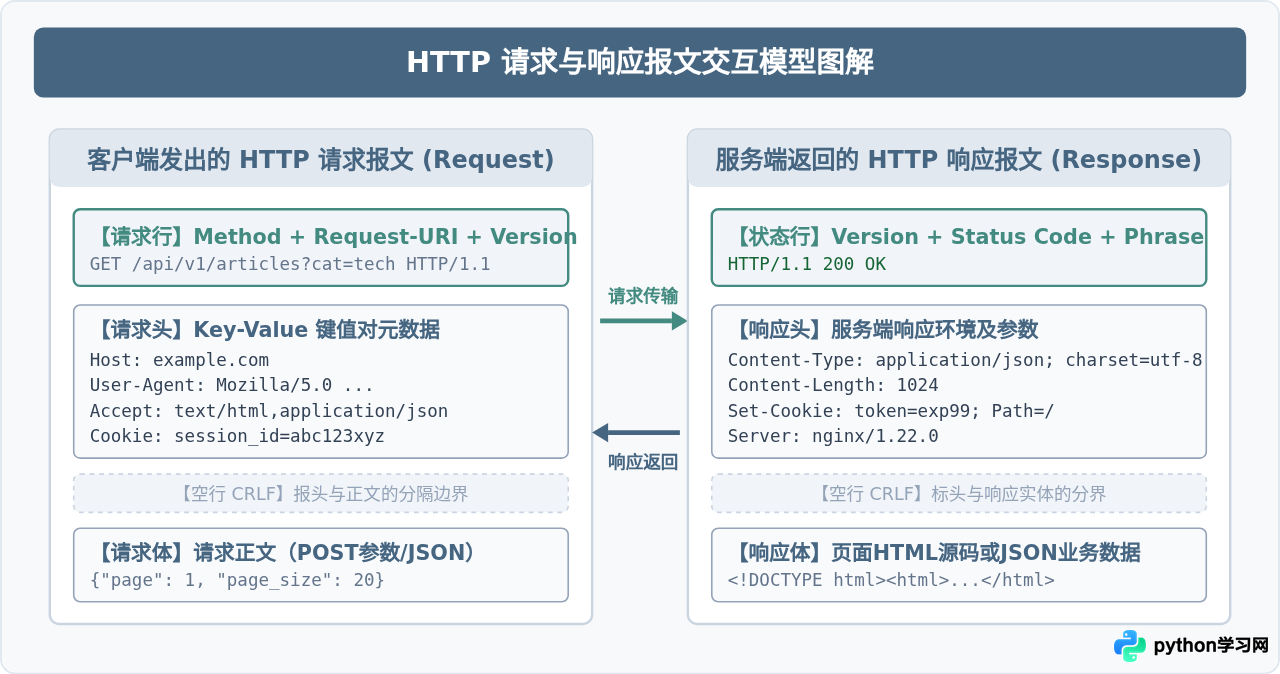
系统讲解从零编写Python网络爬虫的核心前提:HTTP协议通信原理、请求报文结构、核心请求头字段含义与反爬原理,并提供urllib与requests请求头构造实战代码。
2026-10-22
41


系统讲解从零编写Python网络爬虫的核心前提:HTTP协议通信原理、请求报文结构、核心请求头字段含义与反爬原理,并提供urllib与requests请求头构造实战代码。
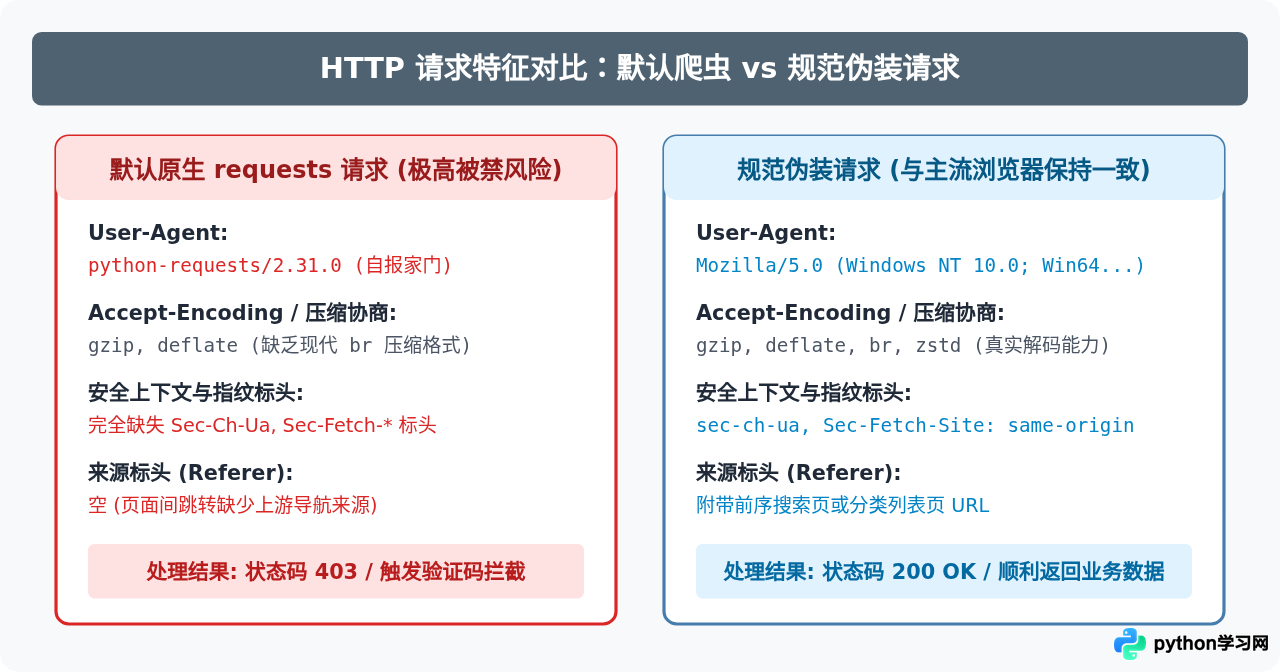
深入讲解Python爬虫频繁遭遇403或拦截时的排查与解决方法,包含完整HTTP请求头伪装技术、requests.Session会话保持与Cookie全生命周期管理实战。
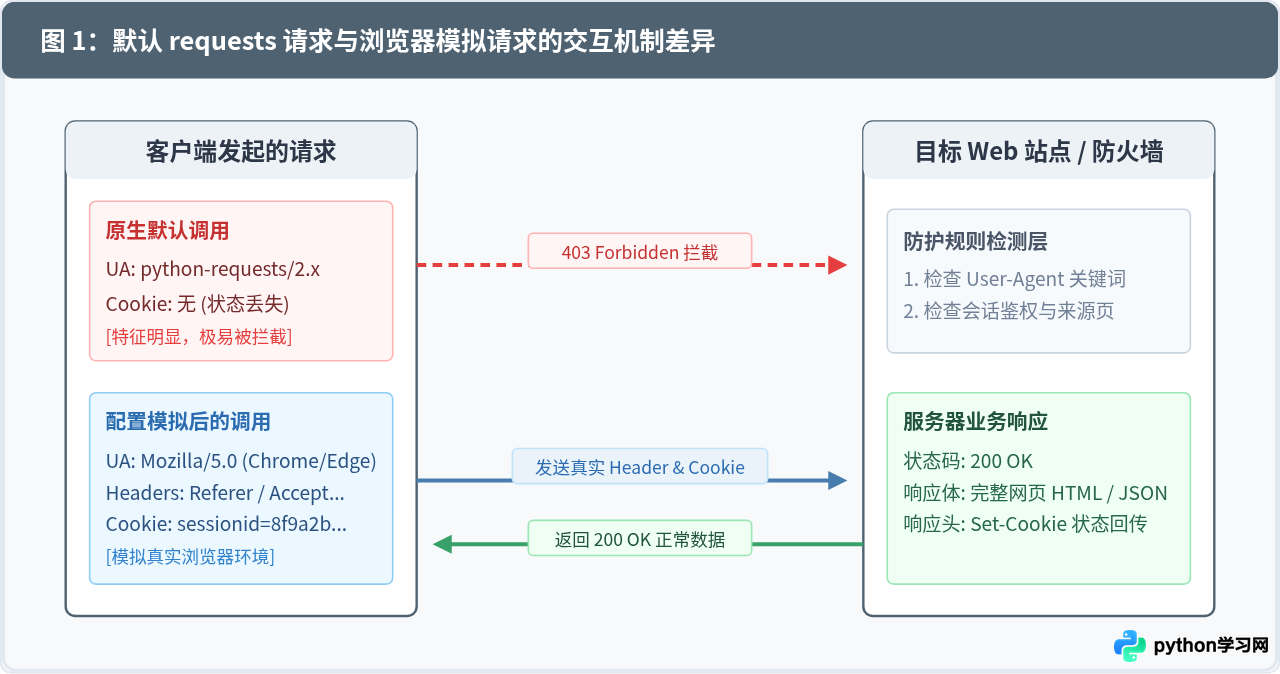
本教程详细讲解如何使用Python requests库模拟真实浏览器发送HTTP请求,包括Headers请求头配置、Cookies参数传递、Session状态保持及浏览器DevTools抓包提取技巧。
详细讲解在Python中使用urllib与requests下载图片时遭遇HTTP 403 Forbidden错误的根本原因,手把手教你如何正确配置User-Agent请求头,以及遭遇图片防盗链Referer、Token鉴权时的深度排查方法。
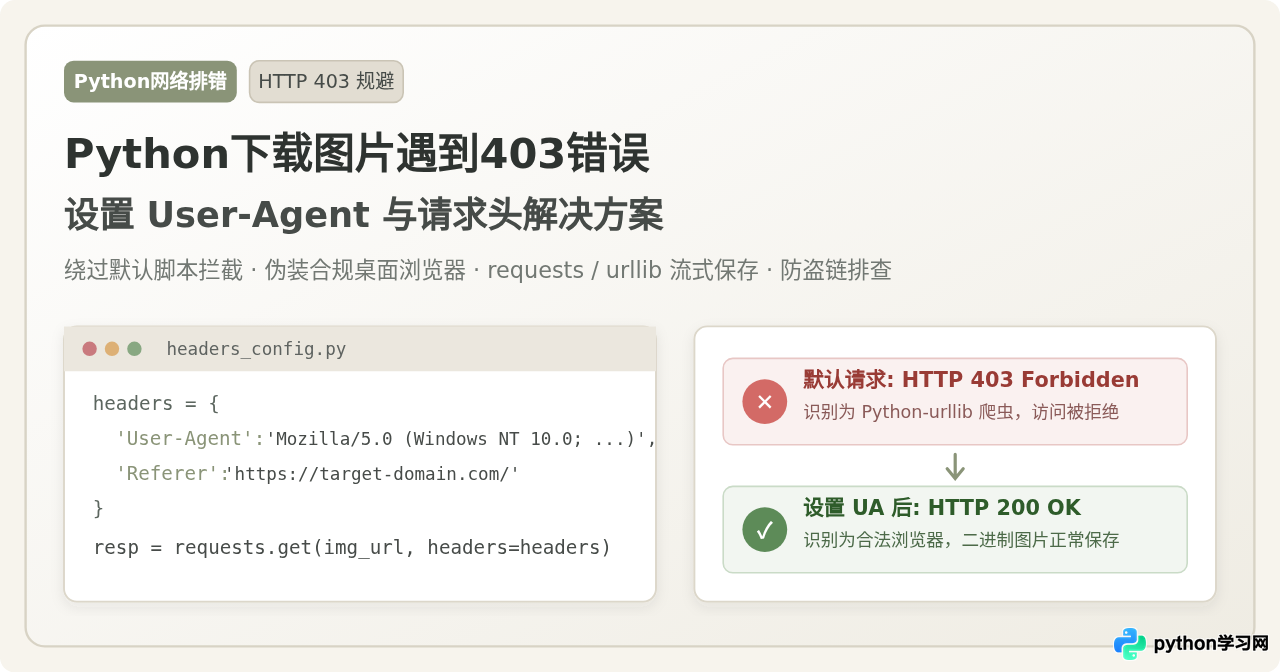
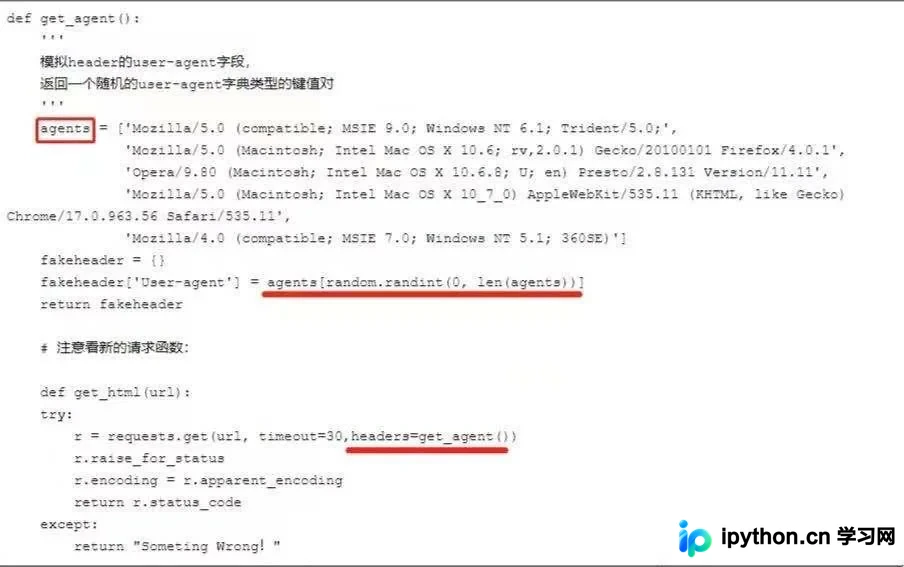
本文介绍如何利用Python的requests库通过伪装浏览器User-Agent来绕过网站的反爬机制。通过模拟真实浏览器的请求头(如Accept、Connection等),并随机切换User-Agent,可以有效防止IP被封禁,提高爬虫的稳定性和成功率。
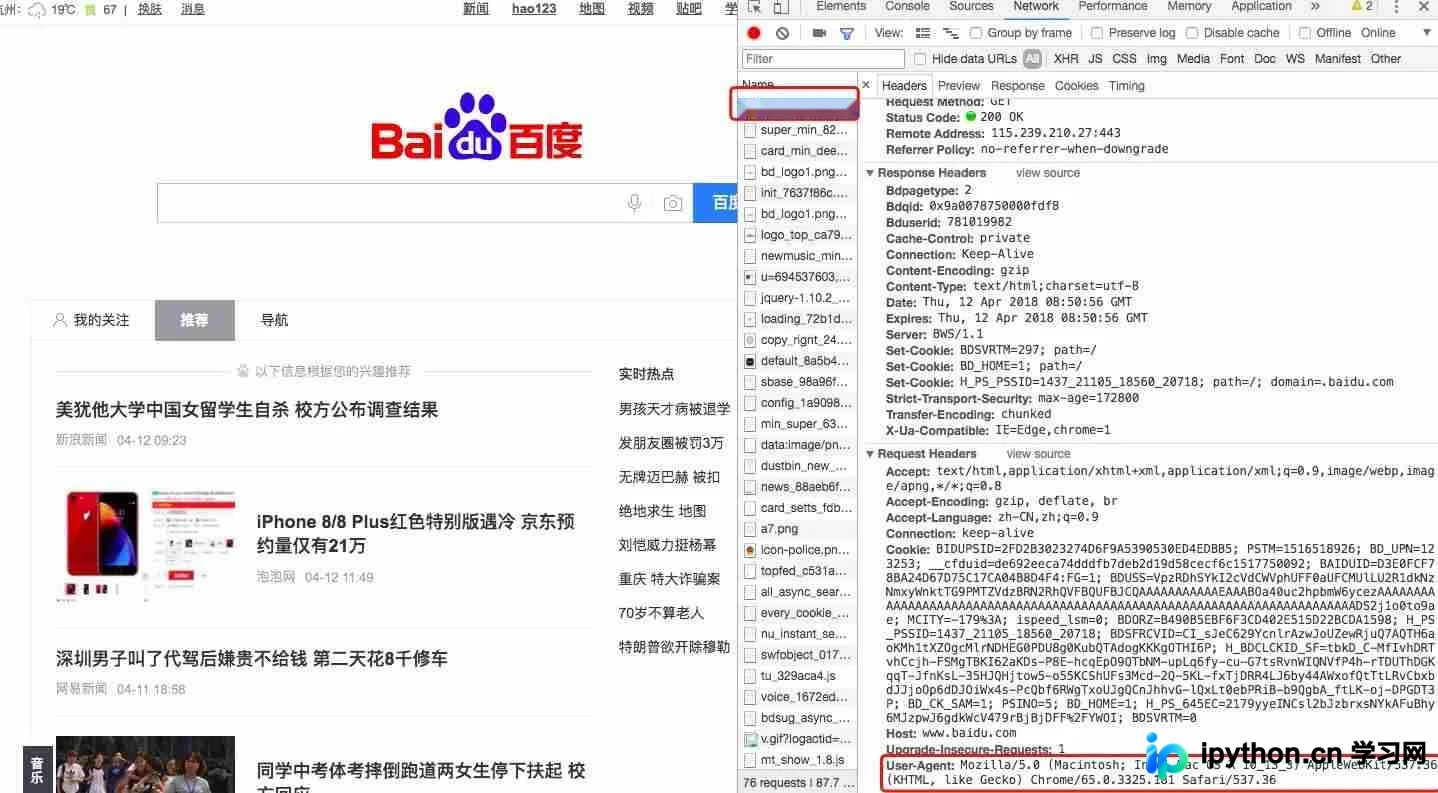
本文深入分析Python爬虫中两种主流反反爬策略:User-Agent伪装与IP代理池。通过对比两者在技术实现、成本及稳定性上的差异,指出UA易被伪造但成本低,而代理池虽能绕过IP限制却面临质量参差不齐的挑战。文章旨在帮助开发者根据实际场景选择最优方案,平衡抓取效率与合规性。