

Python requests模拟浏览器请求:添加Headers与Cookies教程
requests.get(url) 往往会因携带暴露脚本身份的特征而遭到拦截(如返回 403 Forbidden)。本文将详细讲解如何通过为 requests 正确装配 Headers(请求头)与 Cookies(身份凭证),以及利用 requests.Session 实现会话保持,从而稳定模拟真实浏览器的访问行为。
一、为什么默认的 requests 请求会被识别并拦截
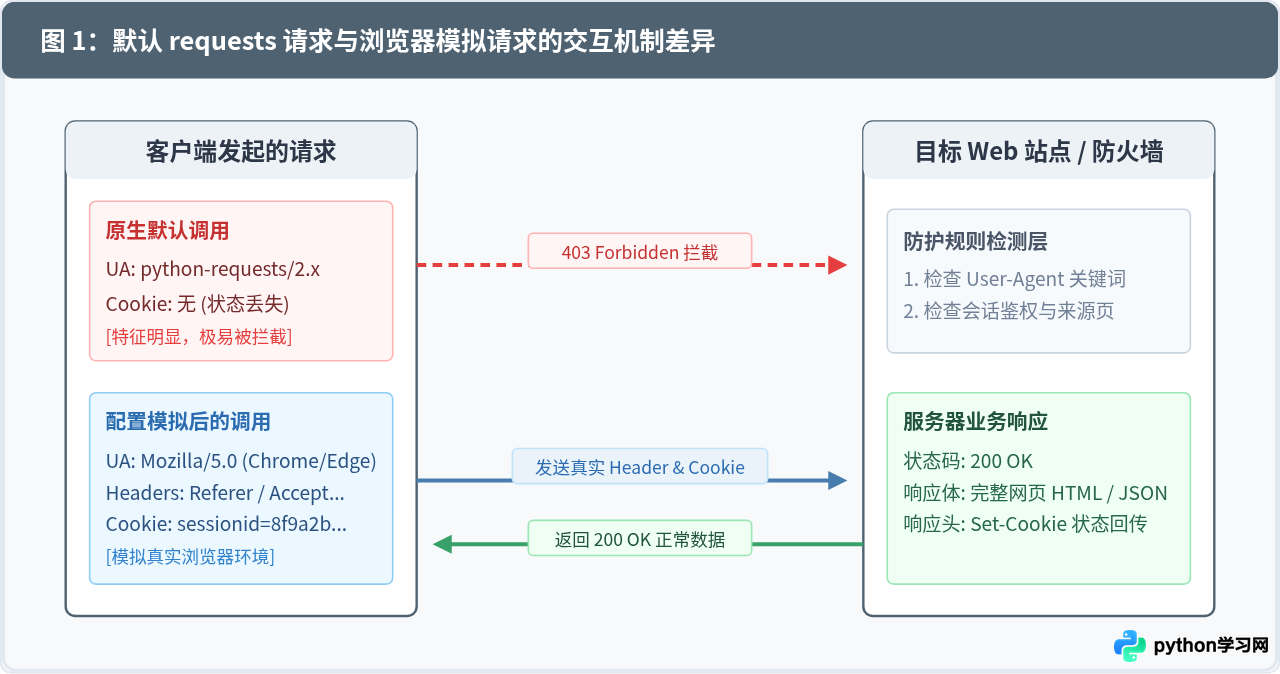
当我们在浏览器地址栏输入网址并敲击回车时,浏览器在底层会主动组装数十项 HTTP 请求头信息,包括浏览器内核版本(User-Agent)、语言偏好(Accept-Language)、内容类型(Accept)以及此前服务端颁发的登录令牌(Cookies)。这些参数构成了真实用户的网络指纹。
相对地,Python 的 requests 库如果未经显式配置,其默认发出的 HTTP 请求头极为简略,其中 User-Agent 字段默认值为类似 python-requests/2.31.0 的字符串。多数网站的 Web 应用防火墙(WAF)或防爬机制在收到请求的第一时间,就会通过检查该字段直接拒绝服务。
二、从浏览器开发者工具抓取请求参数
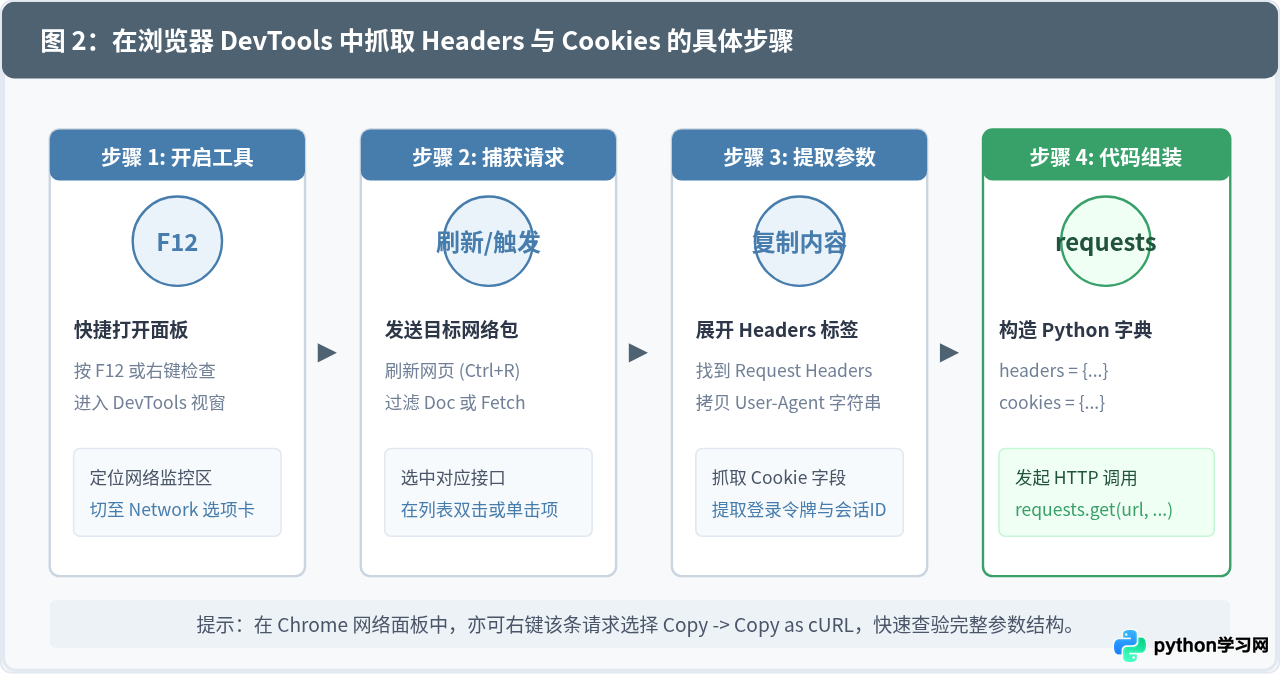
为了保证模拟请求的参数准确无误,通常直接从主流桌面浏览器(如 Google Chrome 或 Microsoft Edge)的开发者工具中抓取现成参数。
- 打开目标网页,在键盘上按下
F12(或在页面空白处单击鼠标右键选择“检查”)。 - 在弹出的开发者工具窗口顶部切换到 Network(网络) 选项卡。
- 刷新页面(按
F5或Ctrl+R),下方会显示浏览器加载的所有资源请求列表。 - 点击顶部筛选器选择
Doc(查看 HTML 主文档)或Fetch/XHR(查看异步接口数据)。 - 在请求列表中点击具体的接口 URL,右侧将展开详情面板;切换到 Headers 标签,向下滑动找到 Request Headers(请求头) 区域。
三、在 requests 中添加自定义 Headers
在 requests.get() 或 requests.post() 函数中,通过传入一个 Python 字典给 headers 关键字参数,即可覆盖或追加 HTTP 请求头。
常用请求头字段解析
| 字段名称 | 主要作用与模拟意义 |
|---|---|
User-Agent |
告知服务器客户端使用的操作系统、CPU 架构与浏览器版本内核。这是防爬识别的第一道门槛。 |
Referer |
标识当前请求的来源页面 URL。防盗链(如图片直接链接)、接口连续性校验高度依赖该字段。 |
Accept |
声明客户端期望接收的数据格式(如 text/html 或 application/json)。 |
Accept-Language |
指定偏好的自然语言(如 zh-CN,zh;q=0.9,en;q=0.8)。 |
代码示例:自定义 Headers 发送 GET 请求
import requests

target_url = "https://httpbin.org/headers"

# 构造模拟现代 Chrome 浏览器的请求头字典
custom_headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Referer": "https://www.google.com/"
}

# 通过 headers 参数传入字典
response = requests.get(target_url, headers=custom_headers, timeout=10)

print(f"响应状态码: {response.status_code}")
print("服务端接收到的请求头回显:")
print(response.json())user-agent 与 User-Agent 效果相同),但在向目标站点发送请求时,推荐遵循标准的首字母大写规范,以贴合真实主流浏览器的行为特征。
四、在 requests 中管理与传递 Cookies
Cookie 是由服务器发给客户端的小段文本,常用于标识用户登录状态或跟踪浏览行为。模拟浏览器访问需要登录或记录状态的资源时,必须携带有效的 Cookies。
方法 1:使用 cookies 参数传入字典
当已知 Cookie 的键值对时,最推荐的做法是将它们封装为字典并传递给 cookies 参数:
import requests

url = "https://httpbin.org/cookies"

# 准备身份凭证字典
cookie_dict = {
    "session_token": "a91fbc89e32049d5",
    "user_id": "98021",
    "logged_in": "true"
}

# headers 中可继续保留 User-Agent
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

response = requests.get(url, headers=headers, cookies=cookie_dict)
print(response.json())
方法 2:解析从浏览器直接拷贝的原始 Cookie 字符串
从浏览器 DevTools 中直接复制出来的 Cookie 往往是一整串以分号加空格隔开的文本,例如:
session_token=a91fbc; user_id=98021; theme=dark。
我们可以使用一段简单的推导式快速将其解析为 Python 字典:
raw_cookie_str = "session_token=a91fbc89e32049d5; user_id=98021; theme=dark"

# 字符串快速解析为字典
cookies_dict = {}
for item in raw_cookie_str.split(";"):
    if "=" in item:
        key, value = item.strip().split("=", 1)
        cookies_dict[key] = value

response = requests.get("https://httpbin.org/cookies", cookies=cookies_dict)
五、核心进阶:使用 requests.Session() 维持会话与自动维护 Cookies
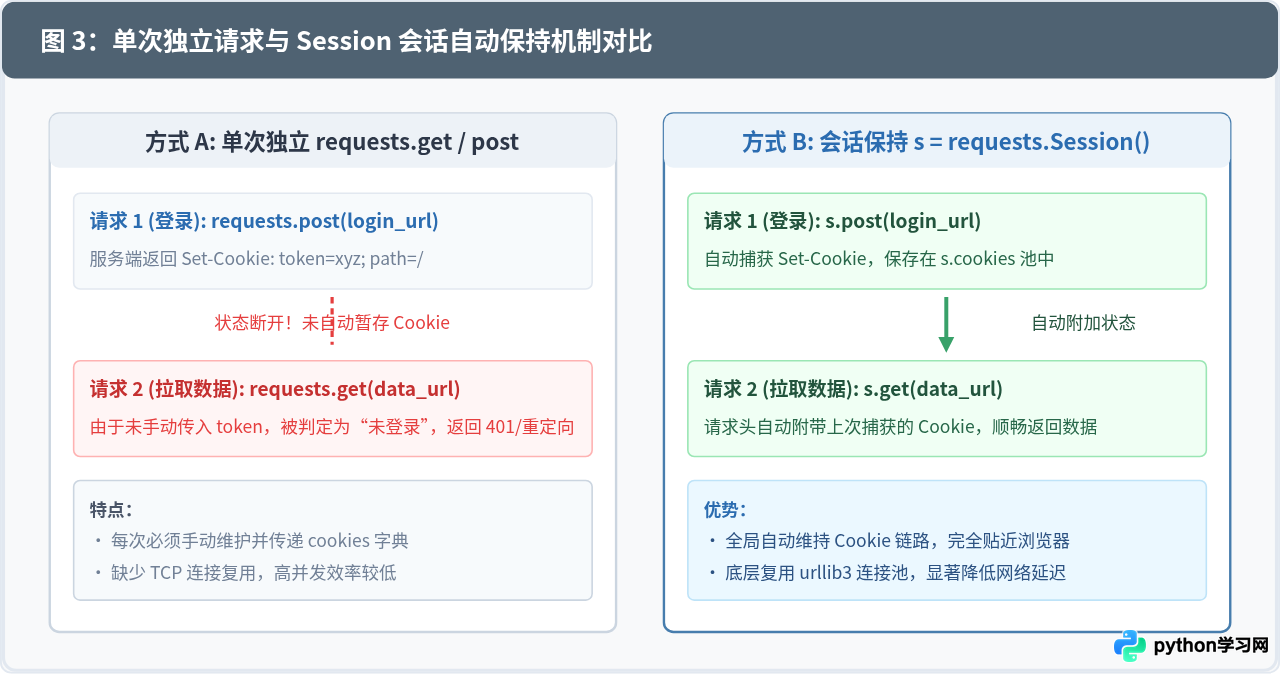
在实际交互中,网站往往需要多步操作(例如先访问登录页获取临时 Token,再提交表单登录,最后爬取个人中心)。如果使用单纯的 requests.get(),每次调用都是完全独立的底层 TCP 握手与无状态请求,服务端返回的 Set-Cookie 指令不会自动延续到下一次请求。
requests.Session() 对象能够跨请求保持环境。它在内部维护了一个 CookieJar,当服务端响应中包含新的 Cookie 时会自动写入,并在后续的每个请求中自动附带,完全还原浏览器的跨页会话机制。
代码示例:使用 Session 管理全局 Headers 与自动维持 Cookies
import requests

# 1. 实例化 Session 对象
session = requests.Session()

# 2. 为当前会话注入通用 Headers(后续所有由 session 发起的请求均生效)
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9"
})

# 3. 发送首个请求(例如服务器颁发 Cookie 的接口)
res1 = session.get("https://httpbin.org/cookies/set?auth_token=xyz123&user=dev")
print("初次设置后的 Cookies:", session.cookies.get_dict())

# 4. 后续请求直接复用 Session,无需重复传递 cookies 参数
res2 = session.get("https://httpbin.org/cookies")
print("后续请求服务端实际捕获的 Cookies:")
print(res2.json())
六、排错与反爬排查:模拟请求时的关键检查清单
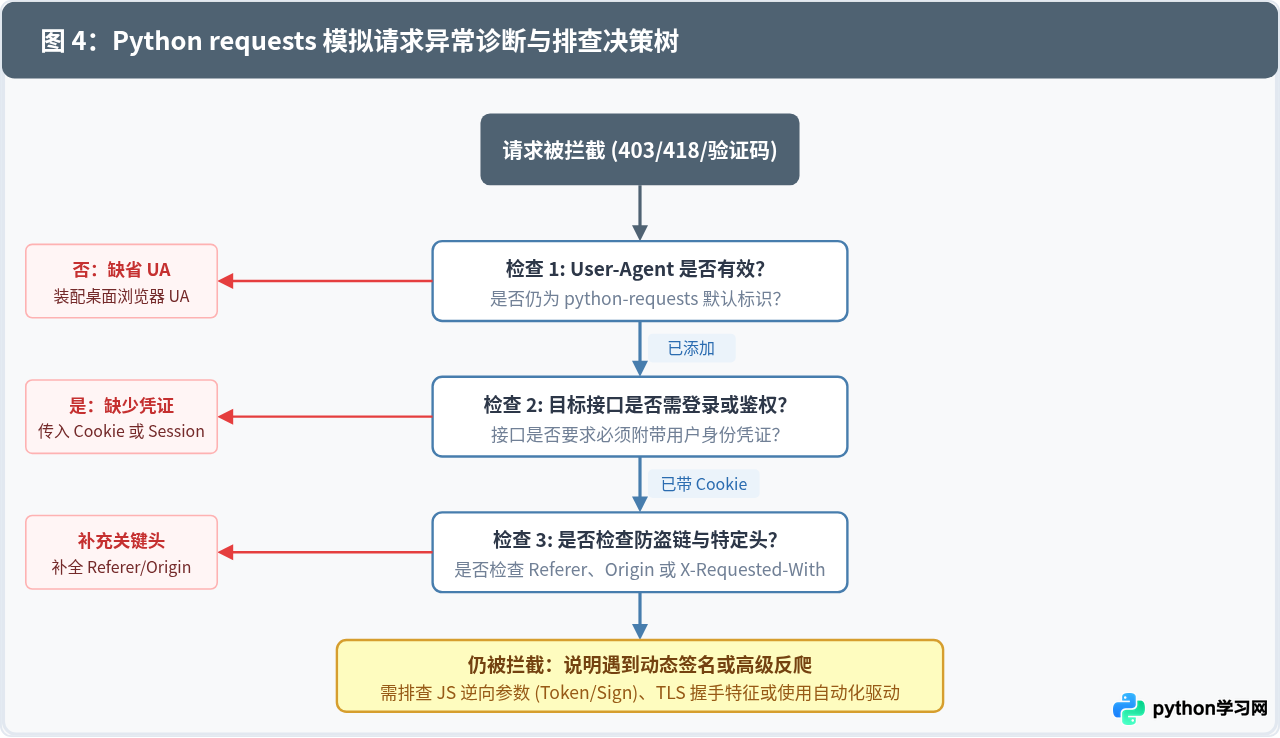
在许多现实场景中,即使我们按常规配置了 User-Agent 和 Cookie,仍然可能遭遇 403 Forbidden、重定向回登录页或返回带有反爬验证码的页面。此时建议按照以下诊断树逐层核查:
七、常见踩坑与最佳实践总结
-
Cookie 的时效性:
直接从浏览器拷贝的 Cookie 往往包含生命周期(如expires或max-age),一旦会话过期,直接使用旧 Cookie 将持续收到未登录或 401 提示。对于长期运行的脚本,优先通过Session模拟登录接口动态获取新的 Cookie。 -
敏感参数不要硬编码:
在团队协作或提交代码到 Git 仓库时,包含个人账号信息的 Cookies 务必通过环境变量(os.environ)或配置文件载入,切勿直接以纯文本形式提交。 -
超时与网络重试配置:
在模拟浏览器请求时,始终为requests.get()或requests.post()设置明确的timeout参数(如timeout=(5, 15)),避免由于网络波动或目标服务器长时间挂起导致脚本无限阻塞。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









