

基于jieba分词与同义词词典的Python文本替换实现

发布时间:2026-10-13| 3人浏览过
本文介绍如何利用Python的jieba库结合自定义同义词词典实现文本中的词汇替换。通过读取指定格式的TXT文件构建映射字典,调整特定词汇的词频以确保正确分词,随后对输入字符串进行切分并执行替换逻辑。该方法适用于需要标准化术语或进行文本预处理的自然语言处理场景。
同义词词典文件格式规范
同义词替换所需的文本文件需遵循特定格式规范。
在文件格式上,同一行内的多个词汇必须使用单个空格进行分隔。每行的第一个词被定义为该行其余词汇的替换目标词,即其他词在匹配成功后将被替换为该行首词。
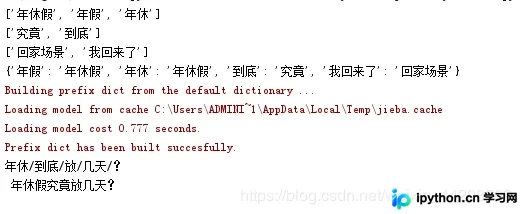
例如,文件内容可能包含如下映射关系:第一行将“年休假”、“年假”和“年休”关联,其中“年休假”为替换词;第二行将“究竟”与“到底”关联;第三行将“回家场景”与“我回来了”关联。这些示例展示了多义词到统一替换词的映射逻辑。
Python实现代码解析
实现该功能的核心代码逻辑如下。
import jieba


def replaceSynonymWords(string1):
 # 1读取同义词表,并生成一个字典。
 combine_dict = {}
 # synonymWords.txt是同义词表,每行是一系列同义词,用空格分割
 for line in open("TihuanWords.txt", "r", encoding='utf-8'):
   seperate_word = line.strip().split(" ")
   num = len(seperate_word)
   for i in range(1, num):
     combine_dict[seperate_word[i]] = seperate_word[0]
   print(seperate_word)
 print(combine_dict)

 # 2提升某些词的词频,使其能够被jieba识别出来
 jieba.suggest_freq("年休假", tune=True)

 # 3将语句切分成单词
 seg_list = jieba.cut(string1, cut_all=False)

 f = "/".join(seg_list).encode("utf-8")
 f = f.decode("utf-8")
 print(f)
 # 4返回同义词替换后的句子
 final_sentence = " "
 for word in f.split('/'):
   if word in combine_dict:
     word = combine_dict[word]
     final_sentence += word
   else:
     final_sentence += word
 # print final_sentence
 return final_sentence


string1 = '年休到底放几天?'
print(replaceSynonymWords(string1))
运行结果说明
执行上述代码后,程序将输出构建好的同义词映射字典、分词后的中间结果以及最终替换完成的句子。例如,输入“年休到底放几天?”时,系统会将其转换为“年休假到底放几天?”。
以上即为利用jieba库实现同义词替换的完整流程与代码示例,希望能为相关技术学习提供实用参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









