Python脚本自动去除代码文件中的行号标签
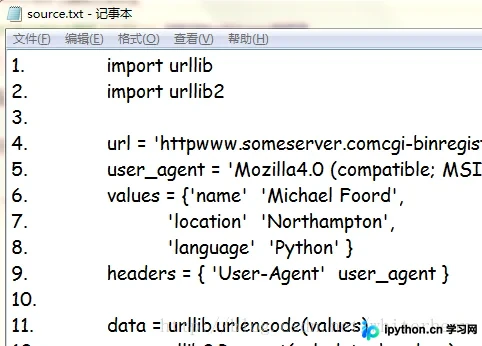
本文介绍使用Python脚本自动清理从网络复制代码时产生的行号标签问题。通过逐行读取文件,利用正则表达式匹配数字加点及制表符的模式,并结合字符串替换方法移除多余字符,最终将清洗后的内容写回原文件,实现高效批量处理。
2026-10-13
6

本文介绍使用Python脚本自动清理从网络复制代码时产生的行号标签问题。通过逐行读取文件,利用正则表达式匹配数字加点及制表符的模式,并结合字符串替换方法移除多余字符,最终将清洗后的内容写回原文件,实现高效批量处理。
本文介绍在 Python 中向 txt 文件指定位置插入或追加文本的方法。通过读取所有行到列表,利用 insert 方法在指定索引处添加新内容,再重新写入文件。代码展示了完整的读写流程,适用于需要在特定行插入数据的场景。
本文详解Python中利用fileinput模块实现文件特定行插入与替换的方法。通过设置inplace=1重定向输出,可模拟类似sed的功能,在指定行号插入内容或匹配模式进行替换,适用于小型文本处理场景。
Python正则表达式中,非捕获组((?:...))专为逻辑分组设计,不保存匹配结果。通过对比普通捕获组,可直观掌握其语法特性。本文结合实际提取、交替匹配及性能基准测试代码,详细说明何时使用非捕获组以降低内存消耗并提升大规模文本处理速度。
本文介绍如何使用Python实现TF-IDF算法进行文本关键词提取。TF-IDF由词频(TF)和逆文档频率(IDF)组成,通过计算词频与逆文档频率的乘积来评估词语在文档中的重要性。文章详细讲解了TF-IDF的计算步骤,包括计算词频、逆文档频率以及最终的TF-IDF值,并提供了完整的Python代码实现。
本文介绍如何使用Python内置的re模块进行正则表达式操作。通过导入模块、编译模式字符串、使用search()和split()方法,您可以高效地搜索、匹配和分割文本数据。文章涵盖基础语法、特殊字符处理及常见应用场景,帮助开发者掌握Python文本处理的核心技能。
本文介绍了一种使用 PHP 正则表达式检测字符串中是否包含非本站域名的外部链接。通过 preg_match_all 提取所有 URL,并与当前主机域名进行比对,从而快速判断内容安全性与链接指向。该方法代码简洁,适用于评论过滤、文本清洗等场景。
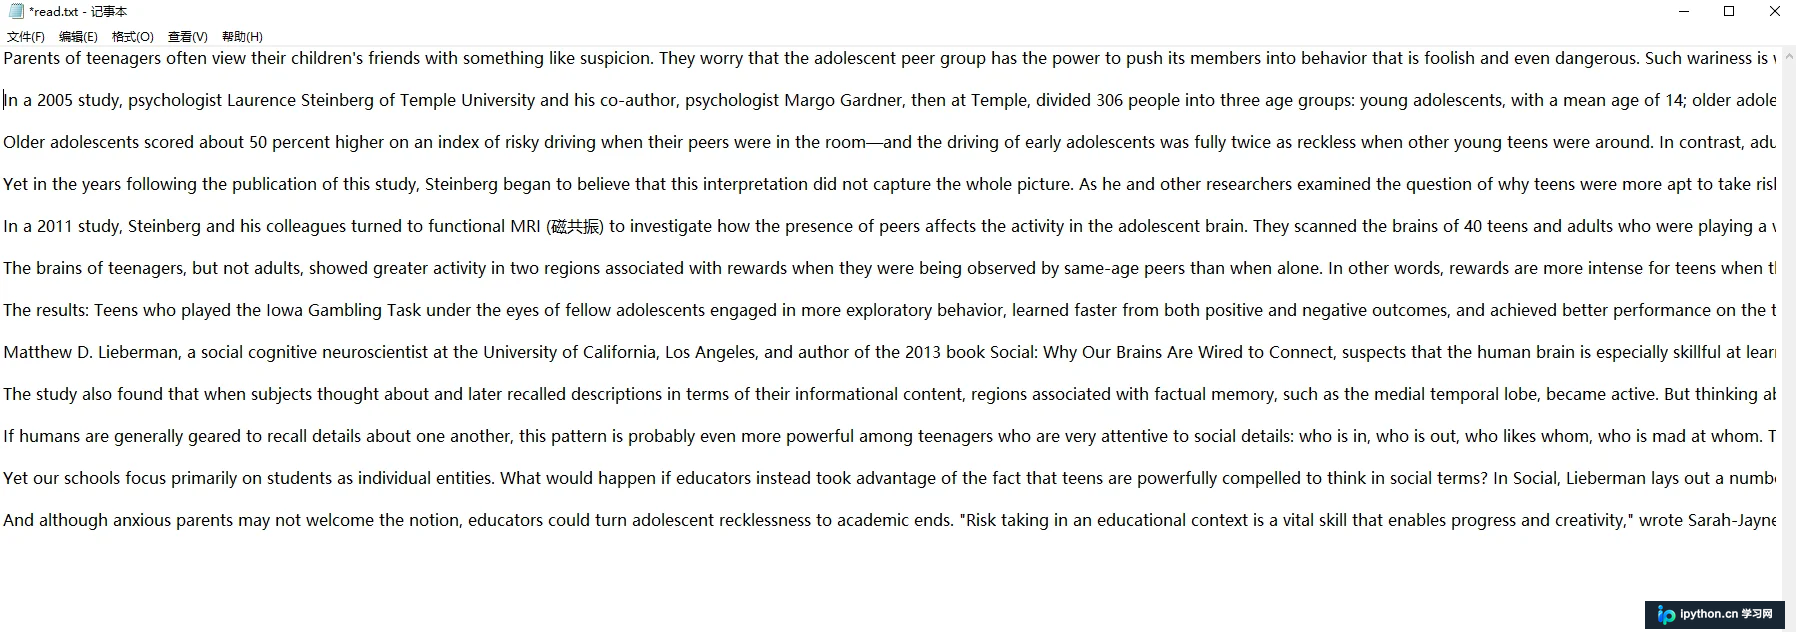
本文介绍使用Python实现词频统计软件的方法。涵盖文件读取、大小写转换、特殊字符去除、单词统计、排序及结果写入文本等步骤。通过正则表达式清洗数据,利用字典统计词频,并按出现次数降序排列,最终输出高频单词及总数,适合初学者参考。
本文详解如何利用Python正则表达式从文本中精准提取版本号。通过解析正则模式r'\d+\.(?:\d+\.)*\d+',结合re模块的findall与group方法,实现从源文件读取并写入目标文件的全流程。文章还深入对比了捕获组与非捕获组的区别,帮助开发者避免常见陷阱,提升文本解析效率。
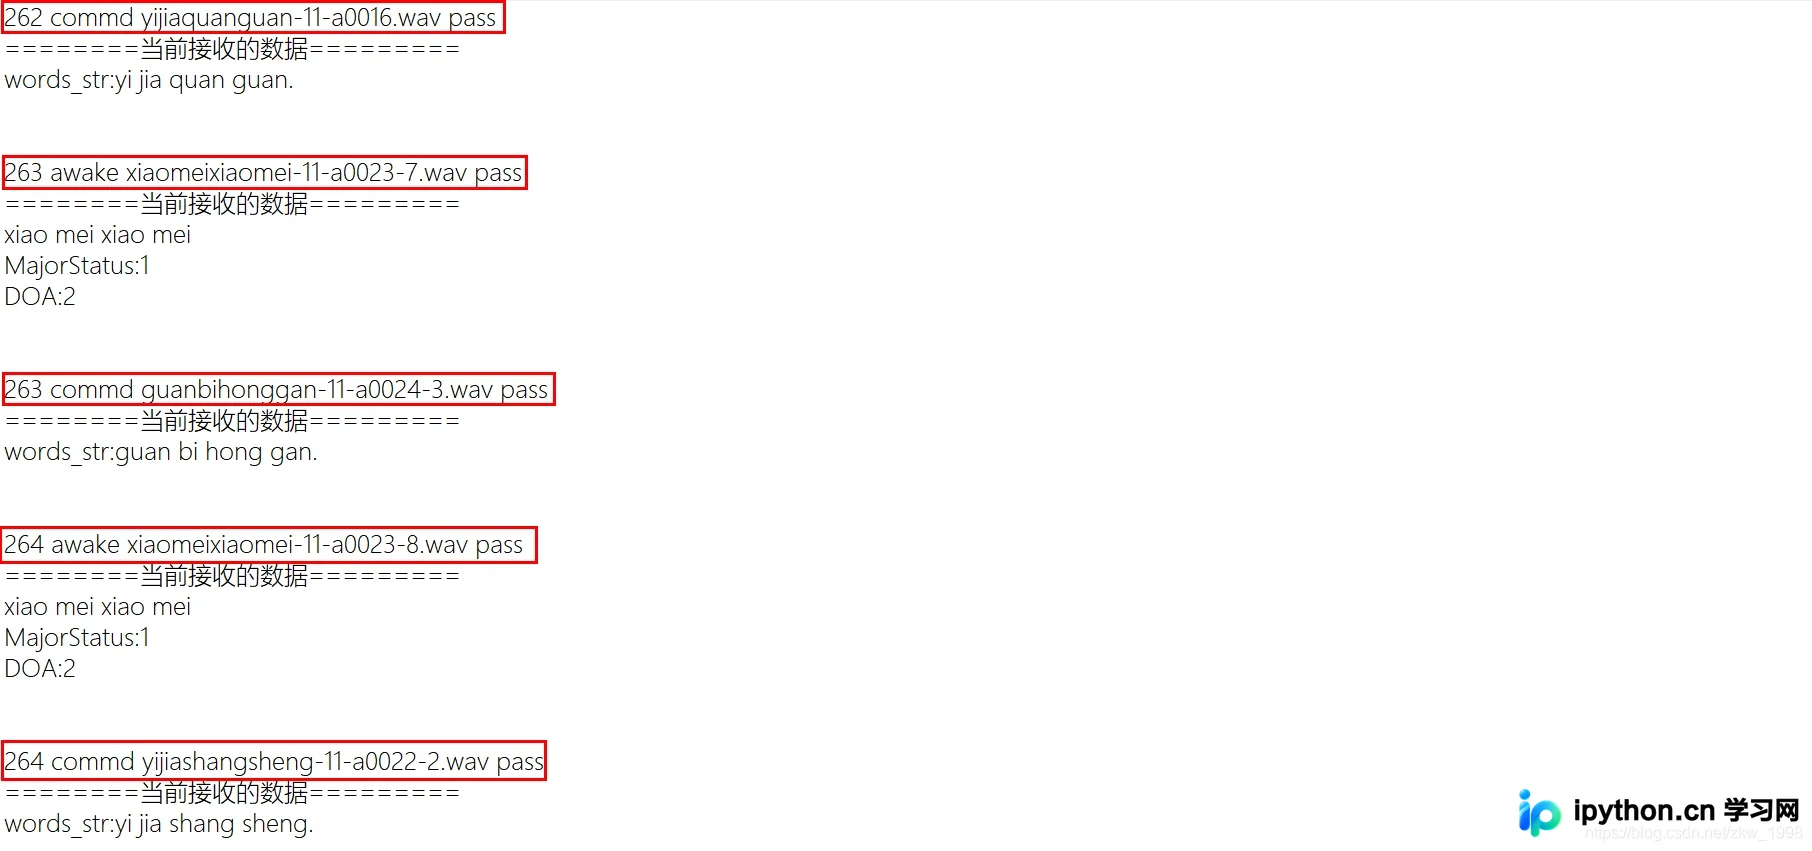
本文通过Python代码示例,演示如何利用正则表达式提取包含特定关键词(如pass)的文本行,并进一步展示如何清洗数据,去除行号、特定前缀及文件扩展名。同时补充了\d、\w、\s等常用正则元字符的匹配规则,适用于日志分析与文本清洗场景。
本文介绍使用Python将用户输入的文本去除所有空格后保存为txt文件的方法。通过字符串的replace函数实现去空格,并利用文件操作将结果写入Output.txt文件中,供参考学习。
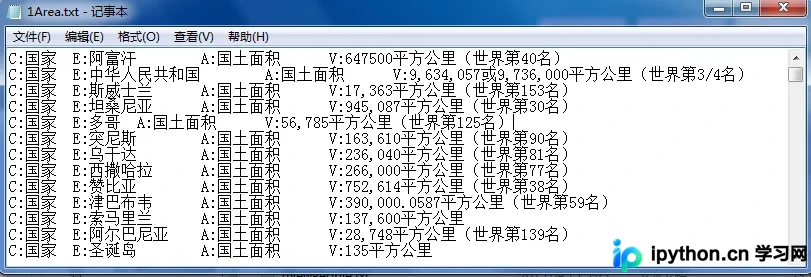
本文介绍Python中列表的基础操作,重点讲解二维列表的排序方法。通过对比list.sort()与sorted()的区别,演示如何利用lambda表达式按指定关键字排序。同时,结合从TXT文件读取国土面积数据的实例,详细阐述字符串清洗、正则匹配及数值转换技巧,帮助读者掌握实际数据处理流程。