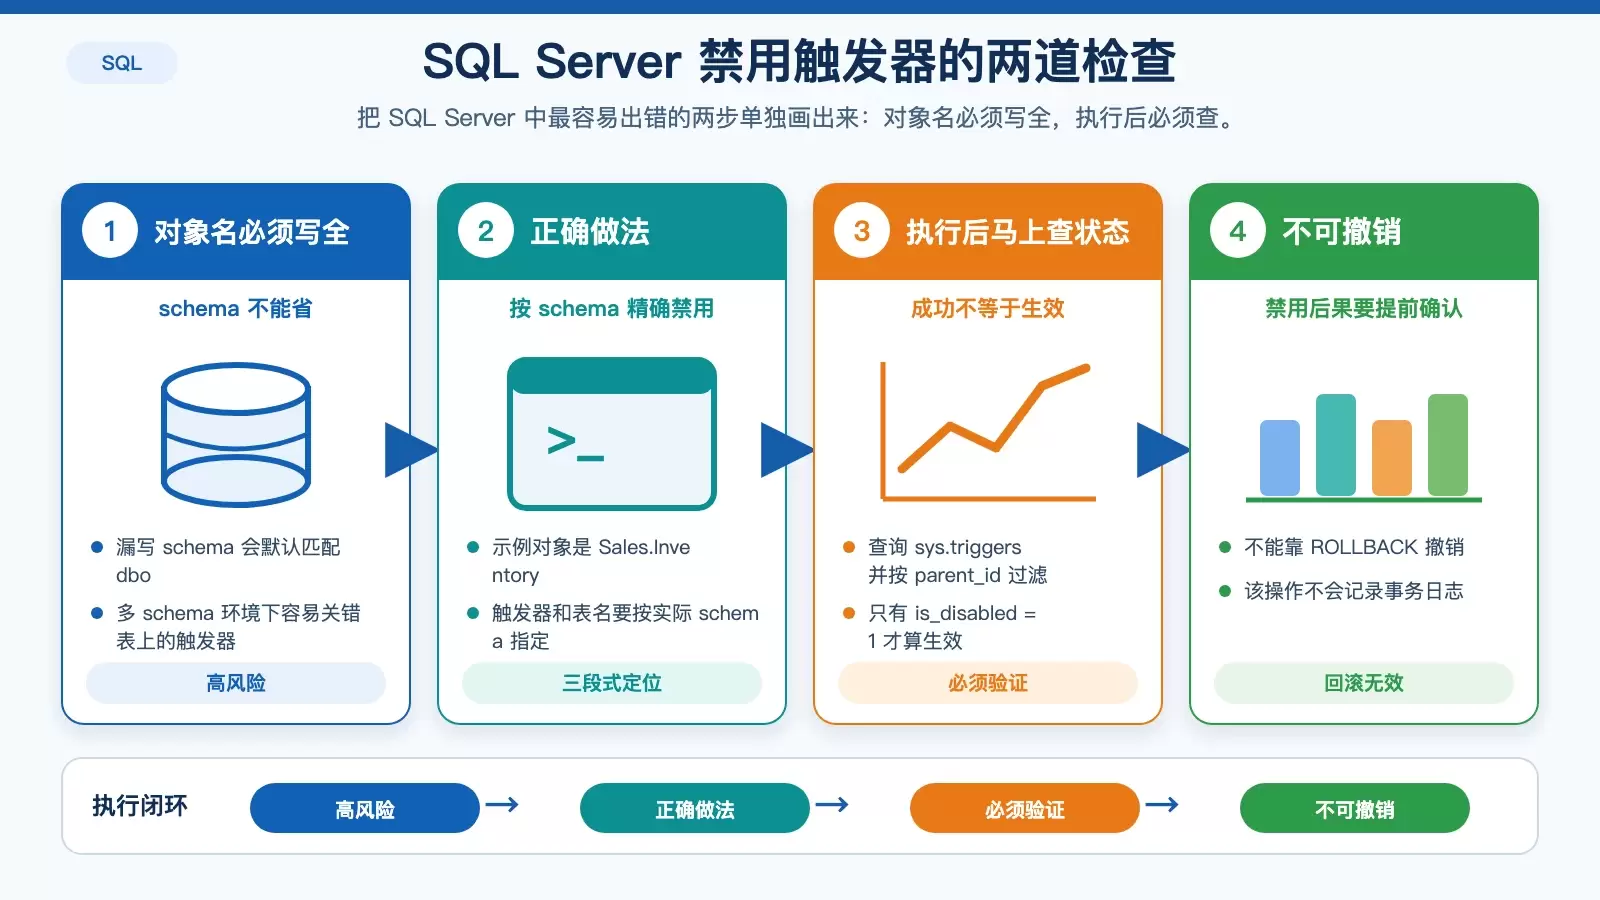
如何临时禁用 SQL 触发器进行数据修复
临时关闭触发器做数据修复,风险往往不在语法本身,而在误关对象、会话范围和修复后的验证。本文按 SQL Server、MySQL、PostgreSQL 三类场景梳理可执行写法、限制条件与恢复检查点,帮助你判断哪些做法能在生产环境真正落地。
2026-08-22
72

临时关闭触发器做数据修复,风险往往不在语法本身,而在误关对象、会话范围和修复后的验证。本文按 SQL Server、MySQL、PostgreSQL 三类场景梳理可执行写法、限制条件与恢复检查点,帮助你判断哪些做法能在生产环境真正落地。
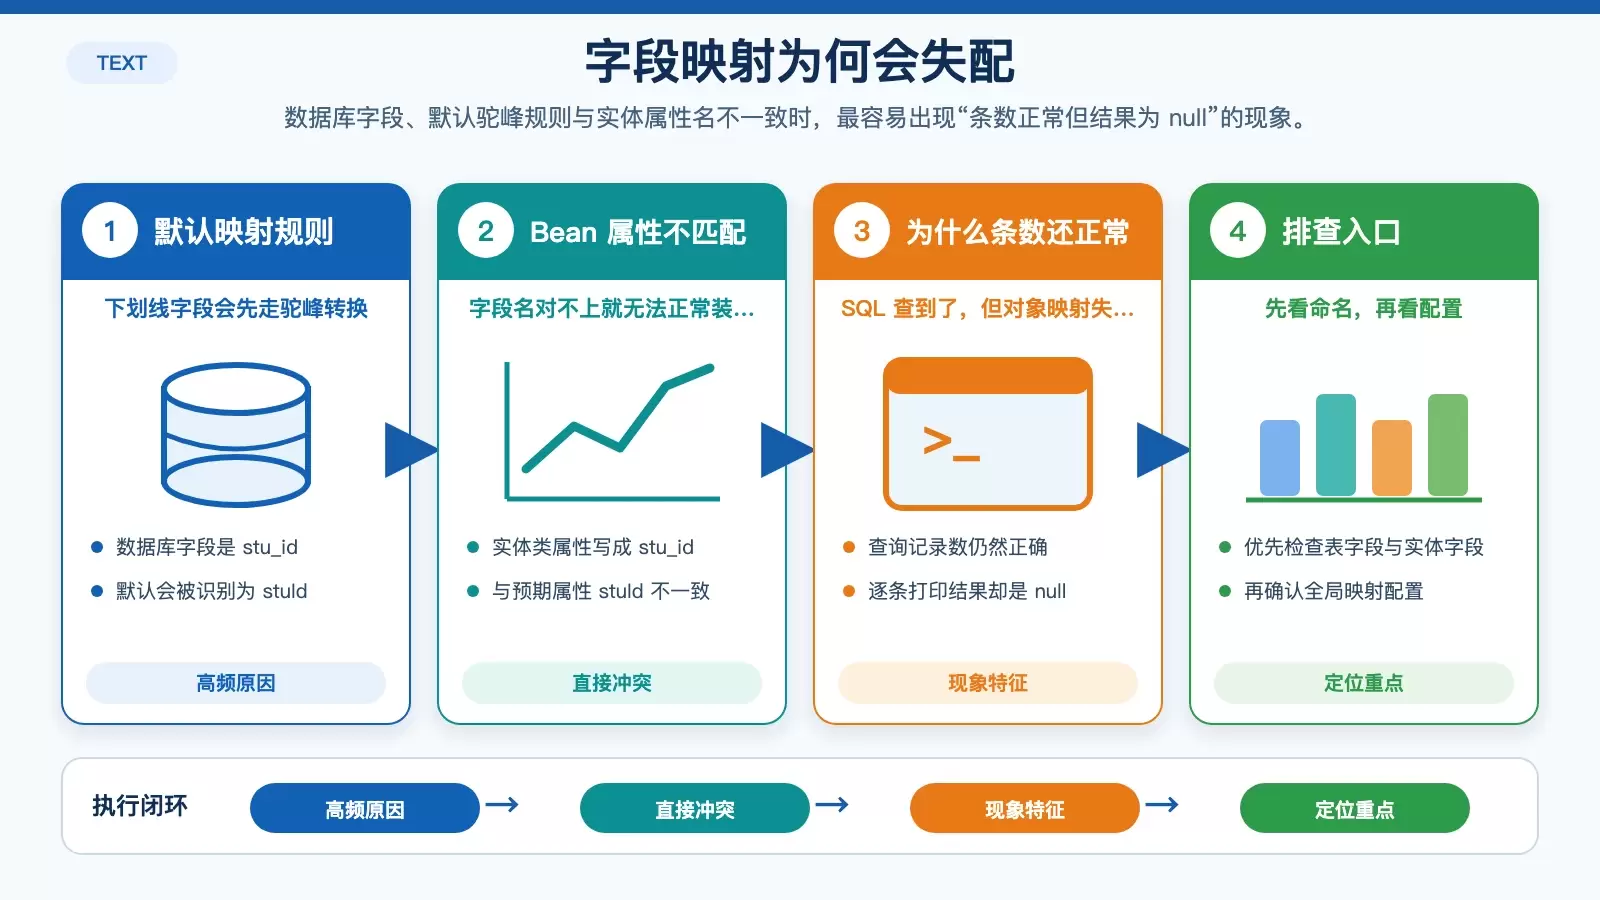
MyBatis-Plus 查询结果“条数正确但每项都是 null”,通常不是 SQL 没查到,而是结果映射阶段出了问题。最常见的原因是下划线字段与默认驼峰映射冲突,其次还要检查 Bean 的 setter、Lombok 生效情况,以及是否需要关闭 `map-underscore-to-camel-case`。
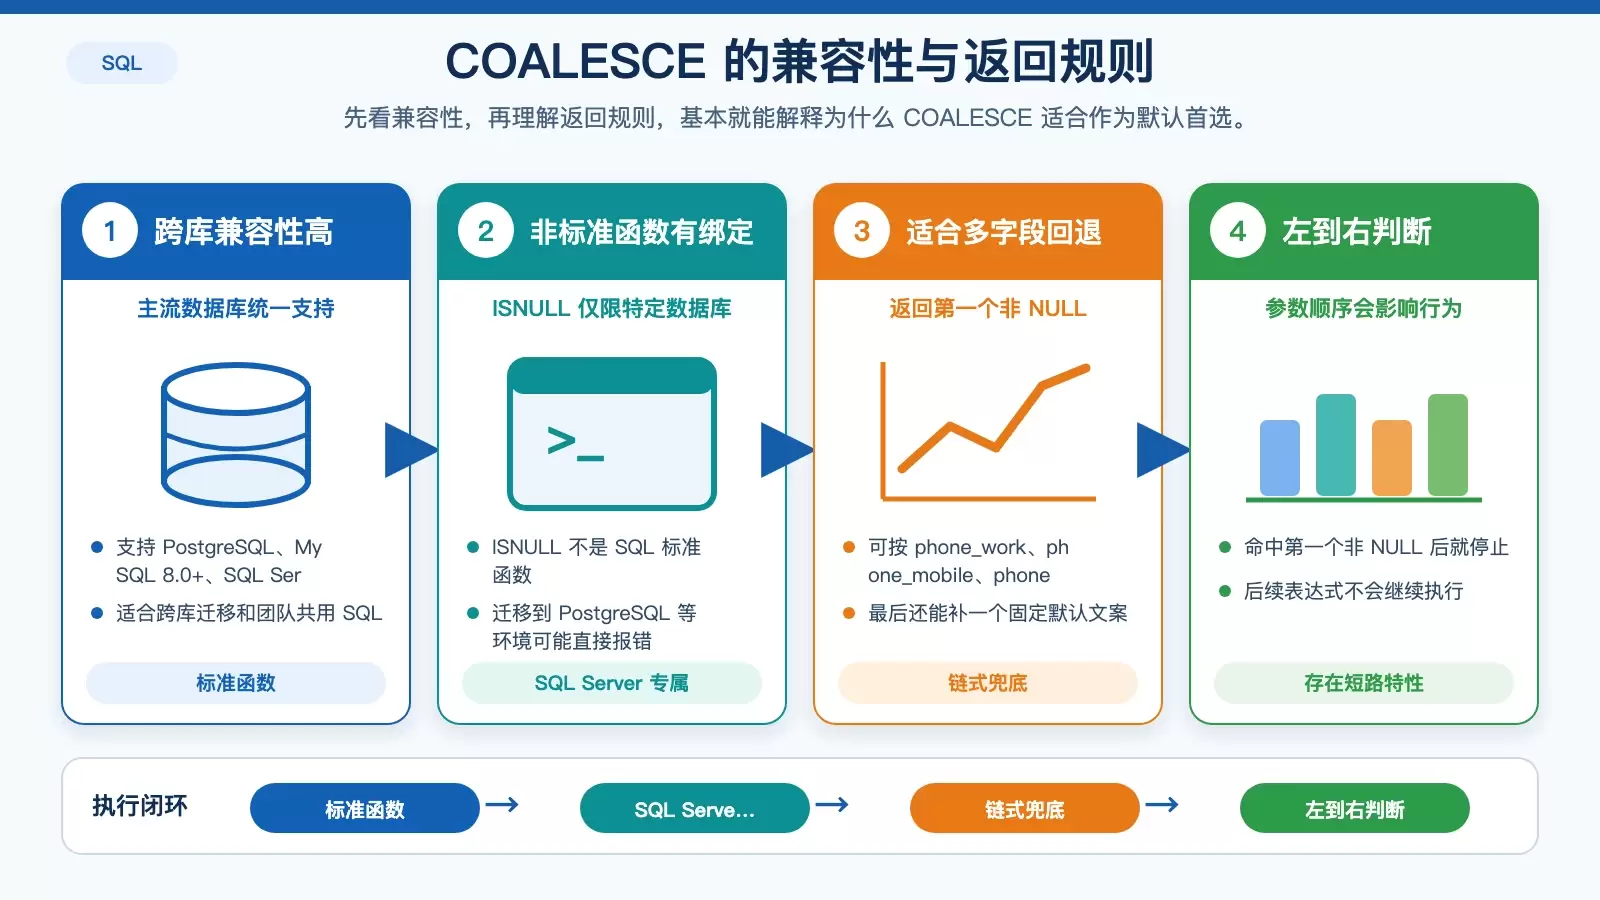
COALESCE 是处理 NULL 的常用函数,但真正写进生产 SQL 时,兼容性、类型推导和索引命中往往比语法本身更关键。本文从跨库支持、类型陷阱、WHERE/JOIN 性能影响到 CASE 的替代场景,整理一套更稳妥的使用方法。
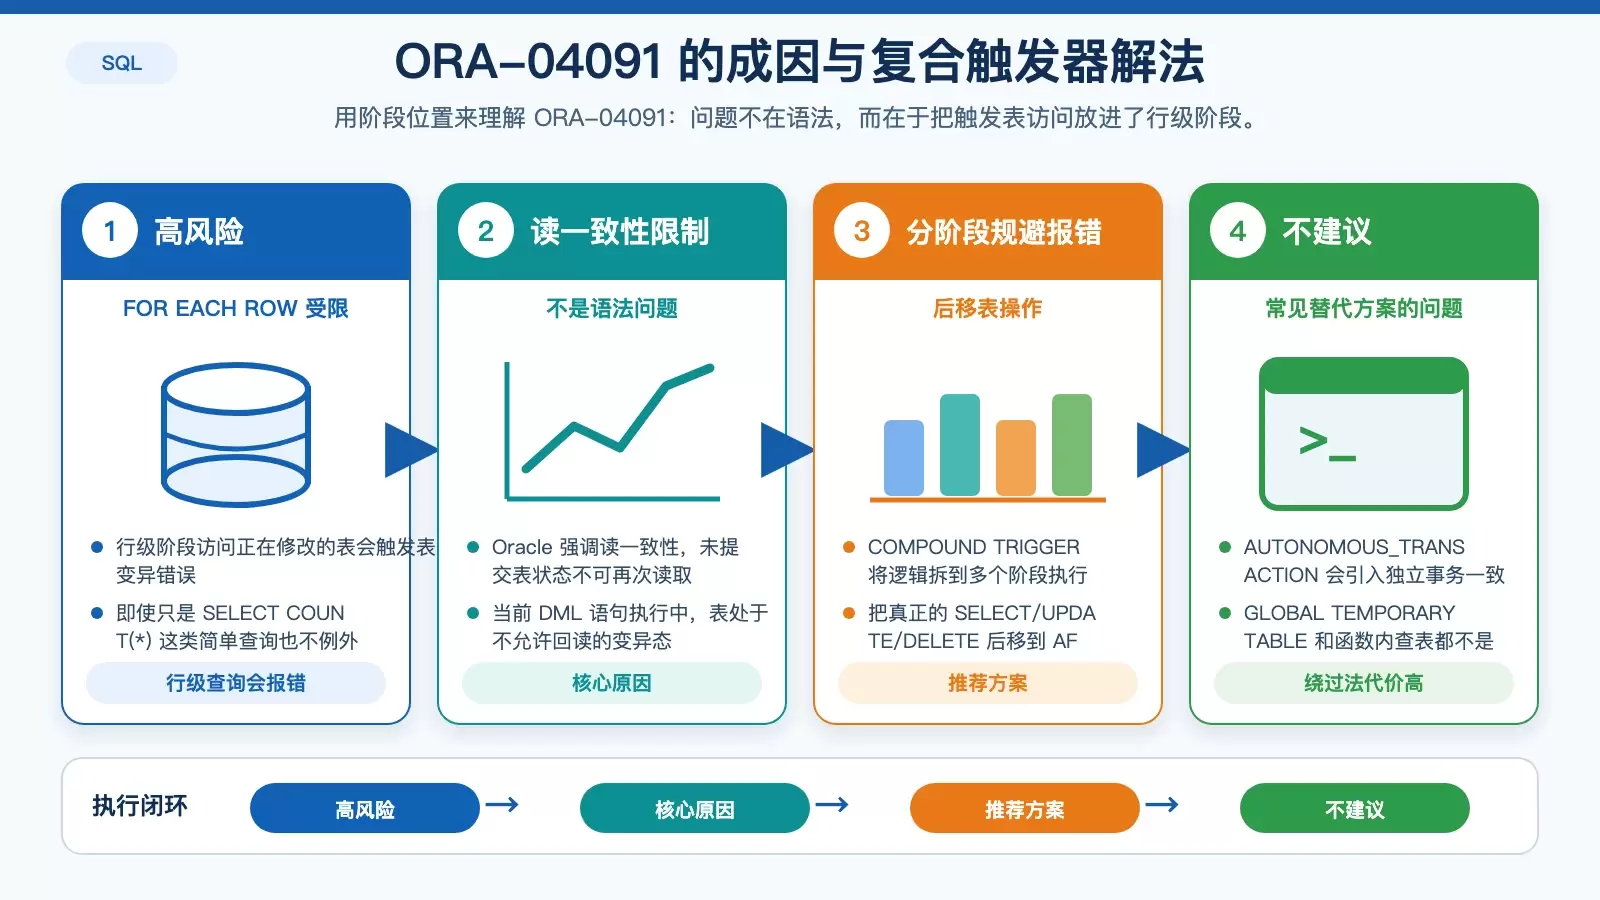
在 Oracle 19c 里,行级触发器一旦直接查询或修改当前触发表,通常就会撞上 ORA-04091。解决思路不是绕事务,而是改用 COMPOUND TRIGGER,把数据收集和表访问拆到不同阶段,尤其把真正的查询、更新和汇总后移到 AFTER STATEMENT。
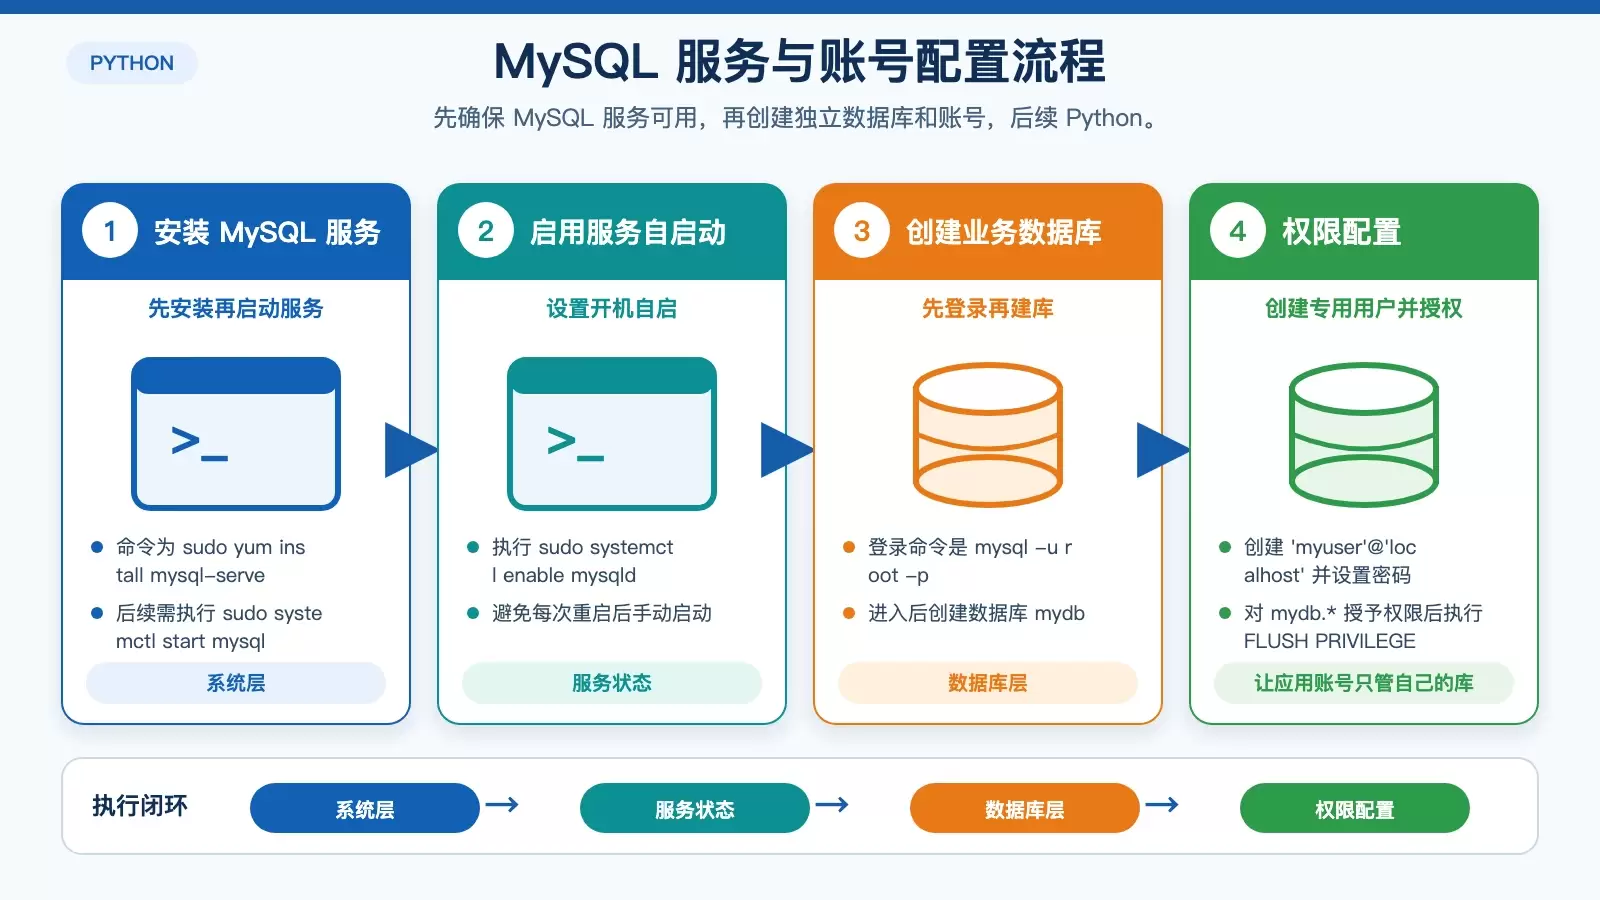
这篇文章用 MySQL 为例,梳理了在 CentOS 中让 Python 成功连上数据库的基础流程:安装服务、创建专用库和用户、安装驱动、编写测试脚本并排查常见报错。适合本地开发或测试环境快速搭建。 在 CentOS 上配置 Python 连接数据库,真正容易卡住的往往不是代码本身,而是服务状态、账号权限和连接参数没有对齐。
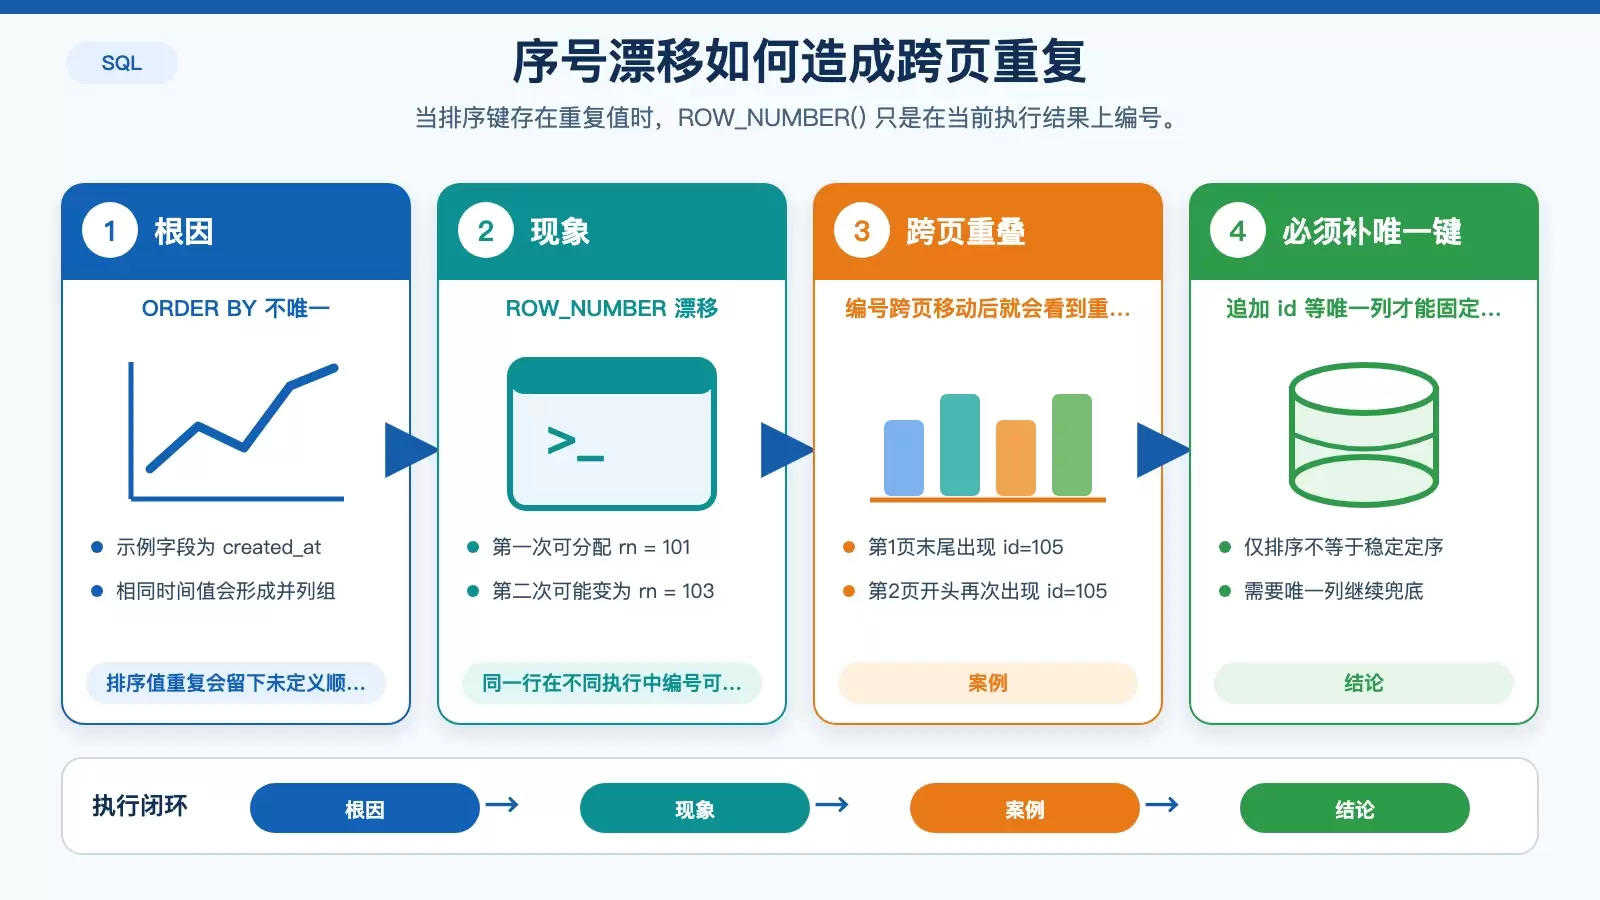
`ROW_NUMBER()` 分页出现跨页重复,通常不是语法问题,而是排序键不唯一、过滤层级不对或索引与参数设计失配。本文按“为什么会重复、SQL 该怎么写、索引和参数如何收口”三步拆开,帮助你同时排查结果稳定性和深分页性能。
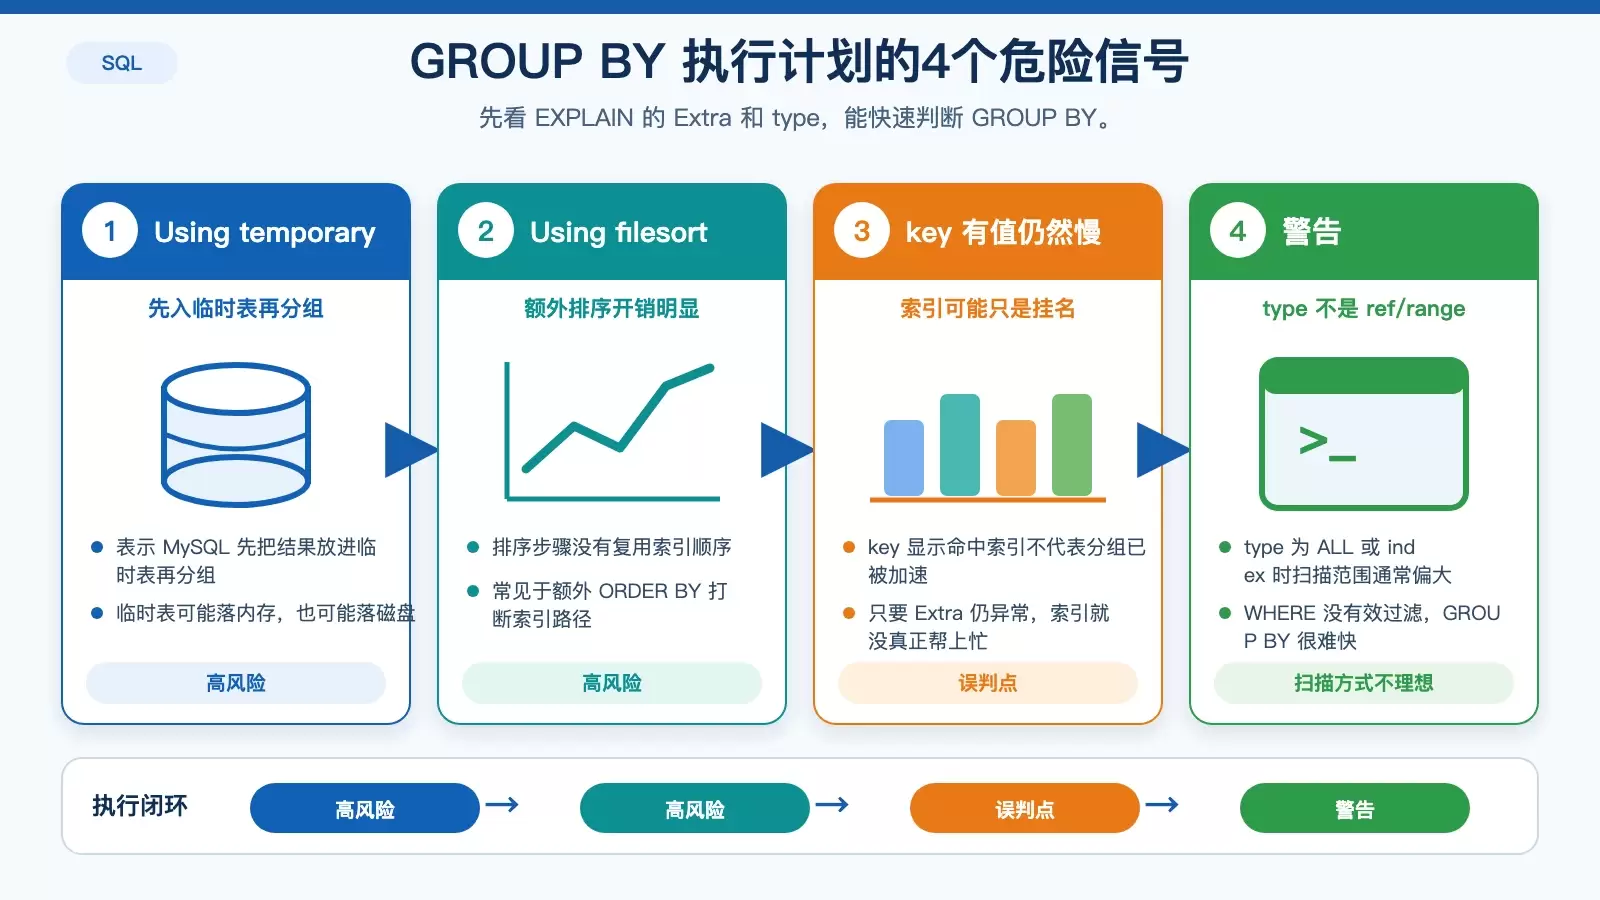
GROUP BY 查询变慢,常见根因不是数据量大,而是执行计划没走上正确的索引路径。排查时先看 EXPLAIN 的 Extra 列,再结合联合索引顺序、覆盖情况、类型转换和 DISTINCT 替代场景逐项定位。 遇到 GROUP BY 查询变慢时,很多优化都停留在“补个索引试试”这一层,结果往往不稳定。
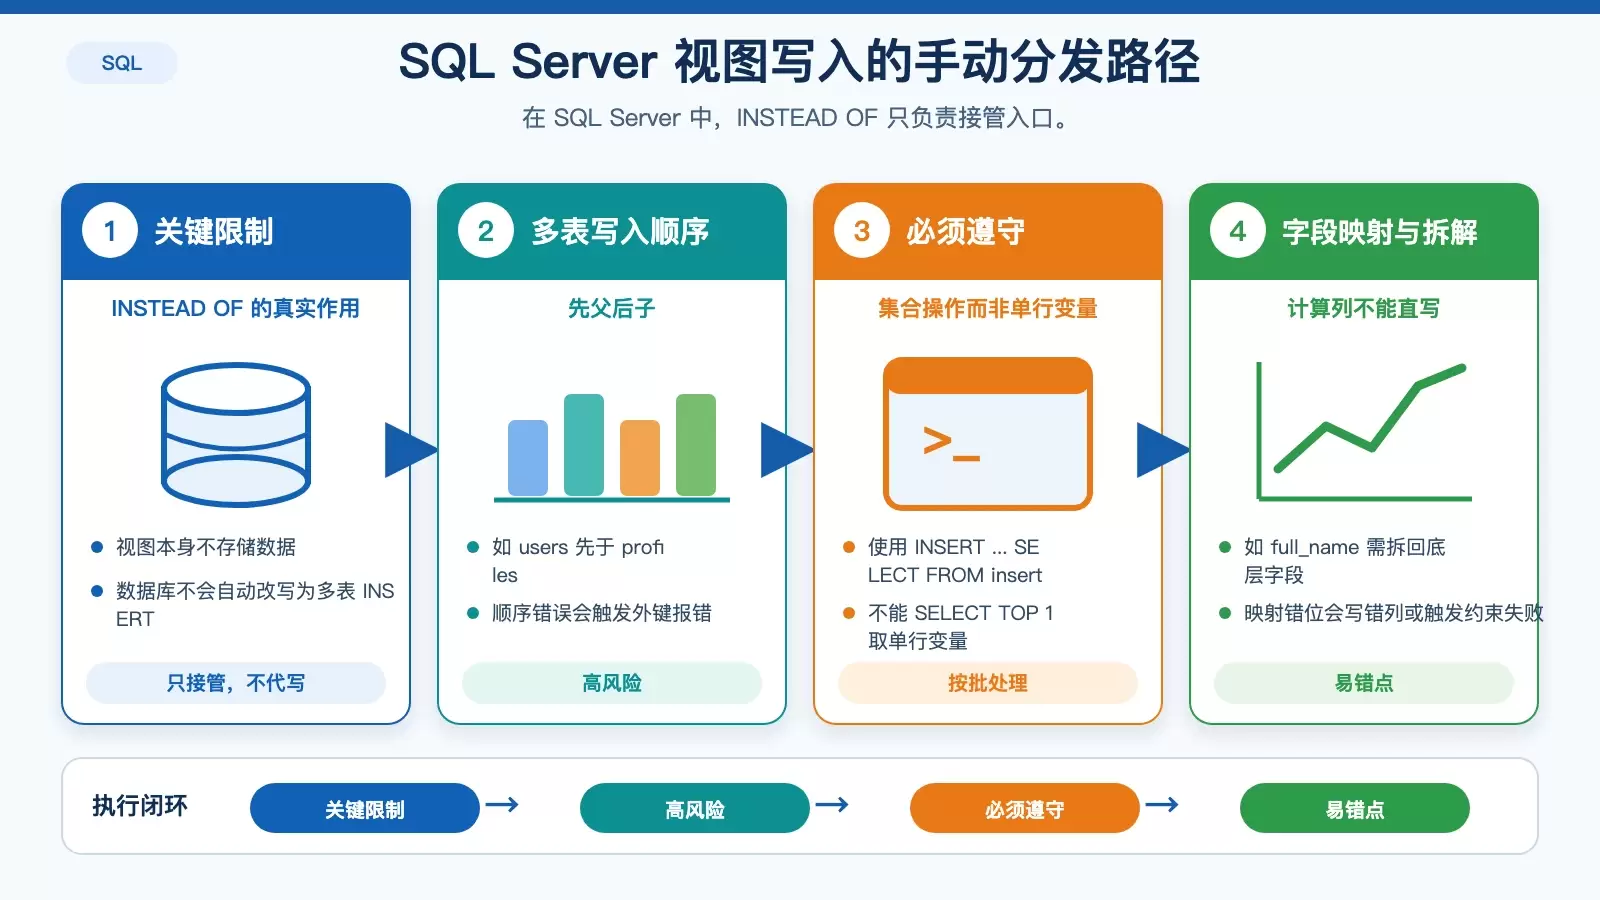
复杂视图之所以不能像表一样直接更新,核心不在语法,而在数据库是否愿意替你拆解 DML。SQL Server 允许借助 INSTEAD OF 触发器接管写入,但所有分发表、字段映射和校验都要手写;MySQL 则直接禁止在视图上创建触发器。
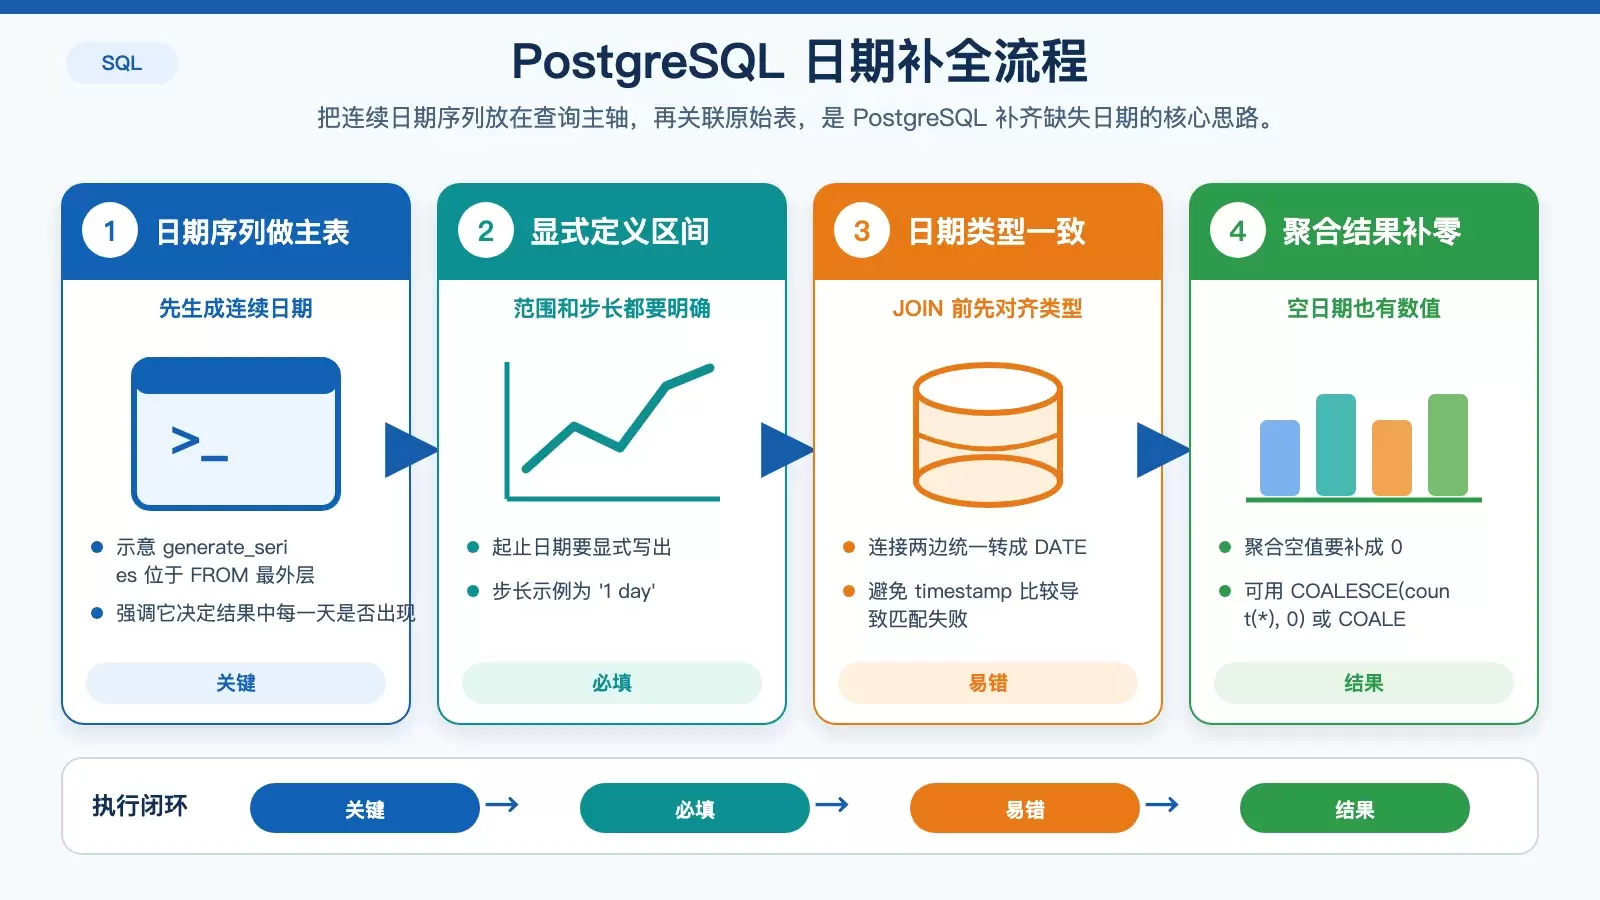
按日期分组后出现“断档”,通常不是 GROUP BY 写错,而是结果集里本来就没有那些日期。本文分别整理 PostgreSQL 的 `generate_series`、MySQL/SQL Server/Oracle 的日历表方案,并说明周/月分组、性能和边界数据里最容易踩的坑。 按日期统计时,结果里少几天、少几周,很多时候并不是 `GROUP BY` 写错了,而是数据源里根本没有这些日期。
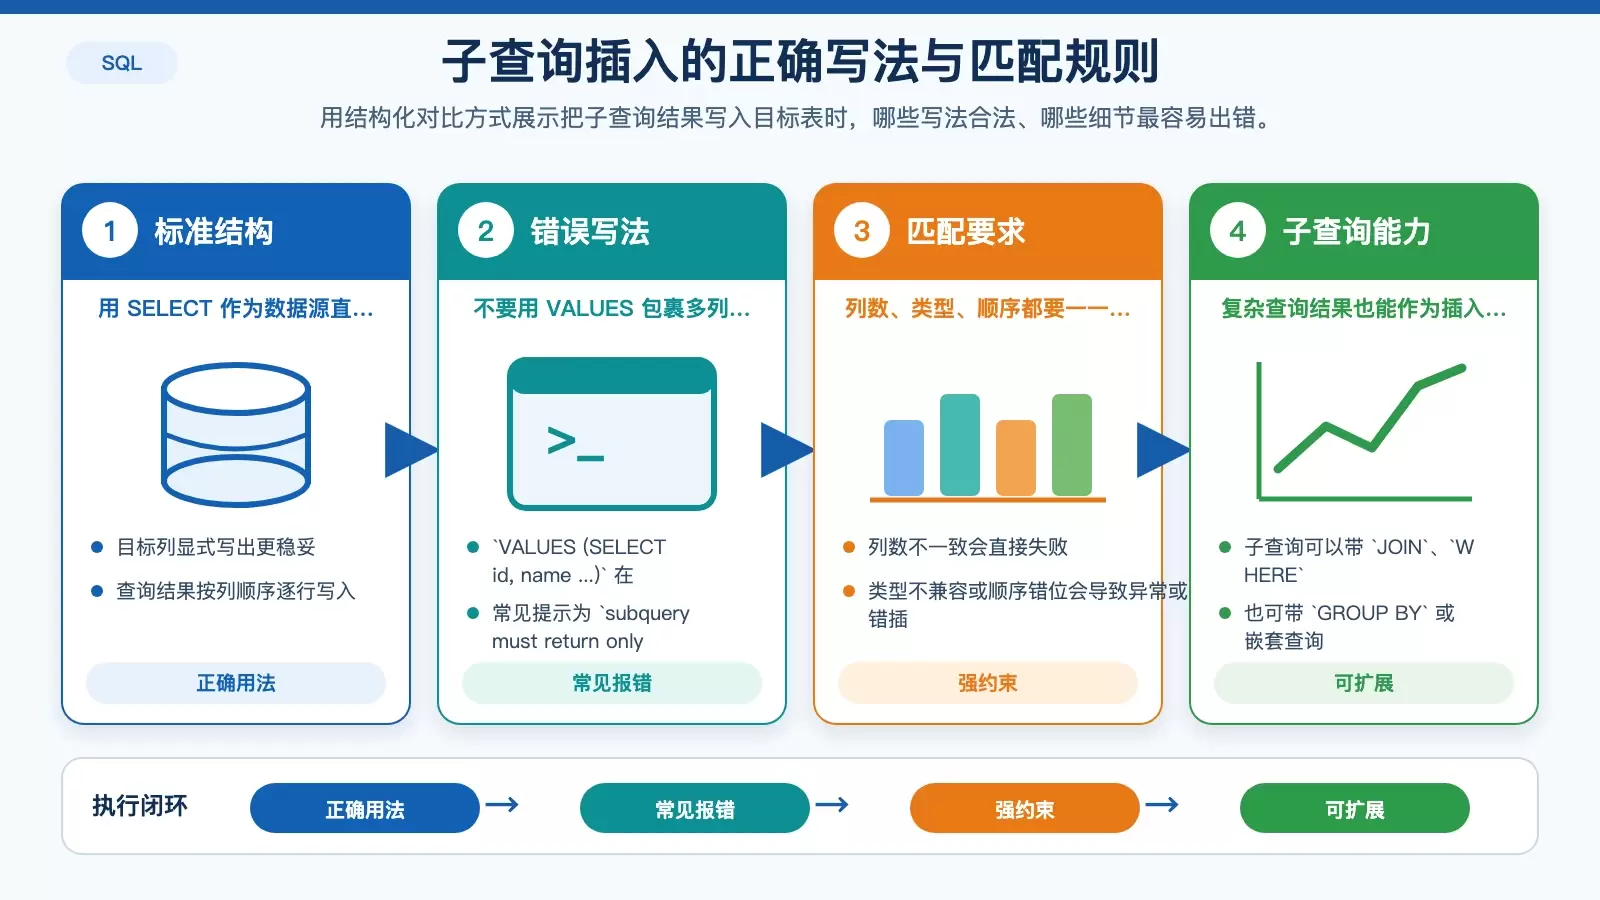
把子查询结果写入目标表,最稳妥的做法是 `INSERT INTO ... SELECT`。这类语句语法不复杂,但列顺序、类型匹配、方言差异、锁行为和空结果处理都很容易踩坑,文章将按写法、兼容性、性能与排错四部分梳理清楚。
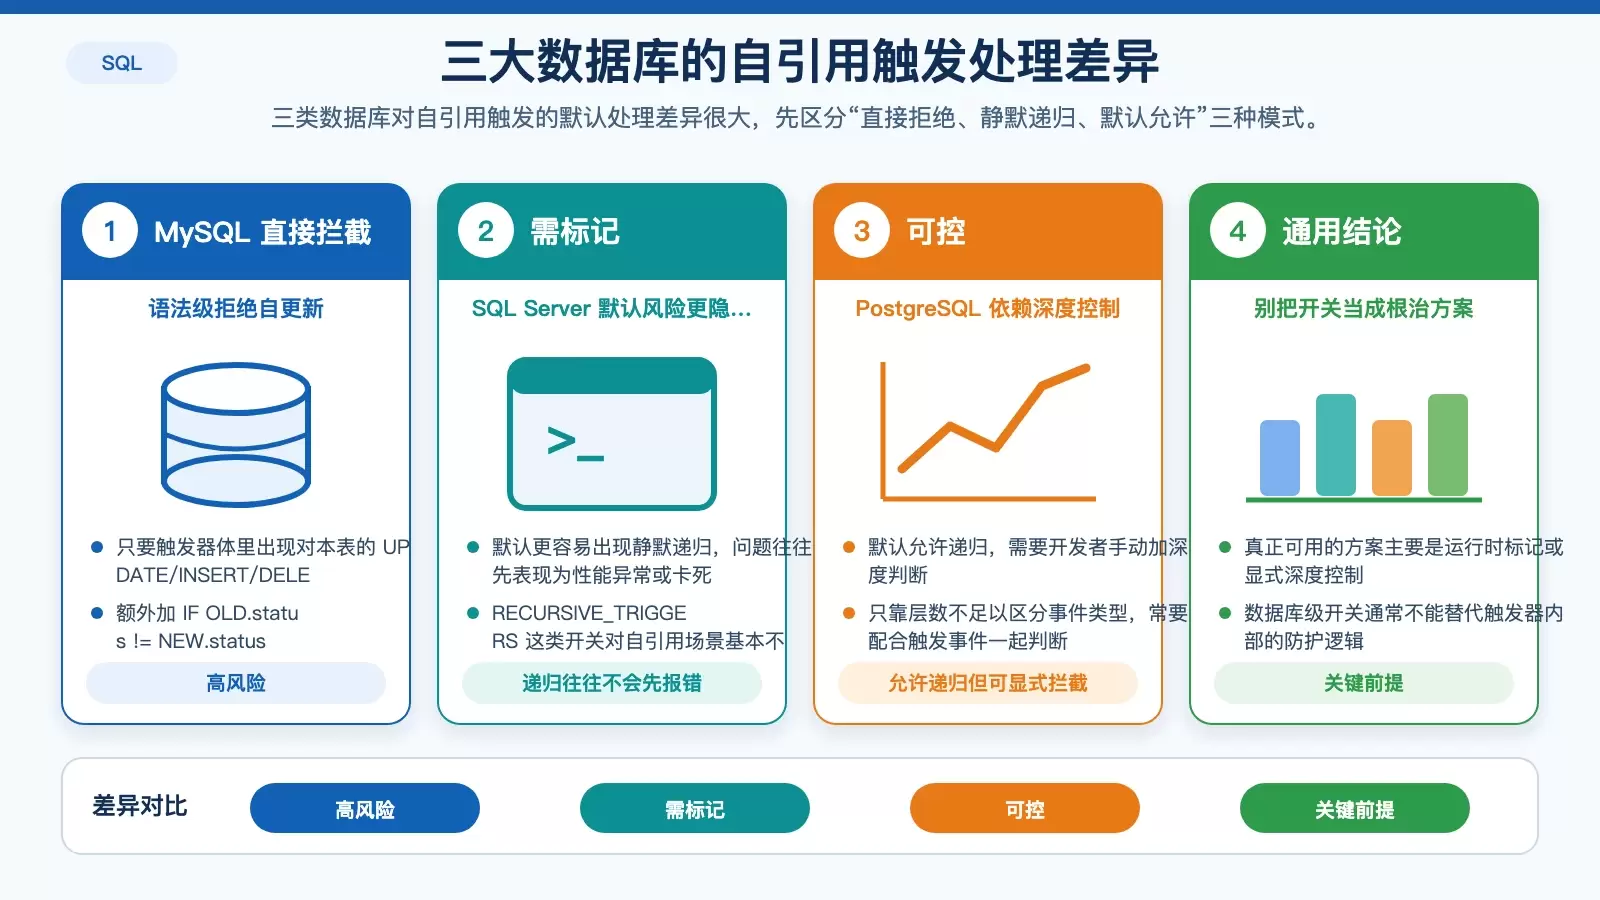
SQL 触发器一旦回写自身监听的表,三大数据库的表现并不一样:MySQL 直接报 `ERROR 1442`,SQL Server 可能静默递归,PostgreSQL 则默认允许但需要手动拦截。本文按数据库拆解限制、可行写法和容易踩坑的上下文污染问题。
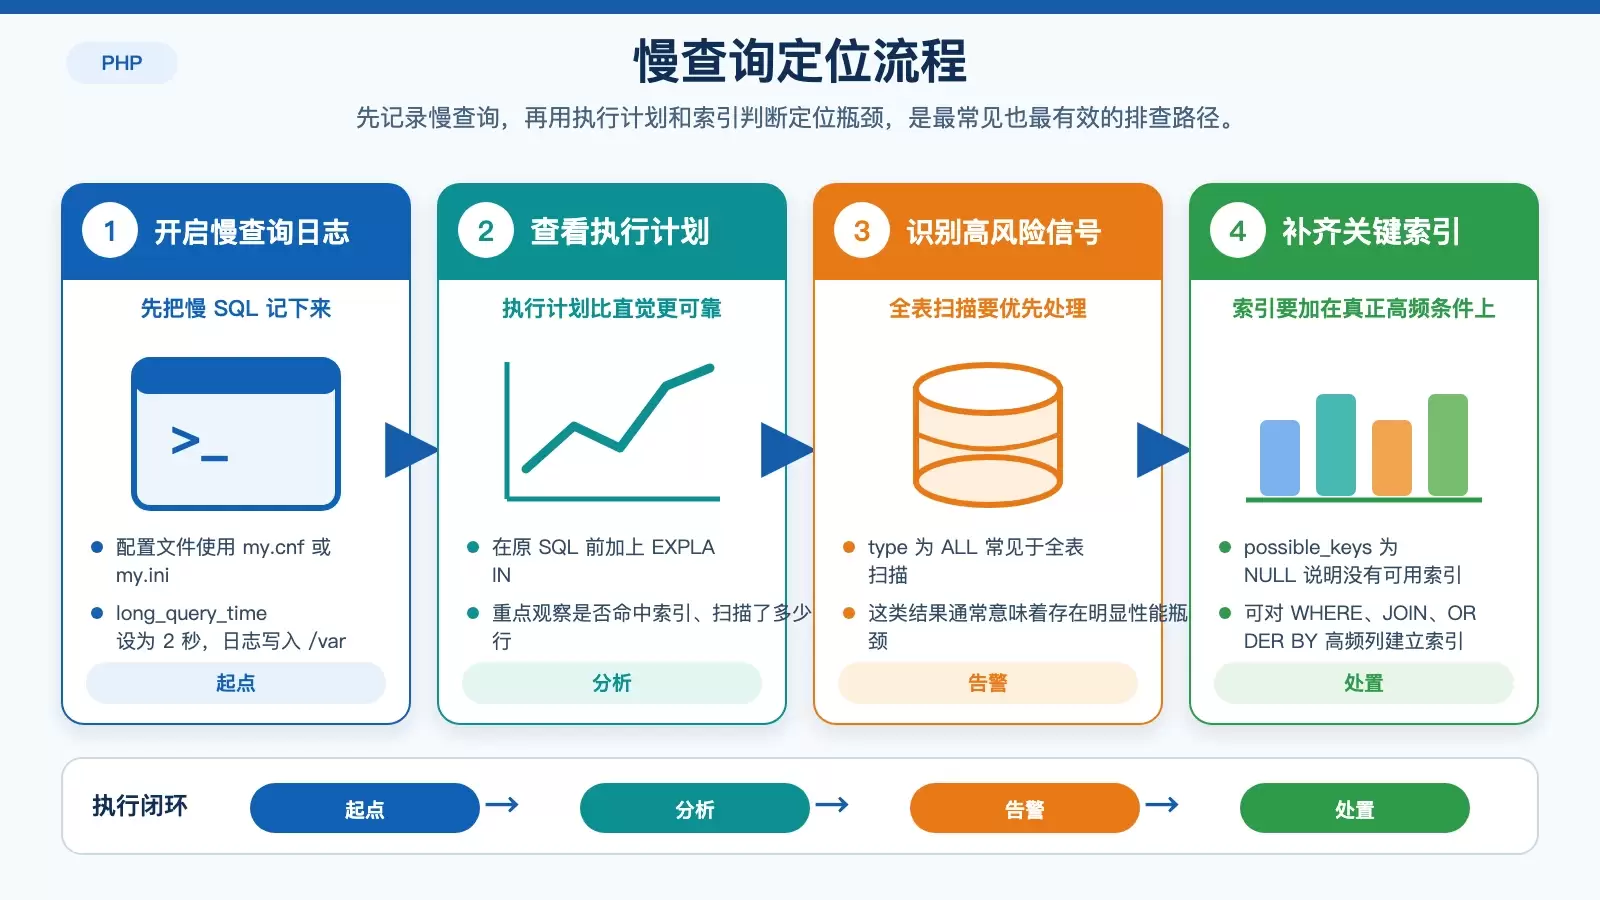
这篇文章围绕 Ubuntu 上 PHP 应用的慢查询治理,梳理了一套从日志开启、执行计划分析到索引、SQL 写法、连接复用与缓存落地的优化路径,并补充了大表处理和持续监控的判断要点,适合作为日常排查与优化清单。