


在 SQL 里给 NULL 设置默认值,看起来只是一个很小的语法问题,但一旦涉及跨数据库、字段类型不一致,或者查询已经跑在大表上,写法差异就会直接影响可移植性和执行性能。本文围绕 COALESCE 的几个高频使用场景展开,先讲它为什么适合作为默认首选,再说明哪些地方容易踩坑、怎样改写更稳,最后给出与 CASE 的分工边界,方便你在不同数据库里做出更可靠的判断。
为什么优先用 COALESCE
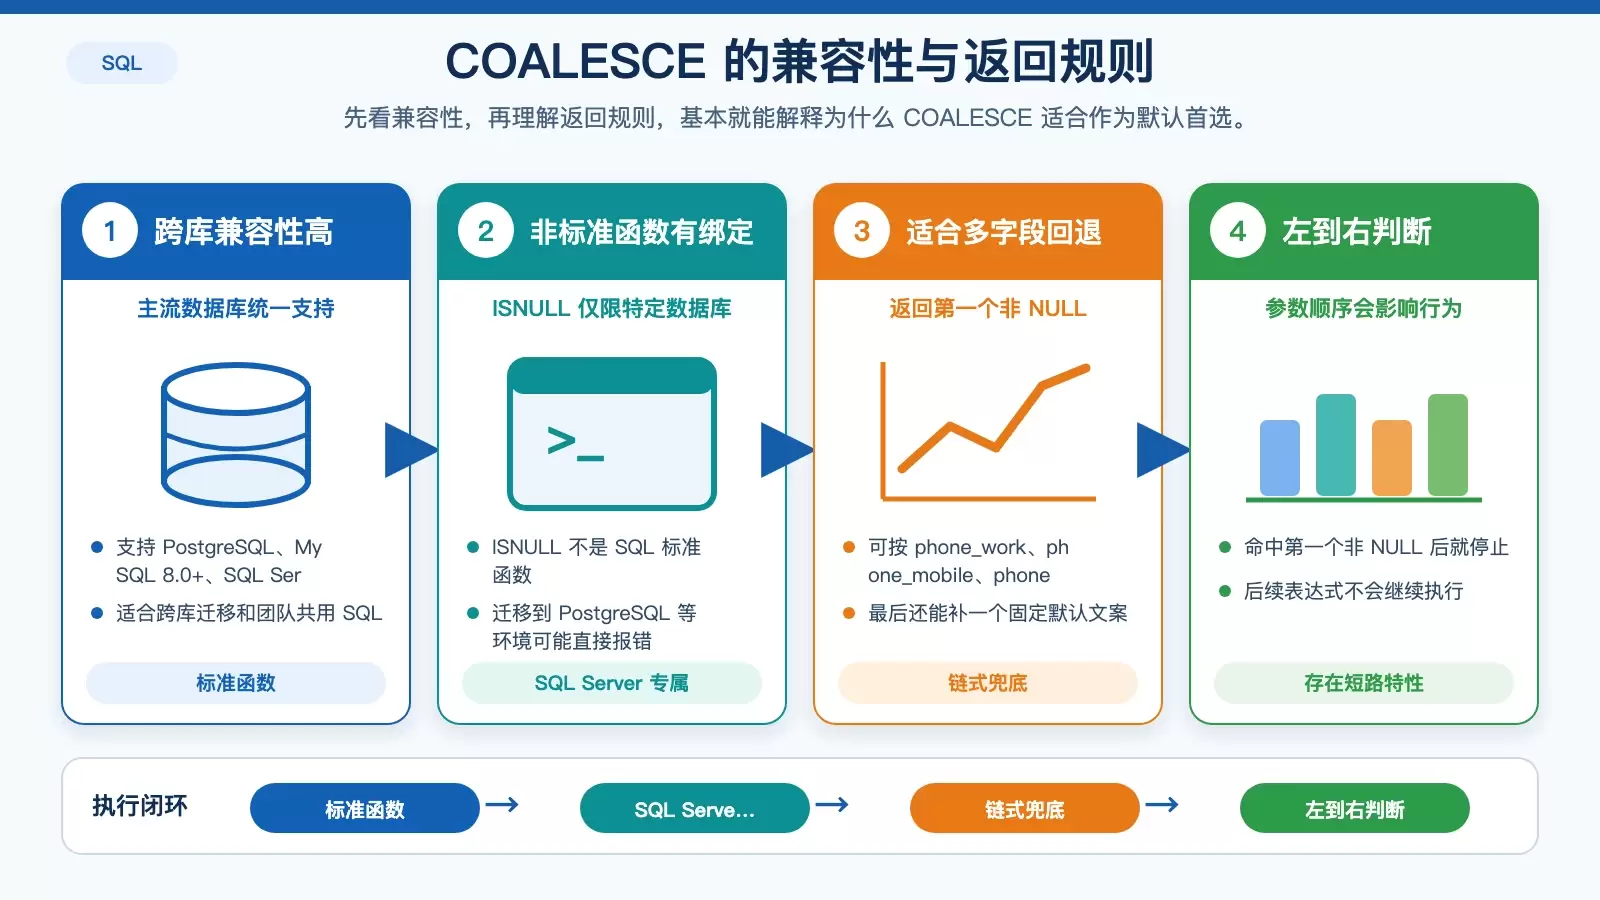
COALESCE 更值得优先考虑,核心原因不是“写起来顺手”,而是它属于 SQL 标准函数。像 PostgreSQL、MySQL 8.0+、SQL Server、Oracle、SQLite 这些主流数据库都支持它,在跨库迁移、多人协作或后续替换数据库时,出问题的概率会明显更低。
相比之下,很多看似相近的写法都有明显的数据库绑定:
ISNULL仅 SQL Server 支持IFNULL仅 MySQL 支持NVL主要是 Oracle 的写法
如果团队里有人直接写了 ISNULL(col, 'N/A'),这段 SQL 一旦放到 PostgreSQL 中执行,很可能就会直接报错:
ERROR: function isnull(unknown, unknown) does not exist从行为上看,COALESCE 的逻辑也很直观:返回从左到右第一个非 NULL 的表达式,因此非常适合做链式兜底。
SELECT COALESCE(phone_work, phone_mobile, phone_home, '未提供联系方式') AS contact FROM customers;这类写法既能减少重复判断,也更容易让别人一眼看懂你的默认值策略。
参数类型为什么必须提前对齐
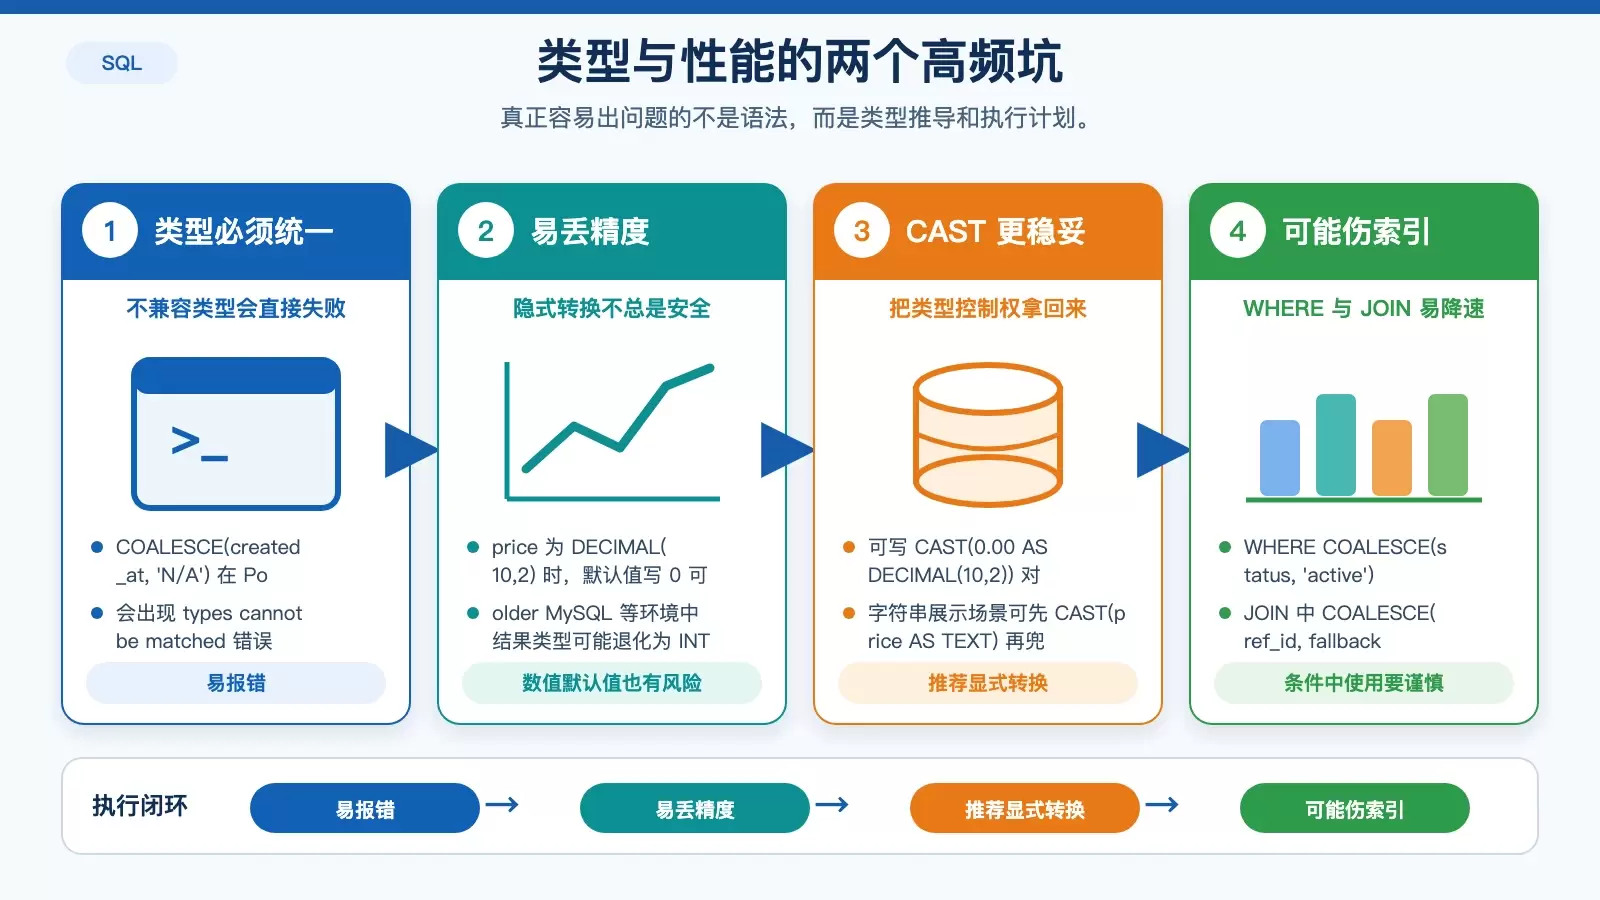
很多人第一次用 COALESCE 时,只注意到“谁是空值就替换谁”,却忽略了它对参数类型有要求。COALESCE 的所有参数最终都要被推导到同一数据类型,数据库通常会按第一个非 NULL 参数的类型,或按内部类型优先级来决定结果类型。这里如果混用不兼容类型,要么隐式转换,要么直接报错。
典型报错场景
例如下面这类写法,在 PostgreSQL 中就会失败,因为 timestamp 和 text 无法直接合并:
COALESCE(created_at, 'N/A')报错信息是:
ERROR: COALESCE types timestamp without time zone and text cannot be matched另一个更隐蔽的问题是数值精度。像 COALESCE(price, 0) 看起来没问题,但如果 price 是 DECIMAL(10,2),而 0 是整数,某些数据库(如 older MySQL)可能把结果推成 INT,导致小数位丢失。
更稳妥的写法
最保险的办法是显式把默认值对齐到目标类型,而不是把类型推导交给数据库“猜”。
SELECT COALESCE(price, CAST(0.00 AS DECIMAL(10,2))) AS price FROM products;如果业务上允许统一转成字符串展示,也可以先转型再兜底:
SELECT COALESCE(CAST(price AS TEXT), '0.00') AS price_str FROM products;判断原则很简单:只要默认值和原字段不是天然同类,最好显式 CAST 一次,避免后续在不同数据库里出现行为差异。
在 WHERE 和 JOIN 中为什么要慎用
COALESCE 放在查询结果列里通常问题不大,但放进 WHERE 或 JOIN 条件时,就要额外小心。原因不是语法错误,而是它可能让优化器很难利用原本可用的索引,最终把简单查询拖成全表扫描或低效关联。
WHERE 条件里的索引问题
例如:
WHERE COALESCE(status, 'active') = 'active'这在逻辑上等价于:
WHERE status IS NULL OR status = 'active'但很多数据库在遇到前一种写法时,未必还能高效使用 status 上的索引。为了让执行计划更可控,通常建议直接拆开写:
WHERE (status = 'active' OR status IS NULL)这样表达更明确,也更有机会保留索引可用性。
JOIN 条件里的 SARGable 问题
同样的风险也会出现在关联条件里。例如:
ON t1.id = COALESCE(t2.ref_id, t2.fallback_id)这类表达式会让关联条件失去 SARGable 特性,执行时往往更容易走嵌套循环、临时表,或者其他代价更高的方案。也就是说,COALESCE 虽然省了几行 SQL,但可能把性能换掉了。
实践里可以优先考虑把逻辑拆开,或者提前在数据整理层完成字段归一,而不是把兜底逻辑直接塞进关联条件。
什么时候该改用 CASE
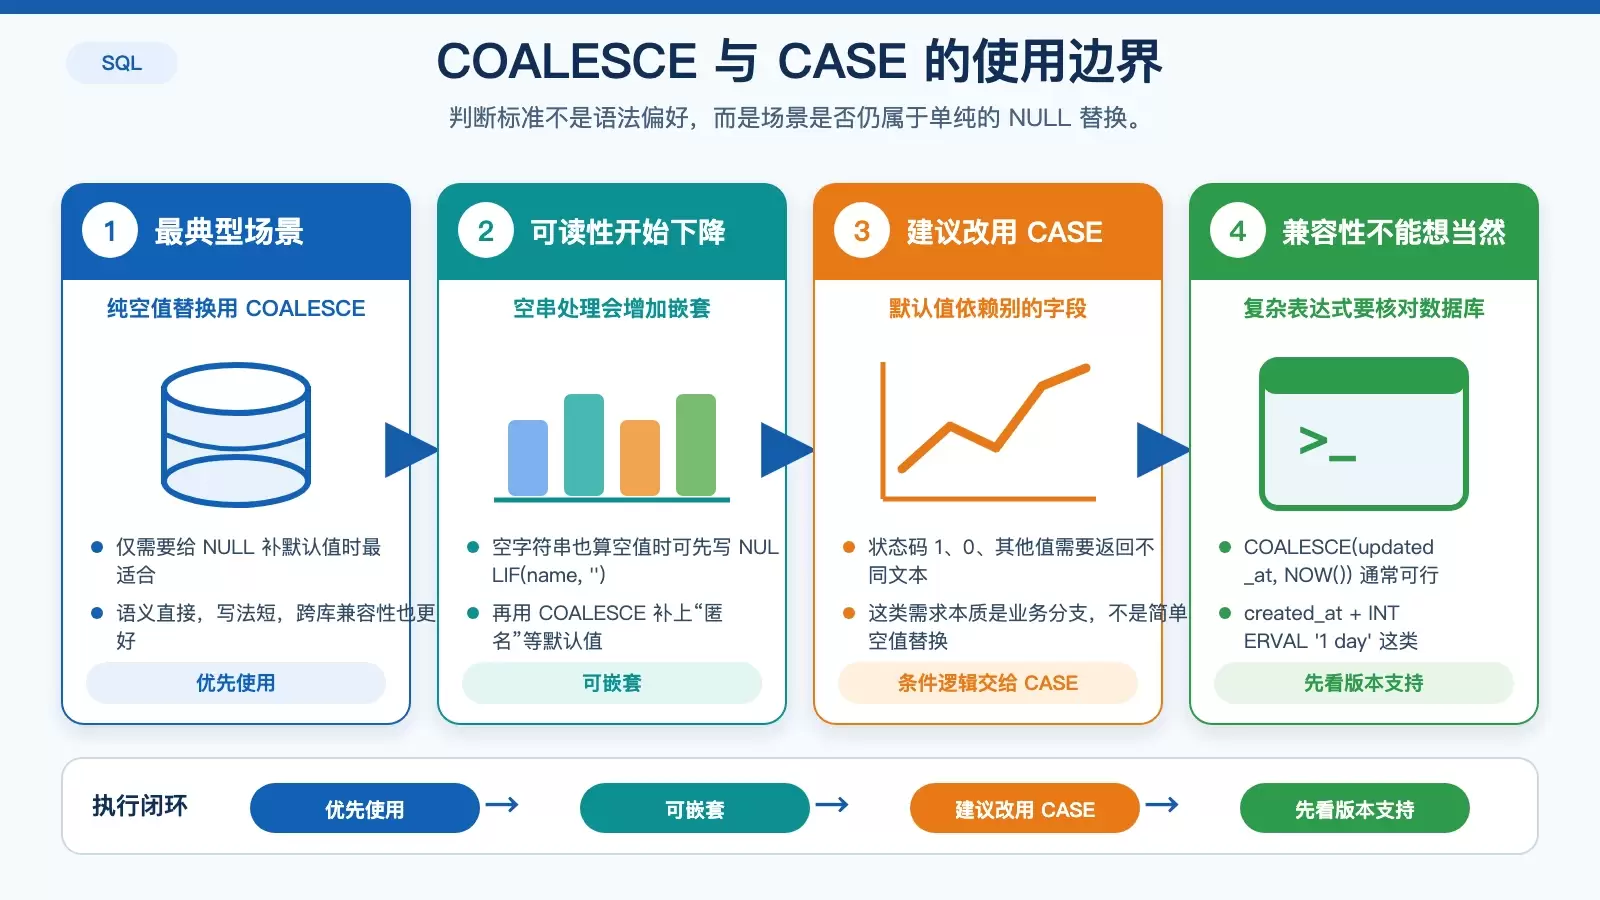
COALESCE 适合做“纯 NULL 替换”,但一旦默认值依赖别的字段、需要条件判断,或者 NULL 只是整段逻辑的一部分,CASE 往往更清晰,也更容易维护。
空字符串也要算空值时
如果你希望把空字符串一并当成空值处理,可以这样写:
COALESCE(NULLIF(name, ''), '匿名')这当然可行,但已经出现嵌套。表达式继续变长后,可读性会明显下降。
默认值依赖业务状态时
例如需要按状态码返回不同结果:
CASE WHEN code = 1 THEN '启用' WHEN code = 0 THEN '停用' ELSE '未知' END这种情况本质上不是“空值替换”,而是业务分支判断,直接用 CASE 更自然,硬套 COALESCE 反而会让逻辑变绕。
涉及表达式和函数调用时
COALESCE(updated_at, NOW()) 这类写法一般没有问题,但如果进一步写成 COALESCE(updated_at, created_at + INTERVAL '1 day'),部分数据库(如 older MySQL)对这类表达式参数的支持并不一致。遇到兼容性要求较高的环境,最好先确认目标数据库版本,再决定是否保留这类写法。
可以把选择标准记成一句话:纯 NULL 替换优先用 COALESCE;涉及逻辑分支、混合判定或更细的类型控制时,用 CASE 更稳。
别忽略求值顺序和短路特性
COALESCE 还有一个很容易被忽略的点:它会从左到右依次计算参数,遇到第一个非 NULL 就停止,后面的表达式不会继续执行。
这意味着参数顺序本身就是设计的一部分。把成本低、命中率高的字段放前面,通常更合理;如果后面跟着函数调用、复杂表达式甚至子查询,也不能想当然地认为它们一定会被执行。
在简单查询里,这只是一个语义细节;但在包含计算代价或副作用风险的表达式中,它会直接影响性能判断和可读性。因此,写多个候选参数时,不只是“能运行就行”,还要考虑顺序是否符合业务优先级。









