


用 ROW_NUMBER() 做分页时,最让人困惑的问题往往不是查不出来,而是“上一页最后一条,下一页又出现一次”。这类重复通常不是数据库出错,也不只是 SQL 写法细节,而是分页逻辑里少了“稳定定序”这一层约束。下面按结果稳定性、查询写法、索引匹配和参数边界四个方面拆开讲,帮助你判断问题到底出在哪一层。
为什么 ROW_NUMBER() 分页会出现重复数据
根本原因通常不是 ROW_NUMBER() 本身,而是 ORDER BY 字段不唯一。只要排序字段里存在重复值,数据库每次执行时就可能为这些“并列行”分配不同的物理顺序,最终让同一条记录的 rn 发生漂移。
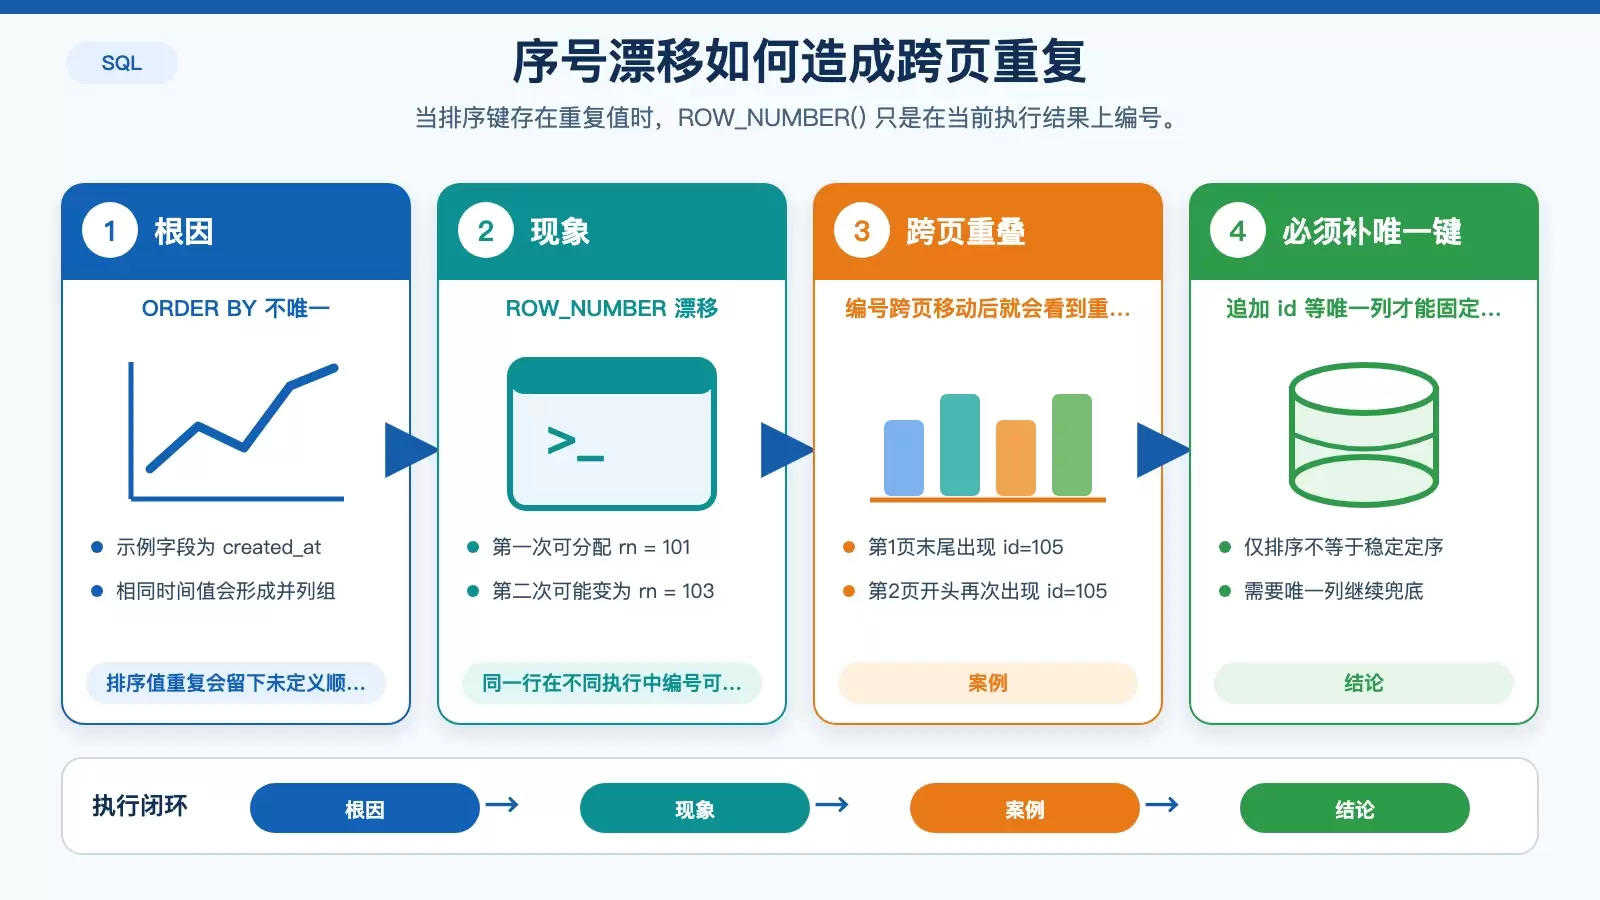
例如多个订单的 created_at = '2026-08-10 14:30:00',数据库只能保证它们按 created_at 这个值参与排序,却不保证这些相同时间的记录彼此之间谁先谁后。这不是 bug,而是 SQL 标准允许的未定义行为。
- 第一次查询时,可能把
id = 105排在同时间组第 1 位,分配rn = 101 - 第二次查询时,它又可能被排到第 3 位,变成
rn = 103 - 最终现象就是:第 1 页末尾出现
id=105,第 2 页开头又出现id=105
所以要先明确一点:ORDER BY 只能完成“排序”,不一定能完成“定序”。只有在排序条件最后补上唯一列兜底,例如 id,每一行在逻辑序列里才有确定位置。
先解决排序不稳定:给 ORDER BY 加唯一列兜底
如果当前分页 SQL 只写了类似下面这种排序:
ORDER BY created_at DESC那么在 created_at 重复的情况下,分页结果天然不稳定。更稳妥的做法是把唯一列追加到排序尾部,形成完整定序:
ORDER BY created_at DESC, id DESC这样处理后,即使多条记录的 created_at 完全相同,数据库也可以继续用 id 决定先后顺序,避免 ROW_NUMBER() 在多次执行之间漂移。
这一步看起来只是多写一个字段,实际决定的是分页结果是否可复现。只要业务允许,兜底列就应该选真正唯一且稳定的字段,而不是另一个也可能重复的业务字段。
正确写法:先编号,再在外层按 rn 取页
另一个常见问题,是把 rn 的过滤条件放在错误层级。很多人会直接在窗口函数同层写 WHERE rn BETWEEN 21 AND 40,但在 SQL Server、PostgreSQL 这类数据库里,优化器通常不能把这个条件下推到窗口计算之前。
结果就是先对全表排序并编号,再从结果里过滤第 21 到 40 行。这样不仅性能差,还会把排序成本和内存压力放大,深分页时尤其明显。
更稳妥的写法是先用子查询或 CTE 生成 rn,再在外层过滤:
SELECT * FROM (
SELECT *, ROW_NUMBER() OVER (ORDER BY created_at DESC, id DESC) AS rn
FROM orders
) t WHERE t.rn BETWEEN 21 AND 40
这里有三个细节不要漏
rn的别名不能省,漏写会报Invalid column name 'rn'- 优先使用
BETWEEN 21 AND 40这种区间表达,别随手改成rn > 20 AND rn <= 40 - 部分优化器对
BETWEEN形式更容易识别 TopN 类优化意图
这里的重点不是语法能不能跑通,而是让“编号”和“取页”成为两个清晰阶段。这样更容易保证结果语义稳定,也更方便你继续检查执行计划。
索引必须和 OVER(ORDER BY ...) 对齐
即使你已经把排序写成了 ORDER BY created_at DESC, id DESC,如果没有匹配的联合索引,数据库仍可能走全表扫描,再额外执行内存排序 Sort。这会直接推高 I/O、内存 grant 和 tempdb 压力,页数越深越明显。
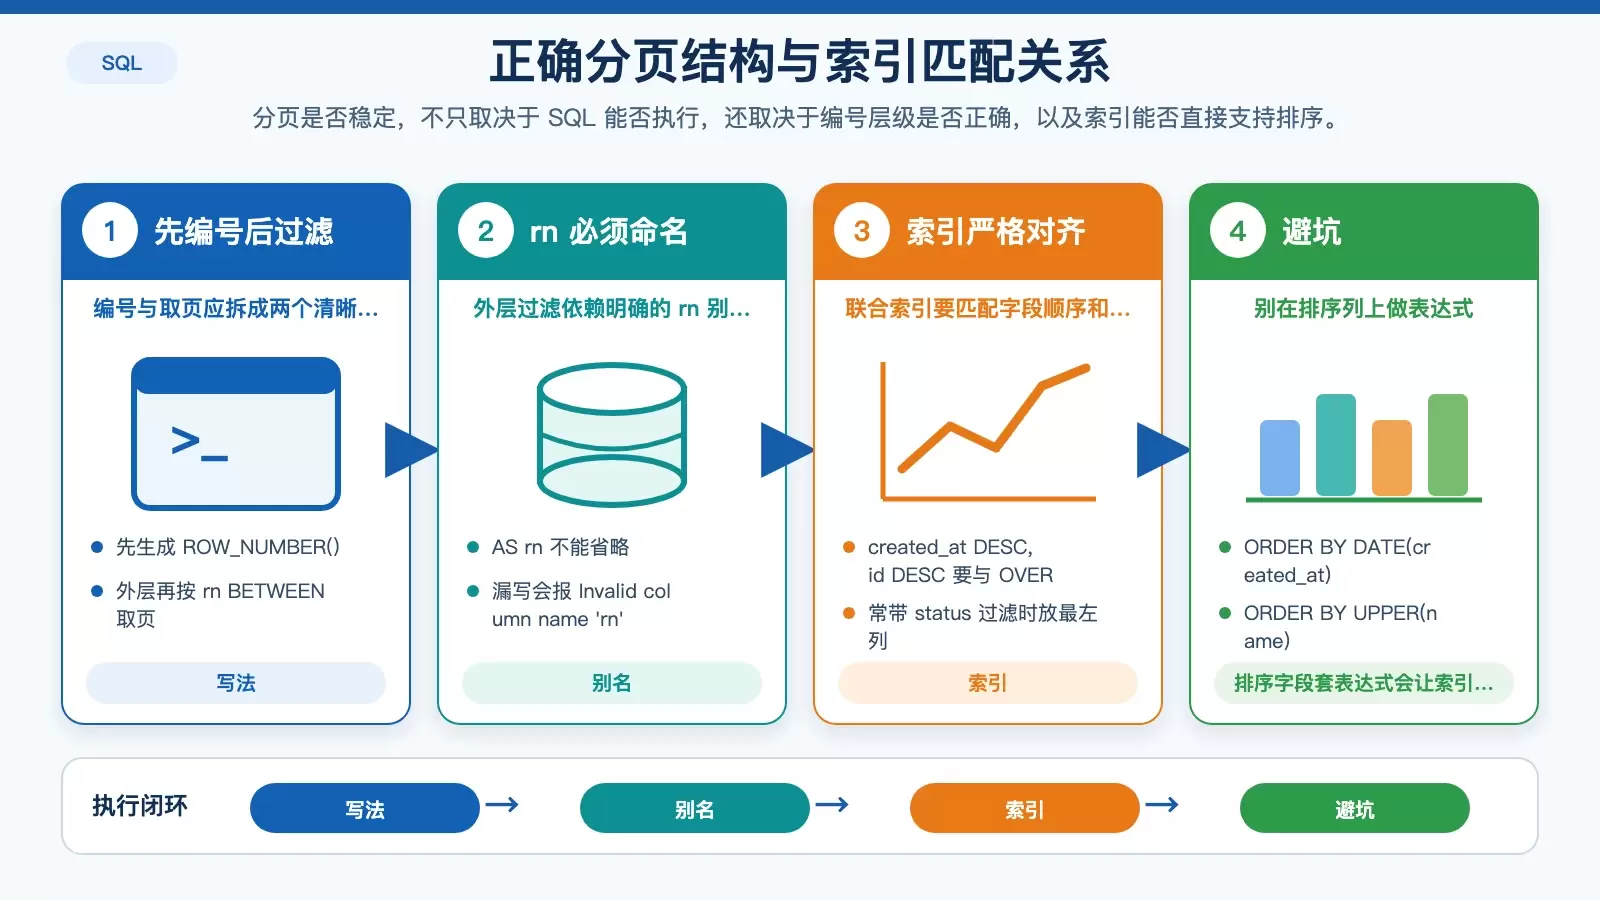
索引设计要严格跟随窗口函数里的排序字段、顺序和方向:
CREATE INDEX IX_orders_time_id ON orders(created_at DESC, id DESC)如果查询经常还会带上 WHERE status = 'paid',则应把过滤列放在最左侧:
CREATE INDEX IX_orders_status_time_id ON orders(status, created_at DESC, id DESC)三个常见失配点
- 索引字段顺序和
OVER中的排序顺序不一致 - 排序方向不一致,例如索引是升序、分页却按降序取值
- 在排序字段上套表达式,导致索引直接失效
尤其要避免这类写法:
ORDER BY DATE(created_at)
ORDER BY UPPER(name)
一旦排序字段被表达式包裹,数据库往往无法直接利用原始索引,只能退回到额外排序。这时你就算逻辑上已经“定序”了,性能上也会很难看。
别忽略分页参数:范围错了,rn 也会跟着错位
分页重复有时并不完全来自排序,还可能是页码和页长的参数计算已经越界。例如用户传入 @page_index = 0 或 @page_size = 1000,表达式 (@page_index - 1) * @page_size 可能得到负数,甚至超过 int 上限。
这样一来,后续分页区间就可能变成类似 rn BETWEEN -1 AND 99 的非法或异常范围,结果自然会出现偏移。
可以直接按下面方式做边界收口:
DECLARE @offset BIGINT = CAST(@page_index AS BIGINT) - 1DECLARE @page_index INT = ISNULL(NULLIF(@input_page, 0), 1)- 用
BIGINT参与偏移量计算,避免int溢出 - 把非法页码兜底到第 1 页,避免出现 0 页、负页
@page_size建议硬限制<= 100,防止恶意请求触发内存 grant 不足或排序溢出tempdb
这部分容易被忽视,因为 SQL 本身看起来是对的,但参数一旦越界,分页区间就已经失真,最终表现出来也可能是“为什么这一页和上一页对不上”。
排查这类问题时,重点看这四件事
如果你正在处理线上分页重复、跨页重叠或深分页变慢,可以按下面顺序快速核对:
- 检查
ORDER BY是否以唯一列兜底,例如created_at DESC, id DESC - 确认
ROW_NUMBER()放在子查询或 CTE 中,外层再按rn过滤 - 确认联合索引是否与
OVER(ORDER BY ...)的字段、顺序、方向一致 - 检查
@page_index、@page_size的边界和偏移量计算是否存在溢出或越界
最关键的判断标准只有一个:你的分页语句是否真的为每一行建立了稳定、唯一、可复现的逻辑顺序。只要这一步没做完整,哪怕 SQL 能跑、索引也存在,ROW_NUMBER() 分页依然可能出现重复数据。









