


按天、按周或按月统计数据时,很多人第一反应是继续改 GROUP BY,但图表里缺失的日期往往并不是分组语法问题,而是源数据里根本没有对应的记录。要想让结果连续可用,关键是先补齐日期范围,再把聚合结果挂上去。
这篇文章按数据库能力拆开讲:PostgreSQL 可以直接用 generate_series,没有这个函数的数据库则更适合走日历表方案。后面还会补充周/月分组时的对齐规则,以及高频查询里该怎样控制范围和性能,方便你判断哪种写法适合自己的环境。
为什么按日期分组后还会缺日期
只对原始数据做 GROUP BY,天然只能得到“实际存在过记录”的那些日期。某一天如果没有数据,结果集中就不会凭空出现这一行,所以统计图看起来就会断档。
这类问题本质上不是分组失败,而是数据源缺失。解决思路也很明确:先生成一段连续日期,再和原始表做关联,把没有命中的日期补成 0 或其他默认值。
PostgreSQL:用 generate_series 补全日期
在 PostgreSQL 里,最直接的办法就是用 generate_series 生成连续日期序列,再和原始数据做 LEFT JOIN。它不依赖源表是否有记录,因此能保证结果中每一天都出现一次。
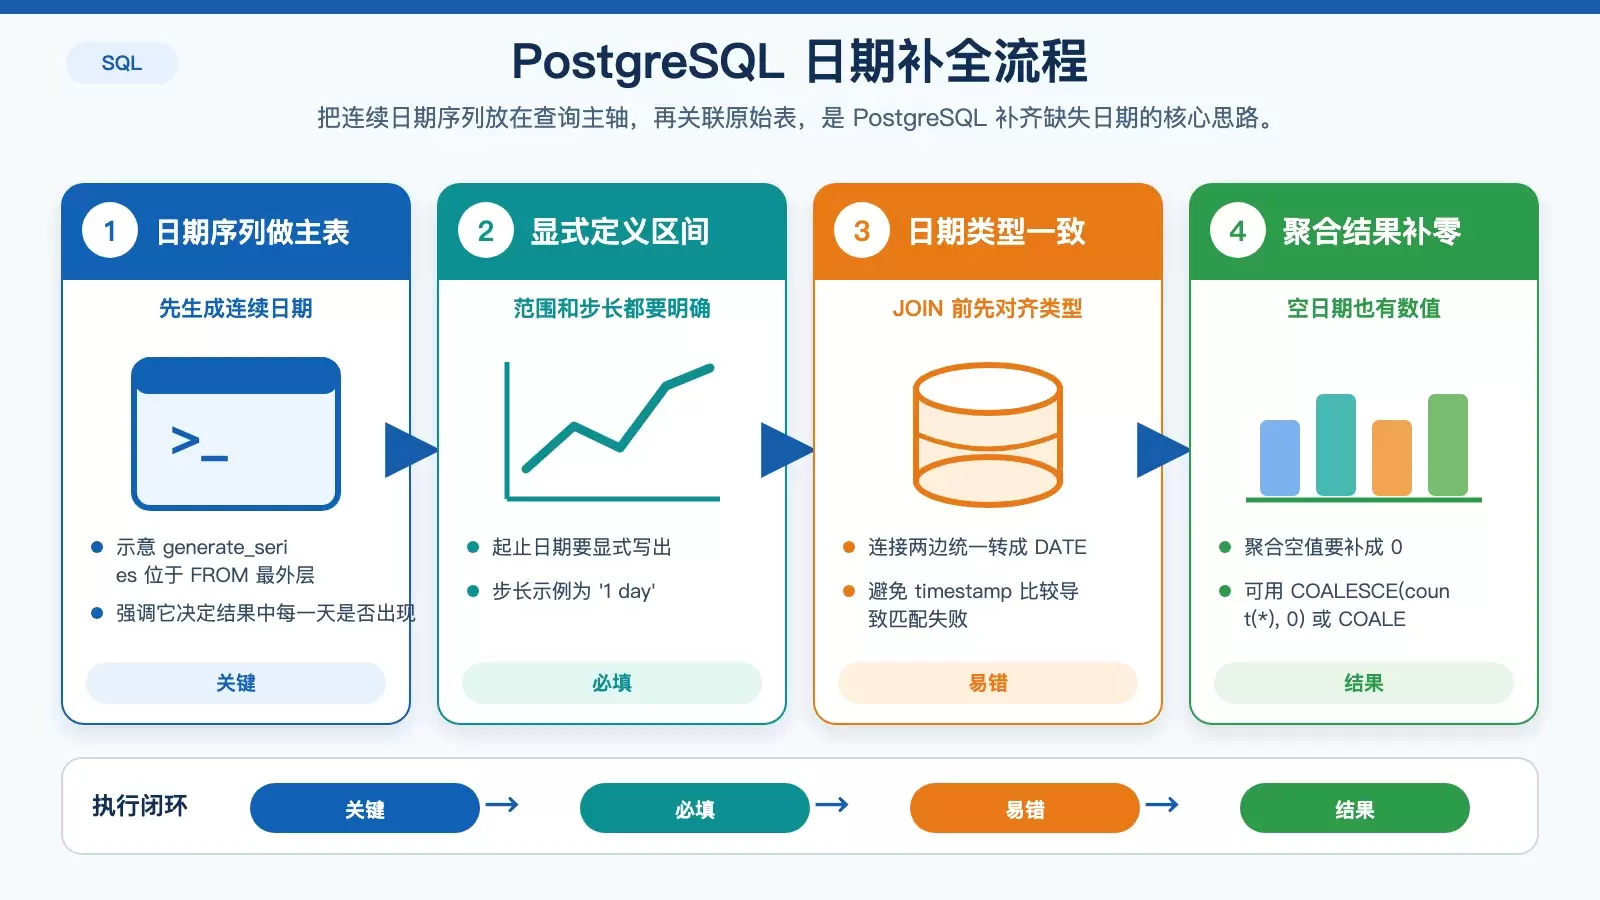
写法里的几个关键点
generate_series要放在FROM子句最外层,作为主表来驱动结果集。- 日期范围必须显式给出起止和步长,例如
generate_series('2024-01-01'::date, '2024-01-31'::date, '1 day')。 LEFT JOIN时,连接条件两边的类型要统一成DATE,避免timestamp比较后匹配失败。- 聚合结果要用
COALESCE(count(*), 0)或COALESCE(sum(...), 0)把空值补成0。
最常见的误区
不少人会直接在原表上按日期分组,然后再想办法“补显示”。这种做法补不出真正缺失的日期,因为查询从一开始就没有生成完整的日期集合。
更稳妥的方式,是先让日期序列成为查询的主轴,再把业务数据挂上去。这样无论某一天有没有订单、日志或事件,该日期都会先出现在结果里。
MySQL / SQL Server / Oracle:用日历表更稳
如果数据库没有 generate_series,生产环境里更推荐提前准备一张日历表,而不是每次临时拼日期,或者依赖递归 CTE 现算。
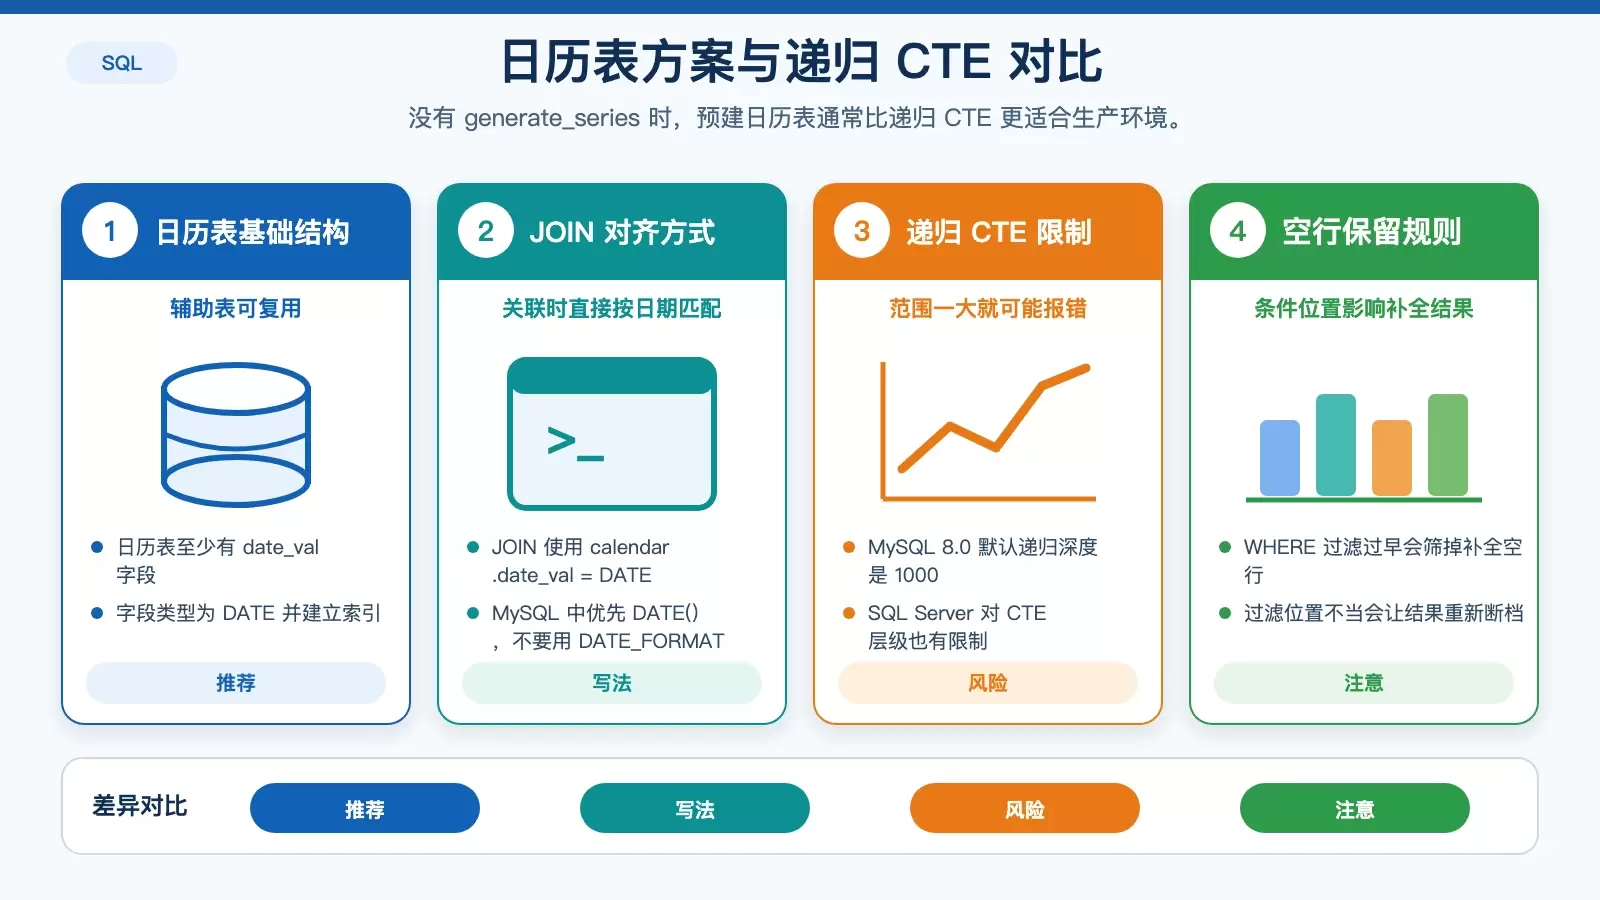
原因很简单:日历表稳定、可索引、可复用,执行计划也更可控。相比之下,动态递归生成日期在大范围查询里更容易触发限制和性能问题。
日历表至少要满足什么条件
- 至少包含一个
date_val字段,类型为DATE。 - 给
date_val建索引,保证关联效率。 - 关联时使用
calendar.date_val = DATE(your_table.created_at)。 - 在 MySQL 里,做日期对齐优先用
DATE(),不要用DATE_FORMAT做匹配。
为什么不建议大范围使用 WITH RECURSIVE
递归 CTE 看起来省事,但在生产环境里并不适合用来生成大范围日期。MySQL 8.0 的默认递归深度是 1000,SQL Server 对 CTE 层级也有限制,范围一大就可能直接报 Maximum recursion exceeded。
如果你的查询经常要补最近 30 天、90 天甚至 1 年的数据,预建日历表通常比递归方案更稳定,也更容易排查执行性能。
WHERE 条件放错位置,会把补齐结果过滤掉
这类查询里还有一个常见坑:把过滤条件写得过早,导致本来应该保留的“空日期行”被提前筛掉。原文强调,WHERE 过滤要放在 JOIN 之后,否则补全出来的空行会消失,最后结果又回到“不连续”的状态。
按周、按月分组时,先统一锚点
按天补齐相对直接,按周、按月时更容易出错。问题通常不在函数能不能跑通,而在“同一时间范围到底按什么规则对齐”。
按周分组为什么容易对不上
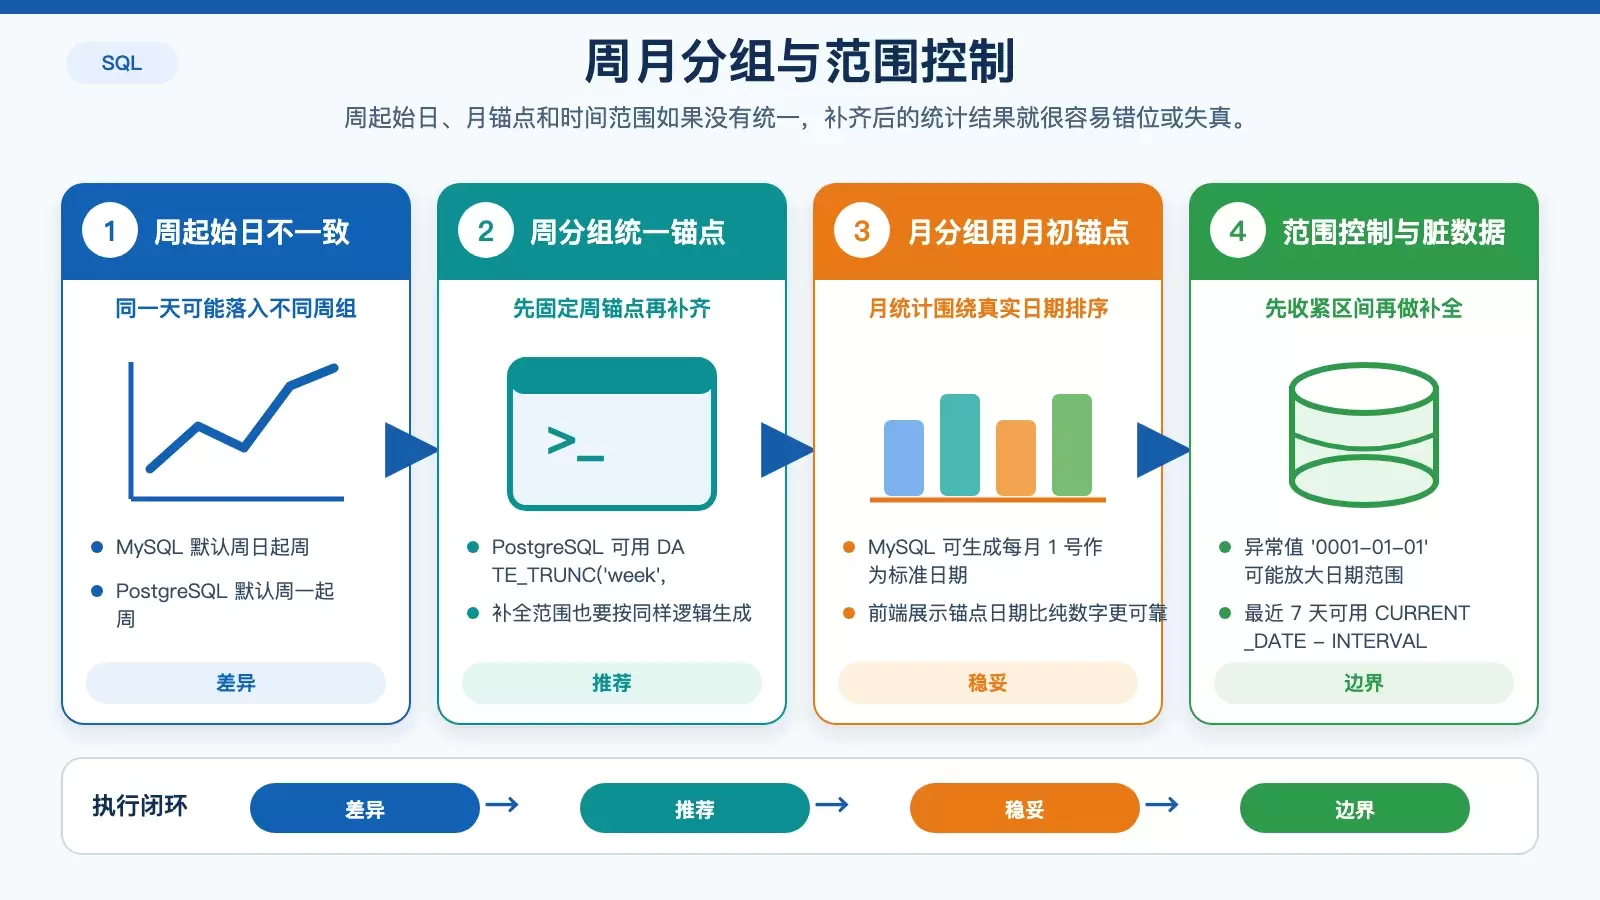
很多人会直接用 WEEK() 或 EXTRACT(WEEK FROM ...)。但不同数据库对周起始日的定义并不一致:MySQL 默认周日,PostgreSQL 默认周一。同一天在两个系统里可能落到不同周组,后续补全和展示自然会错位。
更稳的做法是统一生成“周锚点”后再分组。例如 PostgreSQL 可用 DATE_TRUNC('week', date_col),并且补全范围也要按同样逻辑生成,不能一边用自然周、一边用 ISO 周。
按月分组别只拼年份和月份
按月统计看起来简单,但直接 GROUP BY YEAR(date), MONTH(date) 容易让排序和补全逻辑变得混乱。比如 2024-12 和 2024-01 在某些字符串处理场景里看似相邻,时间顺序却并不连续。
更合适的方式,是统一生成每个月的标准锚点日期。MySQL 可用:
STR_TO_DATE(CONCAT(YEAR(date), '-', LPAD(MONTH(date), 2, '0'), '-01'), '%Y-%m-%d')这样无论是排序、补齐还是前端展示,都会围绕真实日期锚点展开,而不是依赖单独的月份数字。
前端展示时也是同样原则:每周一、每月 1 号这样的锚点日期,通常比单纯显示“第几周”“第几月”更可靠。
性能与边界情况要先限制范围
日期补全本质上是笛卡尔积思路的变体。范围一旦放大,数据量会迅速膨胀。比如补 1 年就是 365 行,再去关联百万级订单表,查询成本会明显上升,严重时还可能 OOM。
先过滤原始数据,再生成日期
真正容易拖垮查询的,往往不是 SQL 语法,而是时间范围没有提前收紧。一个典型风险是直接用 MIN(created_at) 和 MAX(created_at) 动态生成区间,但表里恰好有一条脏数据是 '0001-01-01',结果一下子生成了几千年的日期序列。
所以,务必在生成日期前先对原始数据做有效时间范围过滤,别把异常值带进补全过程。
高频查询适合提前汇总
- 对高频查询,可以把补全逻辑封装成物化视图或定时刷新的汇总表。
- 如果只关心最近 7 天或 30 天,优先使用动态表达式,例如
CURRENT_DATE - INTERVAL '6 days',而不是写死起止日期。
最后需要强调的是,日期补全看起来像展示层的小问题,实际上关系到数据完整性判断。漏掉的日期并不等于“当天一定是 0”,而是“当前结果无法证明当天有没有数据”。补得不准,比不补更危险。









