非科班转行数据分析的Python入门指南与路线
面向没有编程基础、准备转行数据分析的学习者,从Python环境与基础语法入手,逐步掌握数据处理、分析可视化和项目实战,并通过岗位技能要求验证学习成果,同时避开只学语法、忽视SQL和缺少项目经验等常见误区。
2026-09-08
4

面向没有编程基础、准备转行数据分析的学习者,从Python环境与基础语法入手,逐步掌握数据处理、分析可视化和项目实战,并通过岗位技能要求验证学习成果,同时避开只学语法、忽视SQL和缺少项目经验等常见误区。
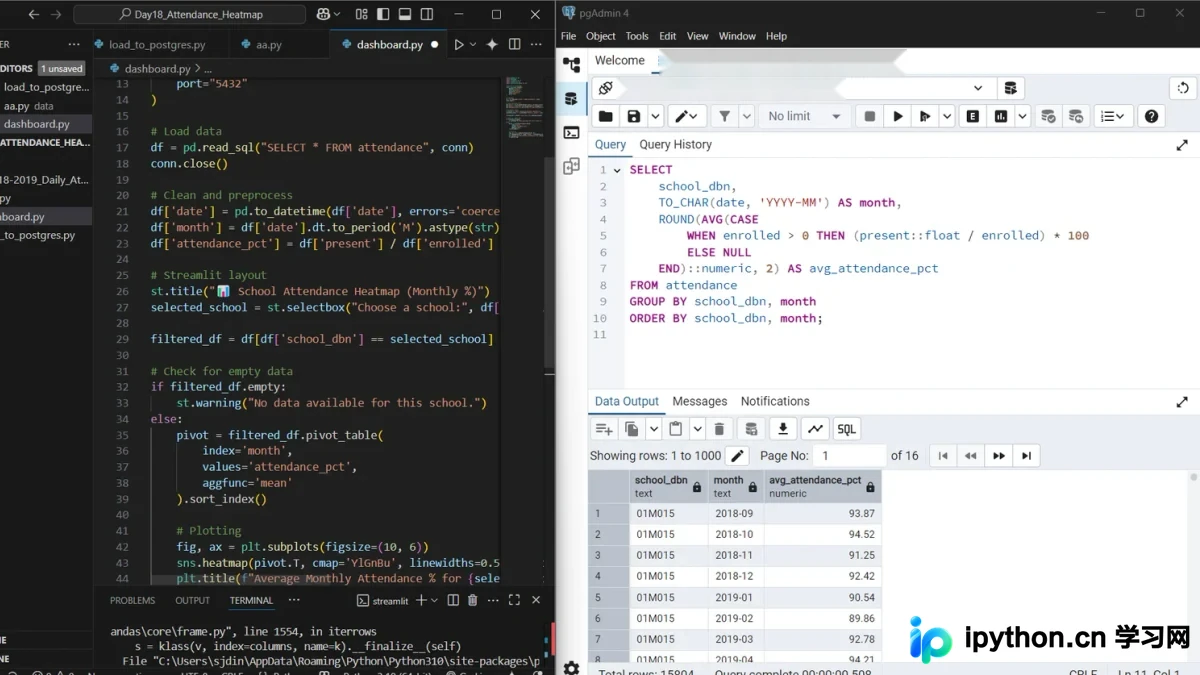
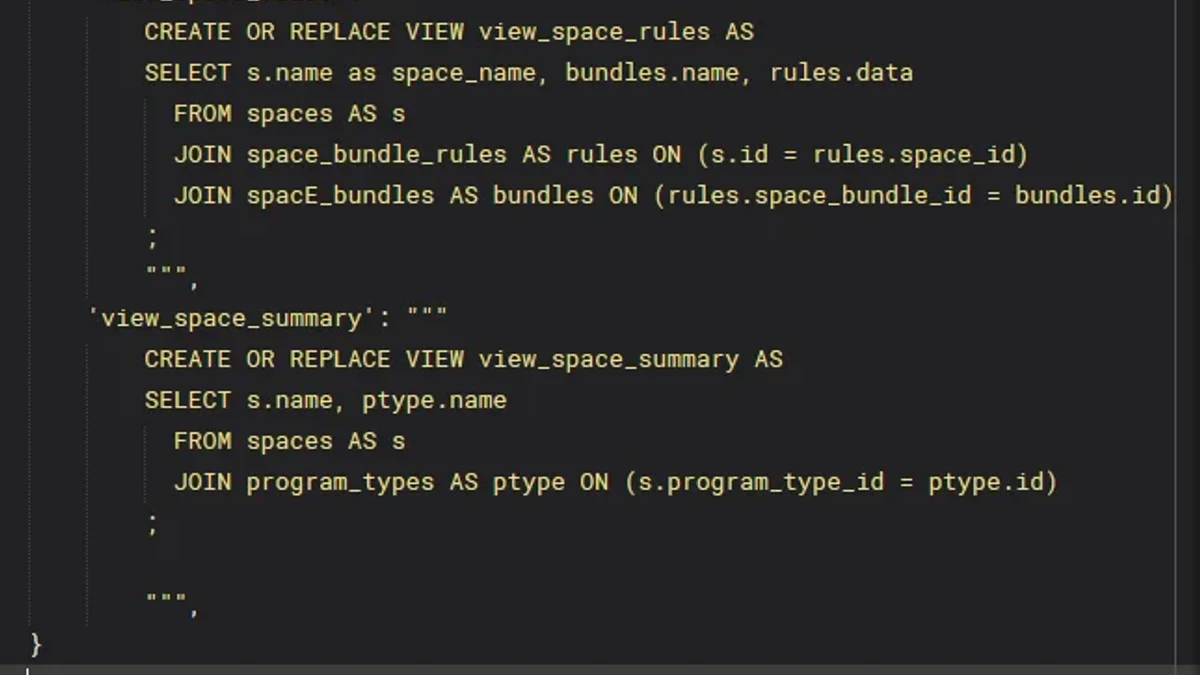
介绍Python使用三引号编写多行SQL语句时的缩进、换行、引号选择和格式控制方法,帮助避免SQL字符串中出现不必要的空格、换行和格式混乱。
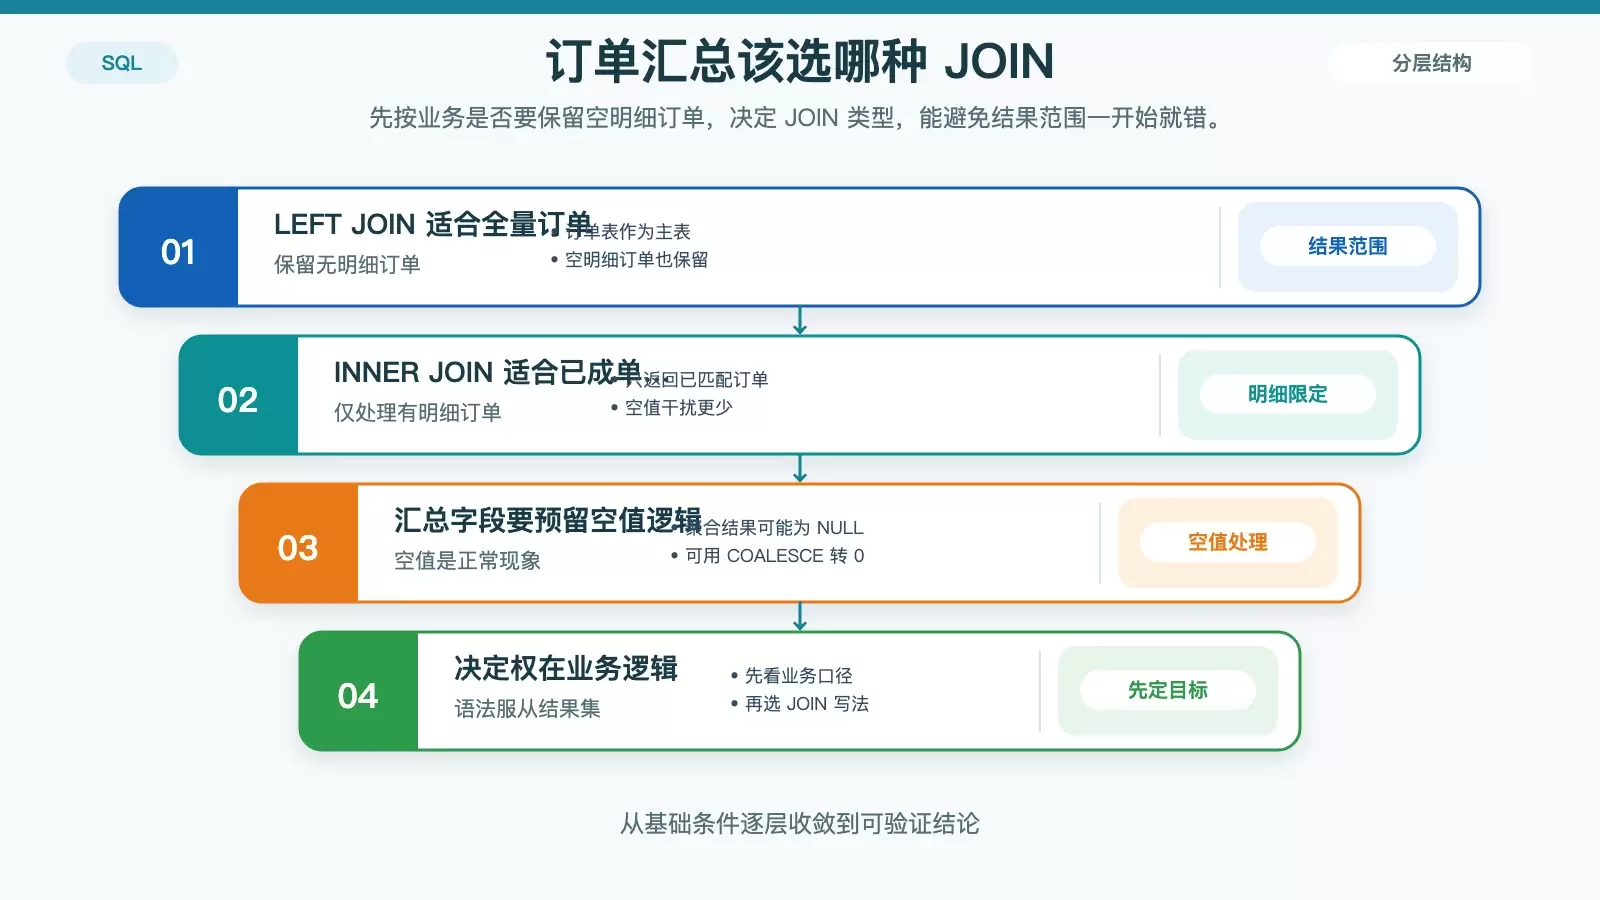
订单表和明细表做汇总时,难点通常不在 `SUM()` 本身,而在 JOIN 选择、`GROUP BY` 写法、重复关联放大和索引是否到位。本文按订单汇总的常见问题拆解,给出可直接落地的判断方式、排查 SQL 与性能优化重点。
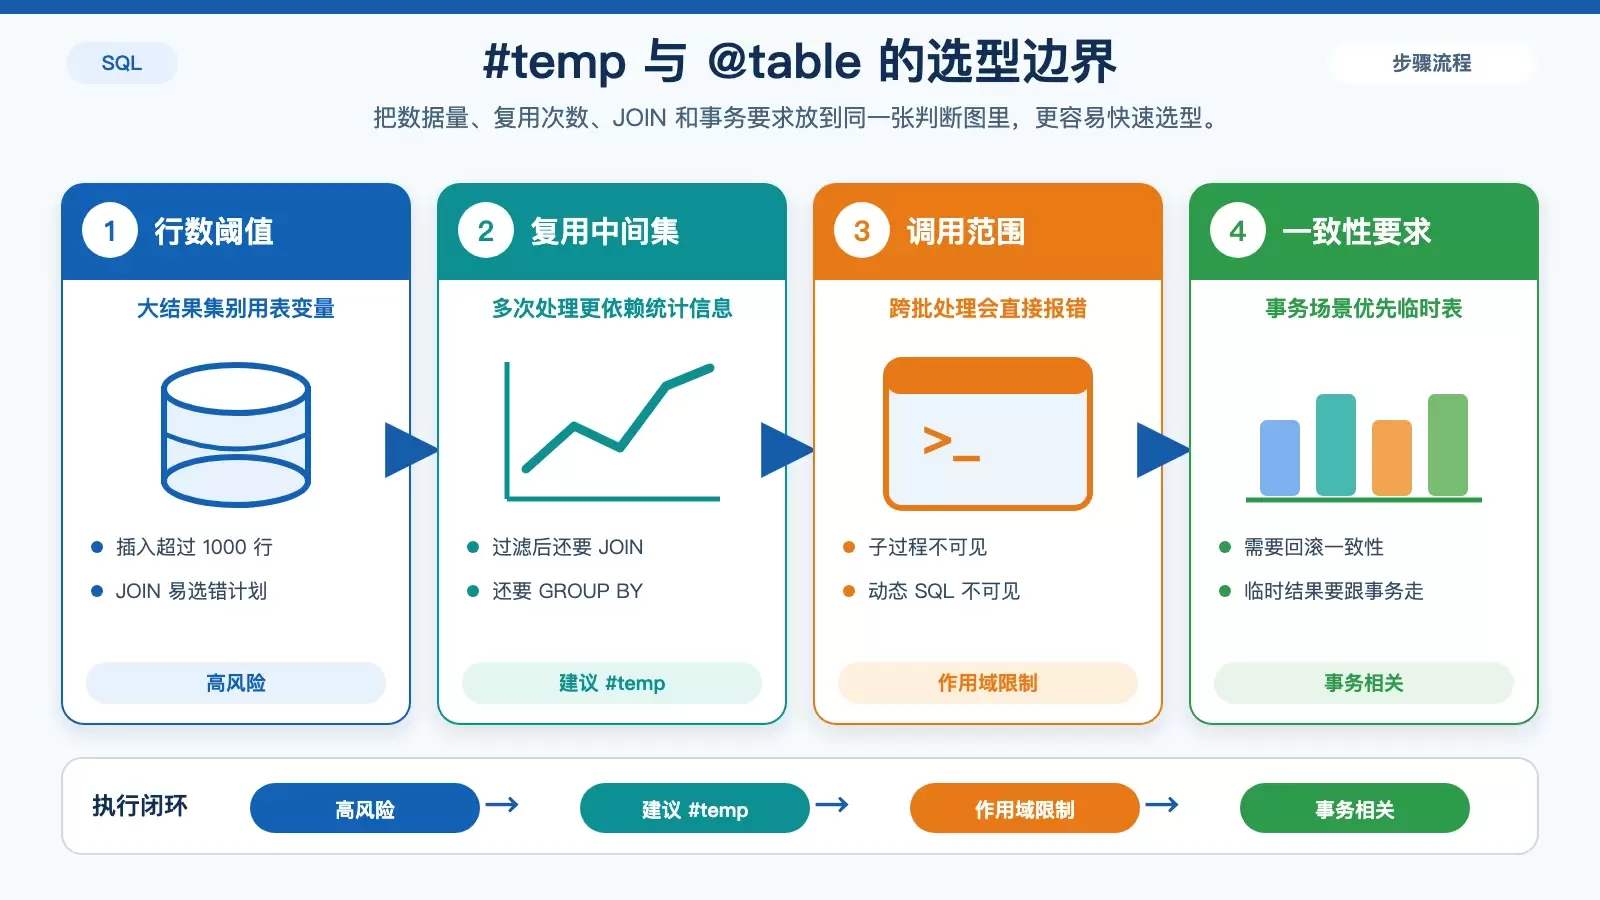
在 SQL Server 存储过程中,`#temp` 和 `@table` 不是随手替换的两种写法。判断关键不在“能不能存”,而在数据量、是否复用、是否参与 JOIN 与事务,以及优化器能否拿到统计信息;一旦越界,执行计划和作用域问题会直接放大。
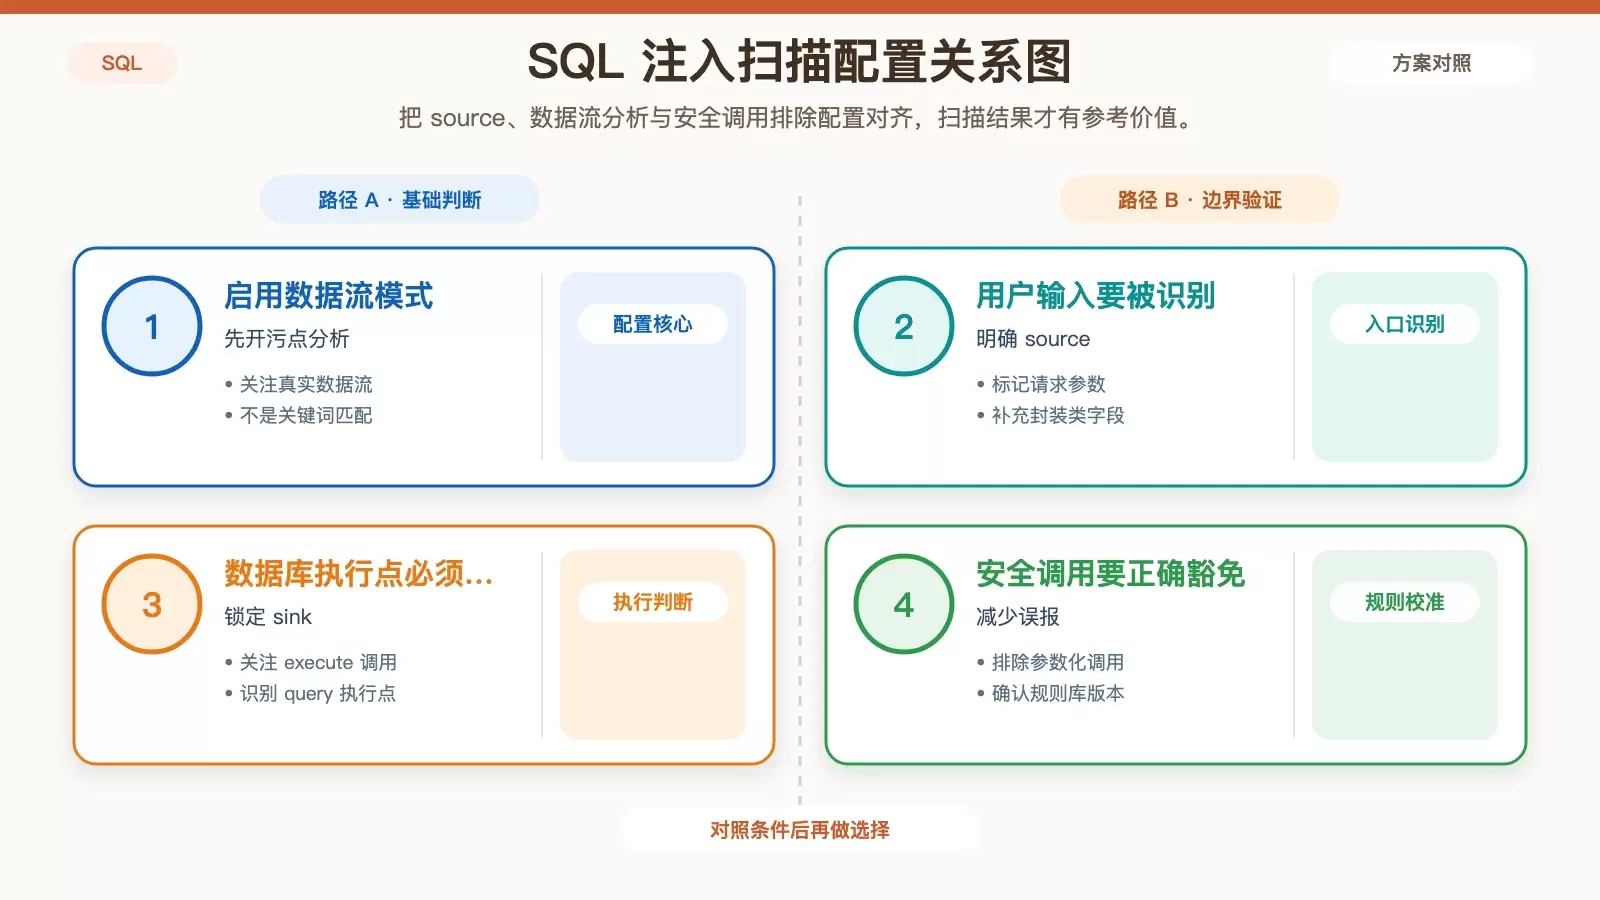
SAST 发现 SQL 注入,核心依赖 AST 分析和污点追踪:把用户输入一路跟到数据库执行点。但扫描结果并不能直接等同于漏洞结论,配置不完整会漏报,规则理解不到位也会误报。要把结果用起来,关键在于先配对 source、sink 和安全调用,再结合人工复核与 DAST 做交叉验证。
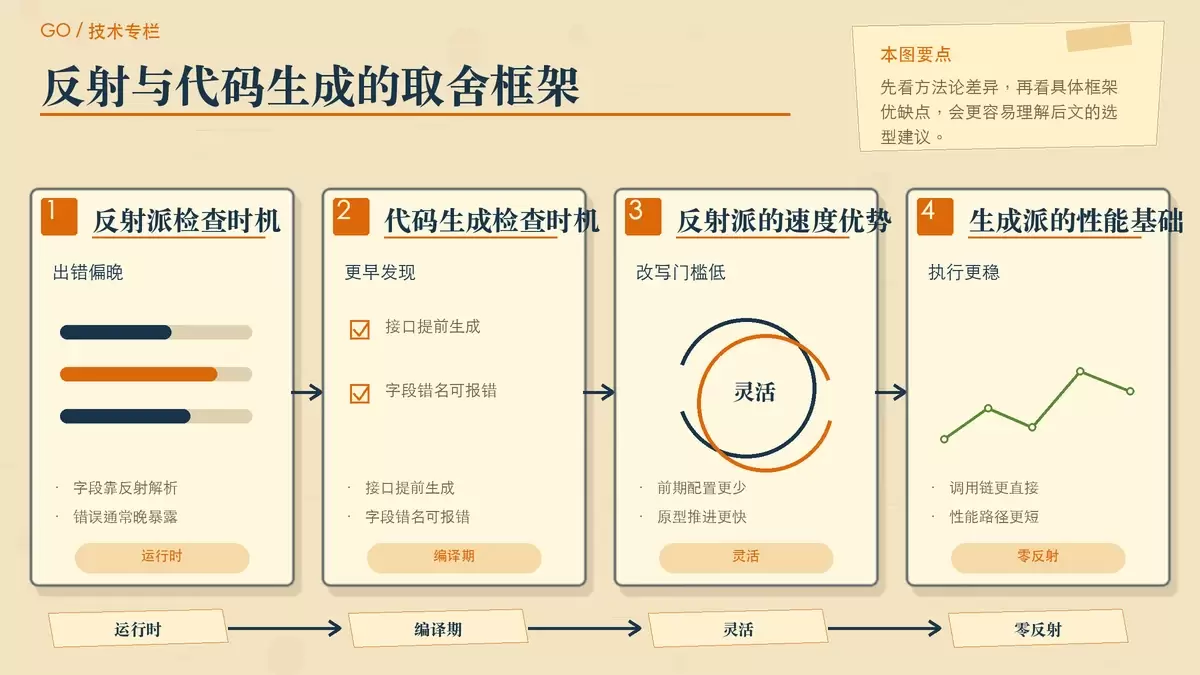
Go 数据库框架的争论,核心已经不只是 API 好不好用,而是运行时反射与编译期代码生成两条路线的取舍。把 GORM、Ent、SQLC 放到同一业务场景里比较后,可以更清楚地判断:你到底更需要上线速度、重构安全,还是对 SQL 与性能的绝对掌控。
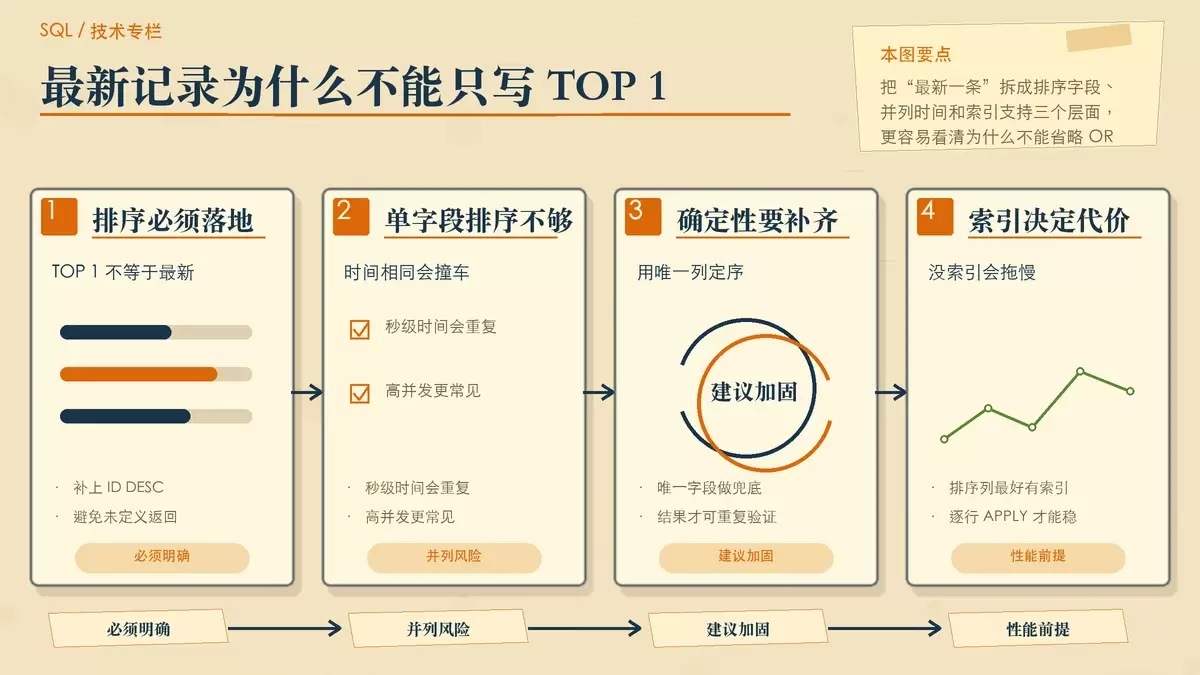
在 SQL Server 里用 APPLY 取“每组最新一条”时,语法能跑通不代表结果可靠。本文围绕 TOP 1 的排序确定性、CROSS APPLY 与 OUTER APPLY 的语义差异、关联条件与索引要求,以及 APPLY 相比标量子查询的执行优势,整理出一套更稳妥的写法判断标准。
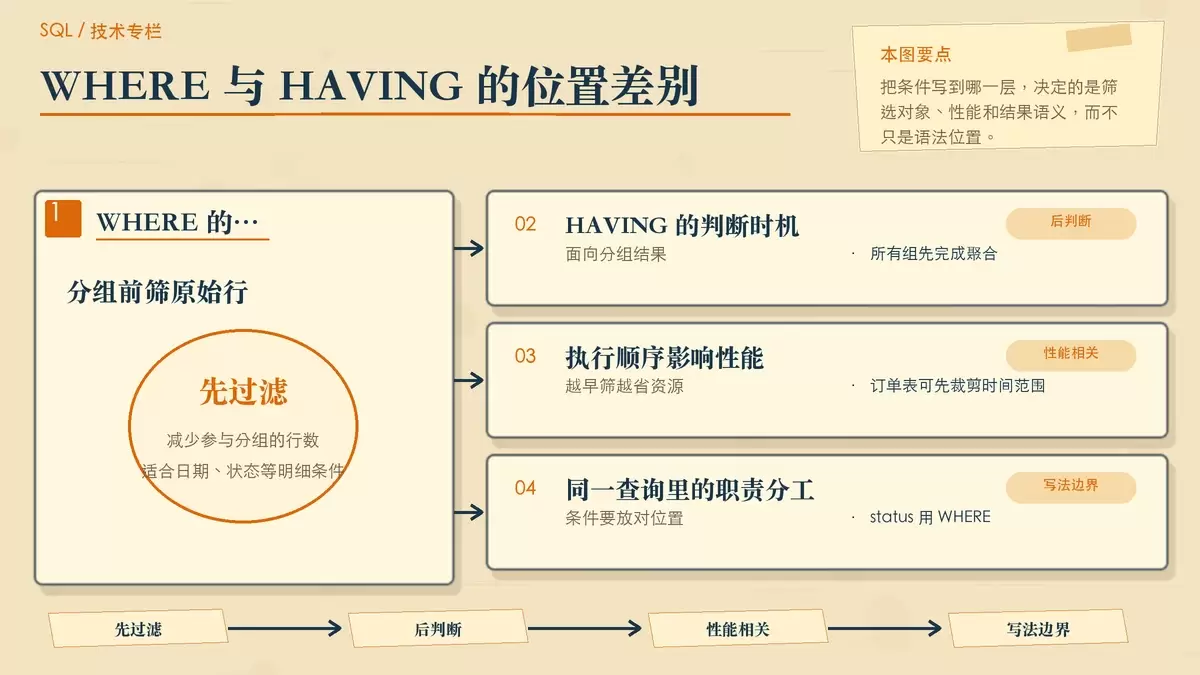
在 SQL 里,`WHERE` 和 `HAVING` 都能“筛选”,但作用阶段完全不同:一个面向原始行,一个面向聚合后的分组结果。本文结合 MySQL 5.7+ 的 `ONLY_FULL_GROUP_BY` 规则、常见报错和 `NULL` 场景,梳理 `GROUP BY` 后筛选结果时最容易写错的边界。 写分组统计时,最容易混淆的不是聚合函数本身,而是条件到底该放在 WHERE 还是 HAVING 。
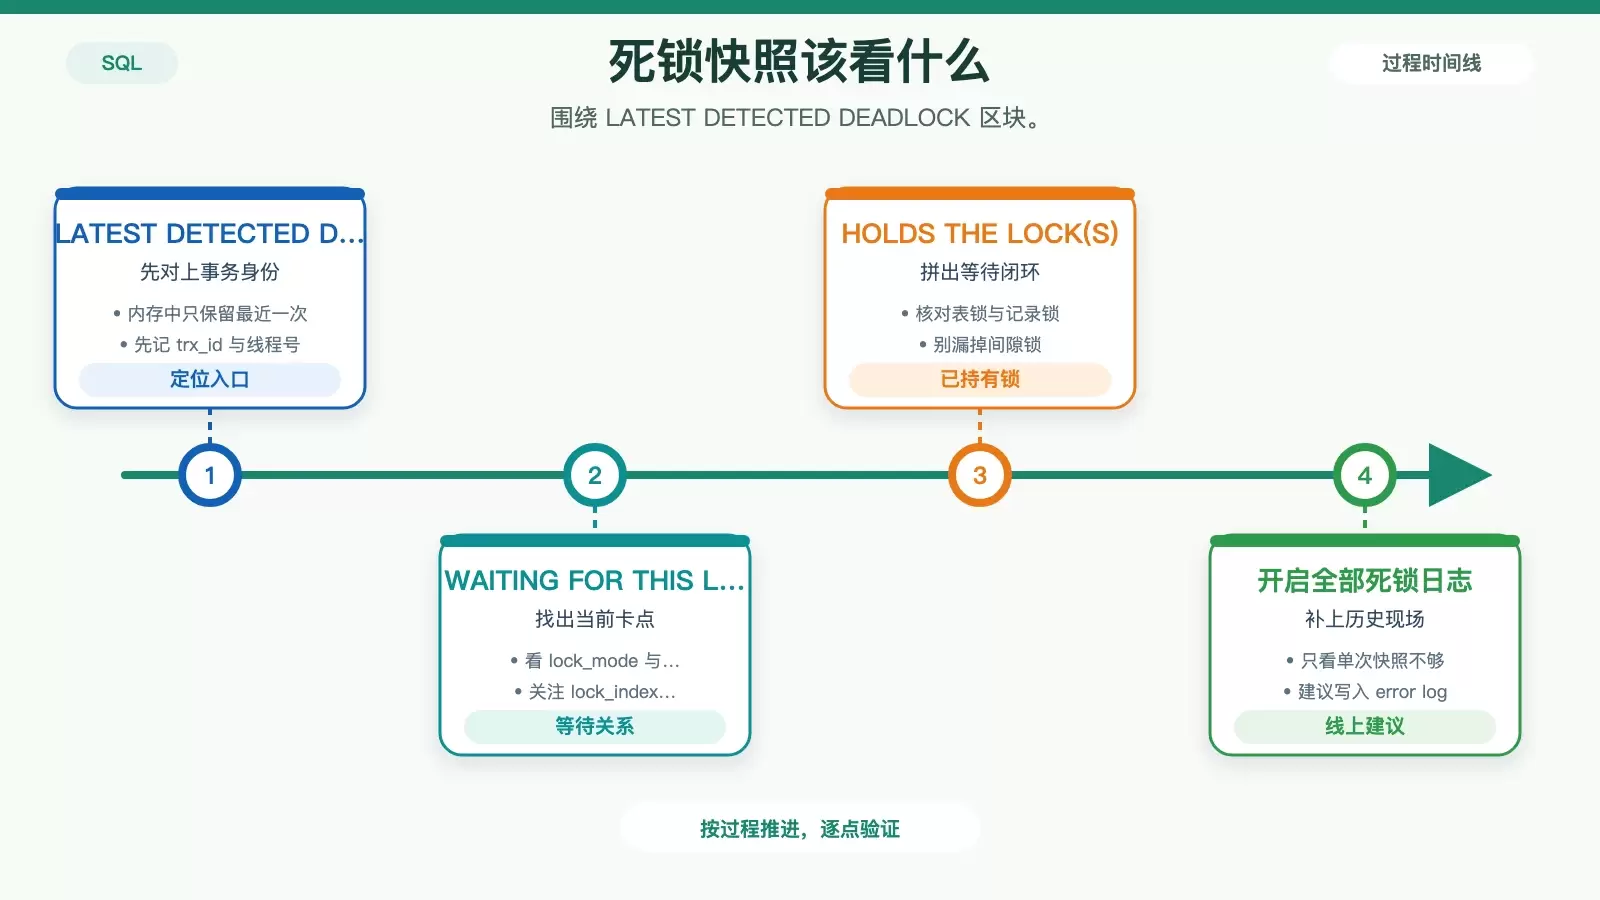
排查 SQL UPDATE 死锁,关键不是盯住报错语句本身,而是先还原两边事务的真实加锁链路。本文从 InnoDB 死锁快照、执行计划校验、间隙锁陷阱和批量更新策略四个方面,给出线上常用的定位入口与改写思路。
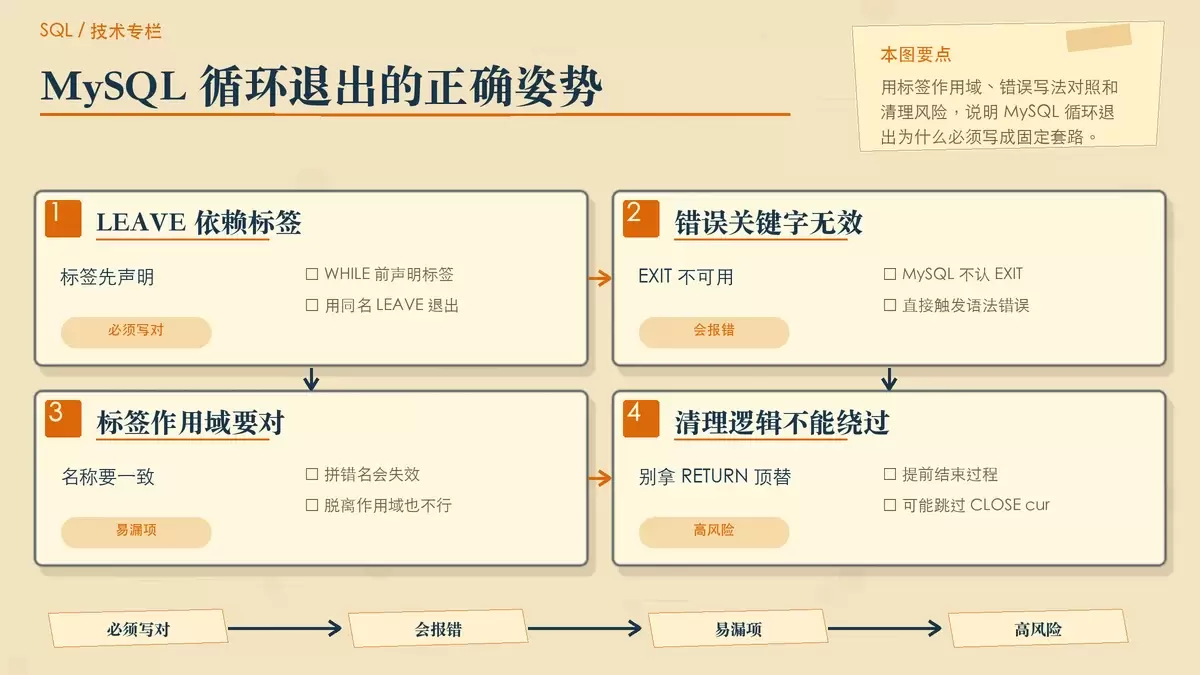
SQL 存储过程里的死循环,往往不是语法不会写,而是退出机制、计数保护和调试手段没统一。本文结合 MySQL 与 PostgreSQL 的典型场景,梳理合法退出方式、硬性上限写法,以及排查挂起过程时更有效的检查路径。
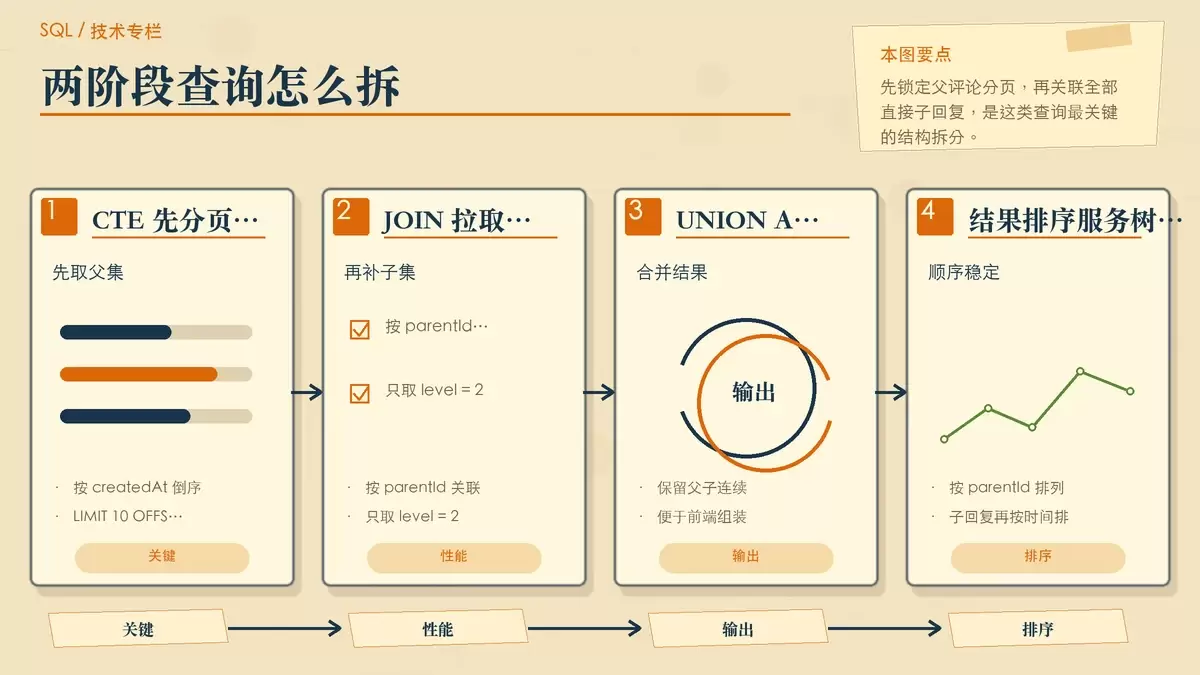
在邻接表评论表中,分页拿到“最新一级评论”并同时带出它们的全部二级回复,难点不在 SQL 能不能写出来,而在分页语义和结果完整性是否同时成立。本文用 MySQL 8.0 的 CTE 拆解这类查询,给出可直接落地的写法、排序方式与索引建议。
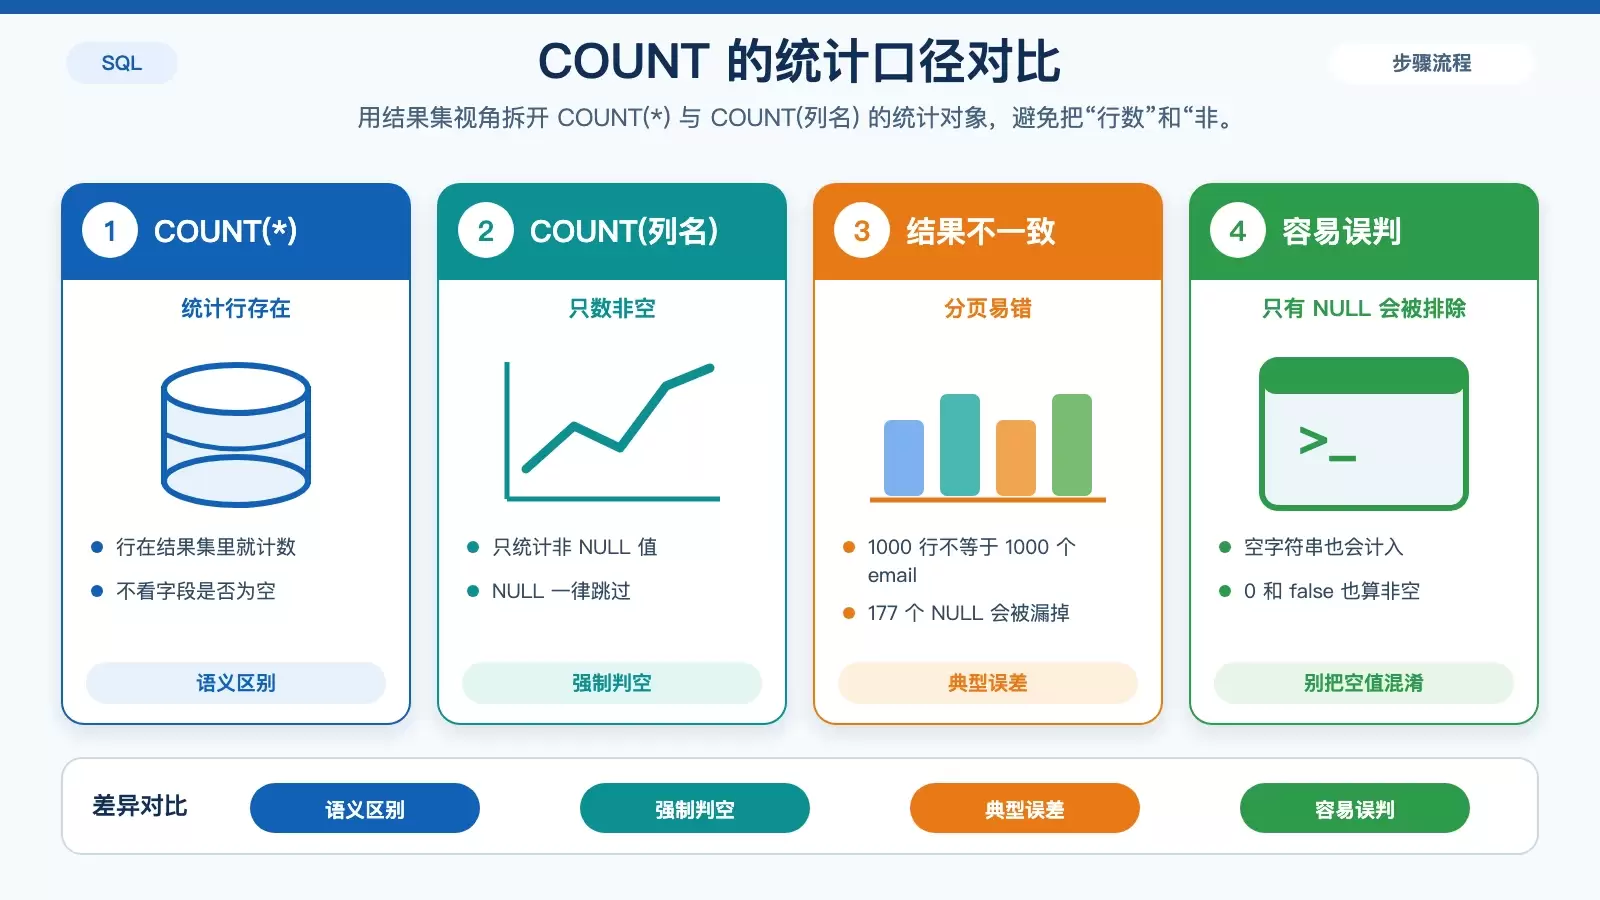
`COUNT(*)` 和 `COUNT(列名)` 的差别不在写法偏好,而在统计对象本身:前者数结果集中的“行”,后者只数指定列里非 `NULL` 的值。这个语义差异会直接影响分页总数、数据校验和 `JOIN` 统计结果,性能判断也必须建立在约束与索引条件之上。