


在 Go 项目里选数据库框架,难点往往不在“有没有工具”,而在“团队到底要哪一种约束”。同样是查一条用户数据并带出关联文章,GORM、Ent、SQLC 走的是三条很不一样的路:一个强调开发速度,一个强调模型与类型安全,一个强调 SQL 控制力与性能上限。看完这篇对比,你可以按项目规模、团队习惯和后期重构成本,快速判断哪条路线更适合自己。
反射派和代码生成派,分歧到底在哪
这场争论的核心,其实是数据库访问逻辑应该在什么时候“确定下来”。
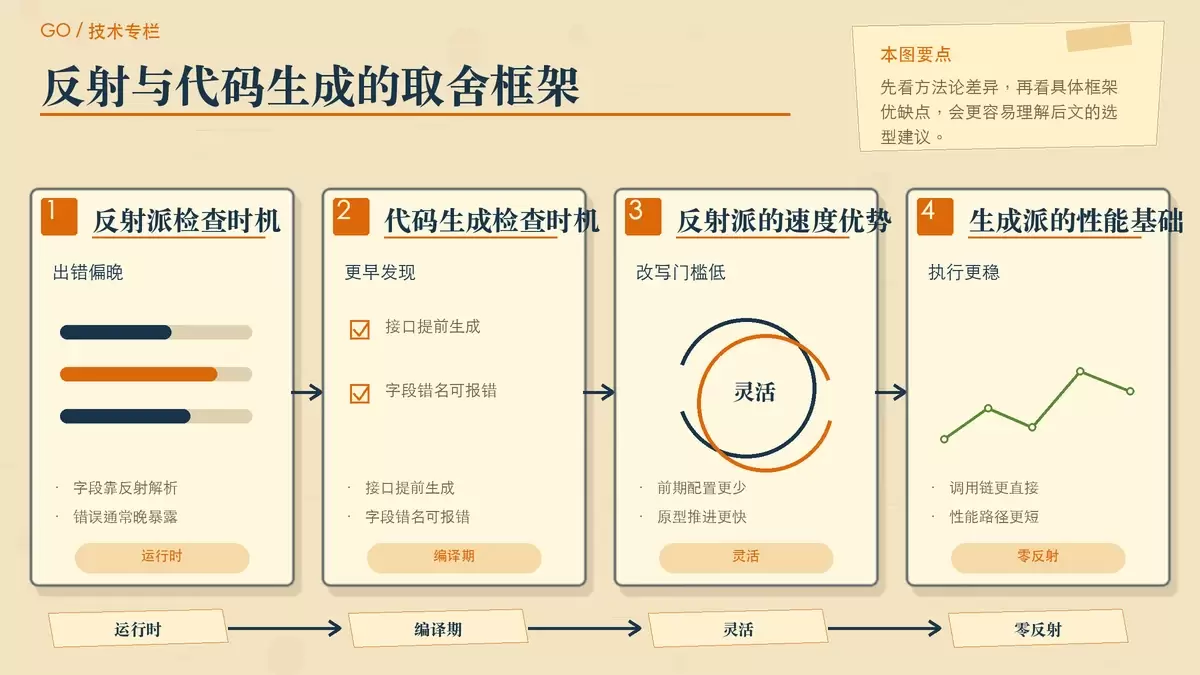
- 反射派(Reflection):运行时通过
reflect解析结构体,再动态拼出 SQL。典型代表就是 GORM。 - 代码生成派(Codegen):在编译前根据 Schema 或 SQL 生成强类型 Go 代码。典型代表是 Ent 和 SQLC。
两者最直接的差别,不只是性能,而是错误暴露的时机。反射方案很多问题要到运行时才发现;生成方案则尽量把字段名、关联关系、查询接口这些问题前置到编译期。对小项目来说,这可能只是体验差异;对表结构复杂、迭代频繁的系统来说,这就是维护成本的分水岭。
同一业务场景下,三种方案怎么写
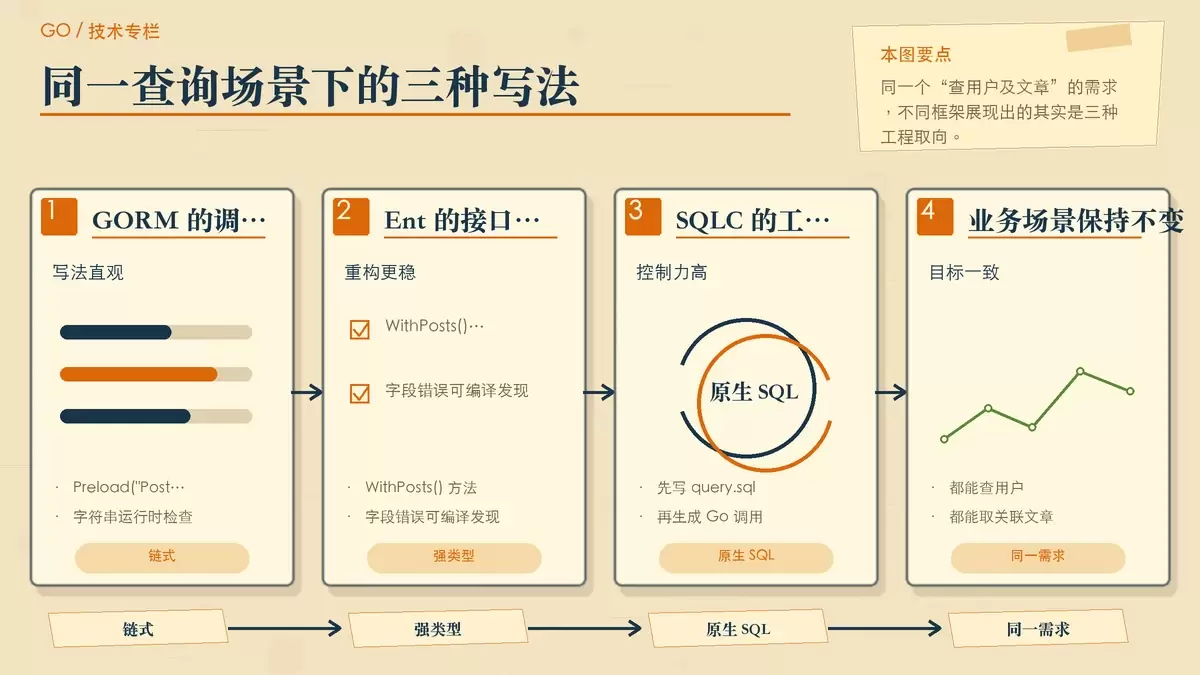
为了把差异说清楚,这里统一使用一个简单场景:查询一个用户(User)以及该用户关联的所有文章(Post)。
GORM:上手快,链式调用顺手
GORM 是典型的 Active Record 风格,几乎不用做太多前置配置,适合想尽快把 CRUD 跑起来的团队。
// GORM 代码示例
type User struct {
    ID    uint
    Name  string
    Posts []Post
}

func GetUserWithPosts(db *gorm.DB, userID uint) (User, error) {
    var user User
    // 这种“链式调用”非常爽,但 Preload 的字符串是运行时才检查的
    err := db.Preload("Posts").First(&user, userID).Error
    return user, err
}
这类写法的优点非常直接:API 符合直觉,开发者几乎一看就会,原型阶段推进很快。尤其在后台管理、普通业务系统、以增删改查为主的服务里,它的效率优势很明显。
但问题也出在“灵活”。像 Preload("Posts") 这样的字符串参数,只有跑到对应路径时才会暴露问题。项目一旦做大,字段重命名、关联调整、批量重构时,这种运行时检查会让风险明显上升。
Ent:用建模换取大型项目的稳定性
Ent 由 Facebook(Meta)开源,它把数据库关系当作图结构来建模,然后生成一套强类型 API。它不是单纯追求“少写代码”,而是追求让数据层在复杂系统里更可控。
// Ent 自动生成的 Fluent API
func GetUserWithPosts(ctx context.Context, client *ent.Client, userID int) (*ent.User, error) {
    // 所有的查询都是强类型的,编译期就能发现字段名写错
    return client.User.
        Query().
        Where(user.ID(userID)).
        WithPosts(). // Posts 是强类型的方法,非字符串
        Only(ctx)
}
Ent 的关键价值,在于把原本依赖约定和人工检查的内容变成编译器可以验证的接口。比如关联查询里的 WithPosts() 是明确的方法,而不是字符串;字段变更后,编译阶段就能立刻提示出错位置。
这意味着它非常适合表关系复杂、多人协作频繁、需要长期演进的系统。尤其当 Schema 超过 50 张表以后,Ent 在重构友好度上的收益会越来越明显。代价则是学习曲线更陡,前期要先接受它的建模方式和生成流程。
SQLC:SQL 自己写,性能和控制力自己拿
SQLC 的思路与 ORM 正好相反。你不去适应框架提供的查询表达,而是直接写 SQL,再让工具生成 Go 调用代码。
-- query.sql
-- name: GetUser :one
SELECT * FROM users WHERE id = $1;
-- name: GetPostsForUser :many
SELECT * FROM posts WHERE user_id = $1;
// SQLC 生成的代码调用
func GetUserWithPosts(ctx context.Context, q *db.Queries, userID int32) (UserWithPosts, error) {
u, err := q.GetUser(ctx, userID)
if err != nil {
return UserWithPosts{}, err
}
posts, err := q.GetPostsForUser(ctx, userID)
// 零反射,性能等同于原生 database/sql
return UserWithPosts{User: u, Posts: posts}, err
}这种模式最大的优势有两点。第一,性能路径非常短,零反射,表现基本等同于原生 database/sql。第二,SQL 是显式存在的,复杂查询、索引优化、执行计划分析都更容易与 DBA 或资深后端协作。
当然,SQLC 也把门槛摆得很清楚:团队要愿意写 SQL、审 SQL、维护 SQL。对于本来就不擅长数据库查询设计的团队来说,它不一定会让开发更轻松,但对于高并发、低延迟微服务,或者高度依赖复杂查询的系统,它的上限非常高。
从开发效率到重构成本,差异怎么判断
如果把三者放在同一张表里看,取舍会更清楚。
| 维度 | GORM (反射) | Ent (Schema 生成) | SQLC (SQL 生成) |
|---|---|---|---|
| 开发效率 | 极高 (上手即用) | 中 (需定义 Schema) | 中 (需手写 SQL) |
| 类型安全 | 低 (运行时检查) | 极高 (编译期检查) | 极高 (编译期检查) |
| 执行性能 | 一般 (反射开销) | 优秀 (零反射) | 极致 (原生性能) |
| 重构友好度 | 差 (需全局搜索字符串) | 极强 (编译器报错) | 强 (SQL 变更即代码变更) |
| 学习曲线 | 平缓 | 陡峭 | 中等 (需懂 SQL) |
可以把这张表理解成三个优先级方向:
- GORM 优先解决“尽快做出来”。
- Ent 优先解决“系统变复杂后还能稳住”。
- SQLC 优先解决“查询可控且足够快”。
很多团队选型时容易只盯着开发效率,但真正影响后期成本的,往往是类型安全和重构友好度。一个框架今天让你少写 30 行代码,不代表它半年后还能让你少改 300 行问题代码。
按项目阶段和团队能力选,通常更靠谱
什么时候更适合 GORM
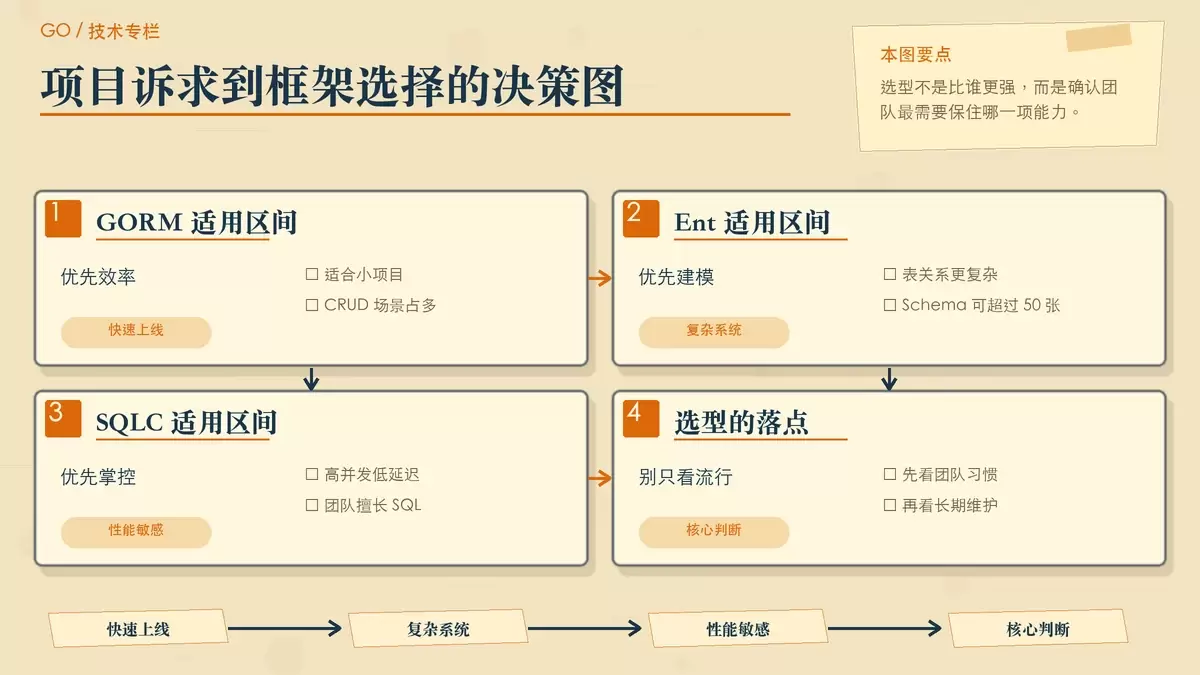
- 初创项目或小工具:目标是快速上线,业务模型不复杂,不想在早期引入额外生成步骤。
- CRUD 密集型应用:如果主要是标准增删改查,GORM 的便利性仍然很强。
它适合把时间优先花在业务验证上,而不是数据层抽象设计上。但前提是团队能接受,随着系统膨胀,运行时错误和字符串硬编码的维护成本会逐步增加。
什么时候更适合 Ent
- 大型企业级应用:当 Schema 超过 50 张表,且关系复杂时,强类型生成能显著减少调试和重构风险。
- 强调建模与分层:如果希望数据层和业务层边界更清晰,Ent 提供的建模方式更容易形成长期规范。
如果团队正在做领域驱动设计(DDD),或者项目生命周期长、参与人数多,Ent 往往比“先快后改”更省总成本。它不是最轻的方案,但通常是复杂系统里更稳的方案。
什么时候更适合 SQLC
- 高性能场景:高并发、低延迟的微服务,对反射开销敏感,SQLC 的收益会更直接。
- SQL 能力强的团队:如果团队里有 DBA,或者后端本身就擅长原生 SQL,SQLC 可以把这部分能力完整发挥出来。
SQLC 很适合那些不想把查询表达交给 ORM“猜测”的团队。你写什么 SQL,就得到什么代码行为,调优路径也更清晰。
最后结论:没有通吃方案,只有明确取舍
从今天的 Go 生态看,GORM、Ent、SQLC 都已经足够成熟,区别不在“谁先进”,而在你希望把复杂度放在哪里。
GORM 代表的是便利和原型速度,Ent 代表的是复杂系统里的类型安全与结构化建模,SQLC 代表的是对 SQL 和性能边界的直接掌控。
如果项目还在验证阶段,GORM 往往最省时间;如果系统会持续扩张,Ent 更像长期主义的投入;如果性能、查询质量、数据库协作是核心诉求,SQLC 通常更合适。真正靠谱的选型方式,不是追逐“最强框架”,而是先确认你的项目当前最怕失去什么:开发速度、重构安全,还是执行效率。









