


评论系统使用邻接表模型时,很多人都会遇到同一个问题:一级评论需要按时间分页,但列表里又不能只返回父节点,还得把每条父评论下面的全部直接回复一起带出来。这里最容易出错的地方,是把“分页主集”和“扩展子集”混在一次普通关联里,结果要么分页不准,要么树形结构被打散。
这篇文章把问题限定在一个很常见也很实用的场景:只展示一级评论以及它们对应的全部二级回复,不递归展开更深层级。基于 MySQL 8.0+ 的 CTE,可以先稳定拿到当前页的父评论,再把子回复补齐,同时保住查询可读性、分页语义和大表下的执行效率。
需求边界先定清:只取一层父评论和全部直接子回复
本文处理的不是“无限层级评论树”,而是一个更明确的业务需求:
- 分页展示最新的一级评论,即
parentId IS NULL AND level = 1; - 对当前页中的每条一级评论,必须完整加载它名下所有直接子回复;
- 子回复限定为
level = 2,并且parentId指向对应一级评论; - 最终结果服务的是“1 层父评论 + 其全部 1 级子回复”的扁平树视图。
这个边界很重要。因为一旦需求其实是三级、四级甚至无限递归展开,那么查询设计就会立刻变成另一类问题,需要使用 WITH RECURSIVE,并且还要额外控制深度、排序和性能。
推荐写法:先分页一级评论,再合并全部子回复
在 MySQL 8.0 里,这类“先缩小主集,再补齐关联数据”的场景,适合用 Common Table Expressions(CTE)来拆成两步。第一步只负责拿到当前页的一级评论,第二步再把这些父评论对应的二级回复合并进来。
WITH top_level AS (
SELECT *
FROM comments
WHERE parentId IS NULL AND level = 1
ORDER BY createdAt DESC-- 假设时间字段为 createdAt;按需调整
LIMIT 10 OFFSET 0-- 分页:第 1 页,每页 10 条
)
SELECT id, parentId, content, level, createdAt, authorId
FROM top_level
UNION ALL
SELECT c.id, c.parentId, c.content, c.level, c.createdAt, c.authorId
FROM comments c
INNER JOIN top_level t ON c.parentId = t.id
WHERE c.level = 2
ORDER BY parentId, createdAt;-- 父评论优先,子回复按时间排序
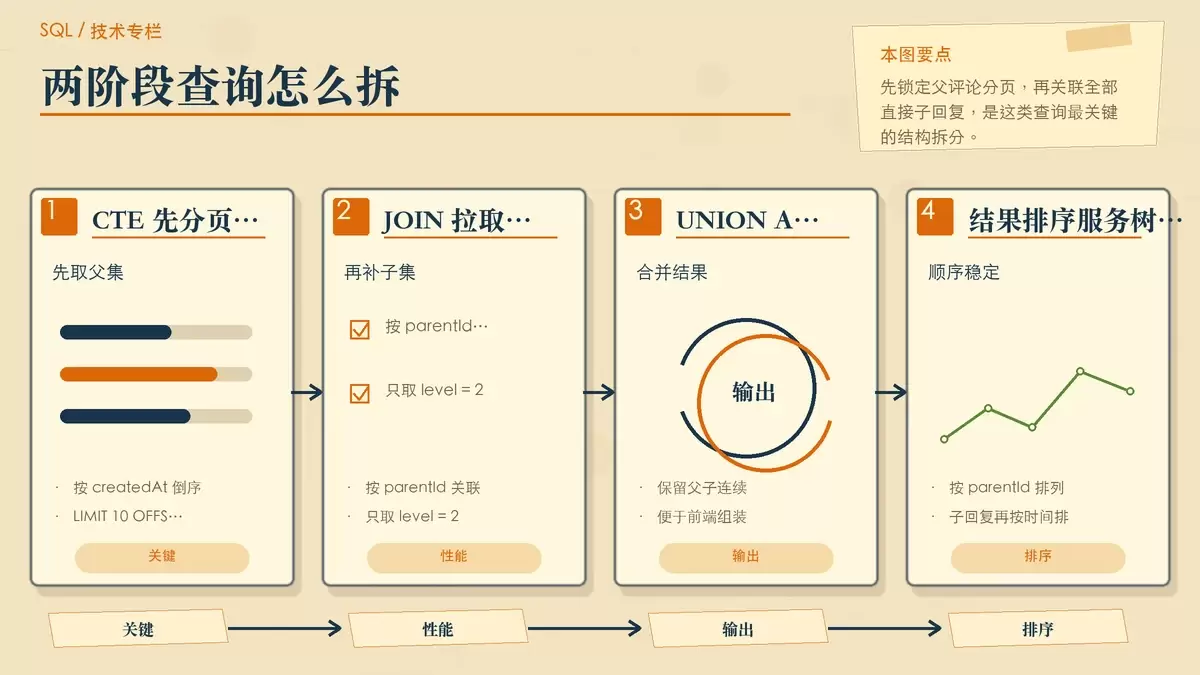
这段 SQL 的核心思路可以概括为两件事:
先把分页语义锁定在父评论上
top_level 这个 CTE 先执行 ORDER BY ... LIMIT ... OFFSET ...,只取当前页需要展示的一级评论。这样分页对象始终是父评论本身,不会因为后面联表带出了多条子回复,导致一页里实际出现的父评论数量变少或顺序错乱。
再把这些父评论对应的二级回复一次性补齐
后半段通过 INNER JOIN top_level t ON c.parentId = t.id,只关联当前页父评论名下的回复。再配合 UNION ALL 合并结果,就能得到“父评论集合 + 它们的全部直接子回复”的完整输出。
这条 SQL 为什么更适合线上场景
很多实现也能“查出结果”,但不一定适合真正上线使用。这个方案的优势主要体现在下面几个点。
分页语义更准确
如果直接把父评论和子评论一起 JOIN 后再分页,数据库分页的对象就不再是“父评论”,而是展开后的结果行。这样父评论数量会受子回复条数影响,页面表现通常会不稳定。CTE 先筛父集,正好避开这个问题。
结果结构更容易给前端消费
通过显式的 ORDER BY parentId, createdAt,同一组父子评论会连续排列。前端渲染时,无论是先按父评论分组,还是在服务层二次组装,都更直接,不必再额外做一次高成本排序。
比随手写的子查询更利于性能控制
文中选择的是 INNER JOIN 关联 CTE,而不是 IN (SELECT ...)。在大表场景下,这种写法通常更利于优化器生成稳定的执行计划,也更容易结合索引进行控制。
字段显式列出,后续维护成本更低
虽然 CTE 部分示例里用了 SELECT *,但最终输出字段依然明确列出了 id、parentId、content、level、createdAt、authorId。在实际项目里,最终查询最好始终保持显式字段,避免表结构调整后影响兼容性。
使用前要注意的限制和前提
这套方案好用,但它的适用范围需要提前说清楚。
它不处理无限层级树
本文方案只覆盖两层结构:一级评论和它的直接回复。如果评论系统存在三级、四级甚至更深回复链,就不能继续沿用这条 SQL 硬撑。那时应改用递归 CTE,也就是 WITH RECURSIVE,并根据业务限制最大深度。
level 字段必须可靠
查询条件里直接依赖了 level = 1 和 level = 2。这意味着评论写入时,业务层必须正确维护层级字段,并在插入或更新时做好校验。否则一旦层级数据脏掉,查询结果就会出现漏数据或错挂载的问题。
排序字段要和业务定义一致
示例使用的是 createdAt DESC 选出“最新 10 条一级评论”。如果你的业务实际按热度、最后回复时间或置顶规则排序,那么 CTE 里的排序条件必须同步调整,否则分页逻辑虽然正确,业务语义却不对。
索引怎么建,才能把这条查询跑稳
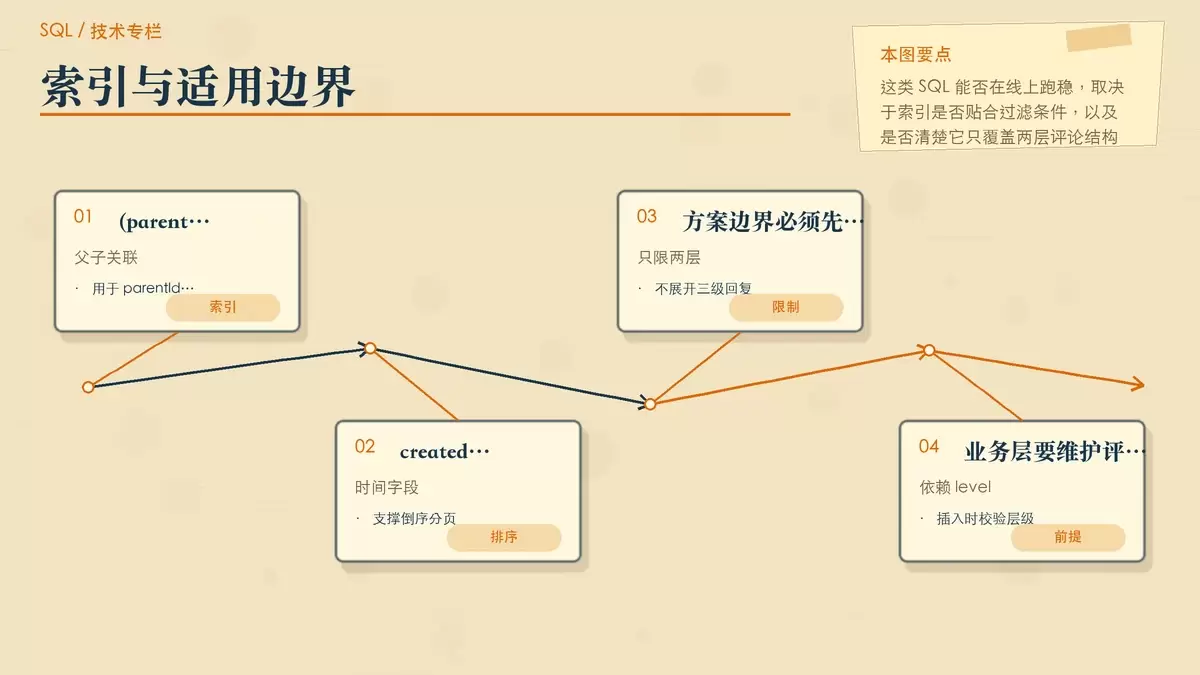
如果评论表数据量已经上来,索引设计会直接决定这条 SQL 是否还能保持响应速度。文中的建议是给父子关联条件和时间排序字段分别建立索引:
CREATE INDEX idx_parent_level ON comments(parentId, level);
CREATE INDEX idx_created_at ON comments(createdAt DESC);
这两个索引分别解决的是不同问题:
idx_parent_level ON comments(parentId, level):用于加速子回复部分的关联与过滤,尤其是c.parentId = t.id且c.level = 2这类组合条件;idx_created_at ON comments(createdAt DESC):用于支持一级评论按时间倒序分页,减少排序和扫描成本。
如果表非常大,还可以继续结合实际查询频率、字段选择情况与执行计划,评估是否需要把更多输出列纳入覆盖索引。但这一步要以真实数据分布和 EXPLAIN 结果为准,没必要在一开始过度设计。
结论:适合“分页父评论 + 完整直属回复”的标准解法
对于邻接表评论模型来说,如果需求明确限定为“分页获取最新一级评论,同时完整带出这些评论的全部二级回复”,那么 MySQL 8.0+ 的 CTE 确实是一种很稳妥的实现方式。它把分页主集和子集扩展清楚拆开,既保证结果完整,也避免了常见的分页失真问题。
需要记住的是,这不是通用树查询模板,而是针对“两层评论视图”优化过的工程化解法。只要业务边界、排序规则和索引设计都对齐,这条查询在可读性和性能之间能取得不错的平衡。









