


在 SQL Server 里查“每个对象的最新一条记录”,很多人会先想到子查询,但真正容易出问题的往往不是能不能写出来,而是结果是否稳定、执行计划是否失控。下面就按几个最常见的误区拆开讲:什么时候 TOP 1 必须配合排序,什么时候该选 CROSS APPLY 或 OUTER APPLY,以及怎样通过关联条件和索引把这类查询写得既清楚又靠谱。
OUTER APPLY 里取最新记录,TOP 1 一定要写清排序
在 OUTER APPLY 中写 TOP 1 子查询时,如果不加 ORDER BY,SQL Server 并不保证返回哪一行。即使当前数据看起来总能拿到“最新记录”,那也只是碰巧符合现有物理顺序或执行计划,不能当成稳定行为。
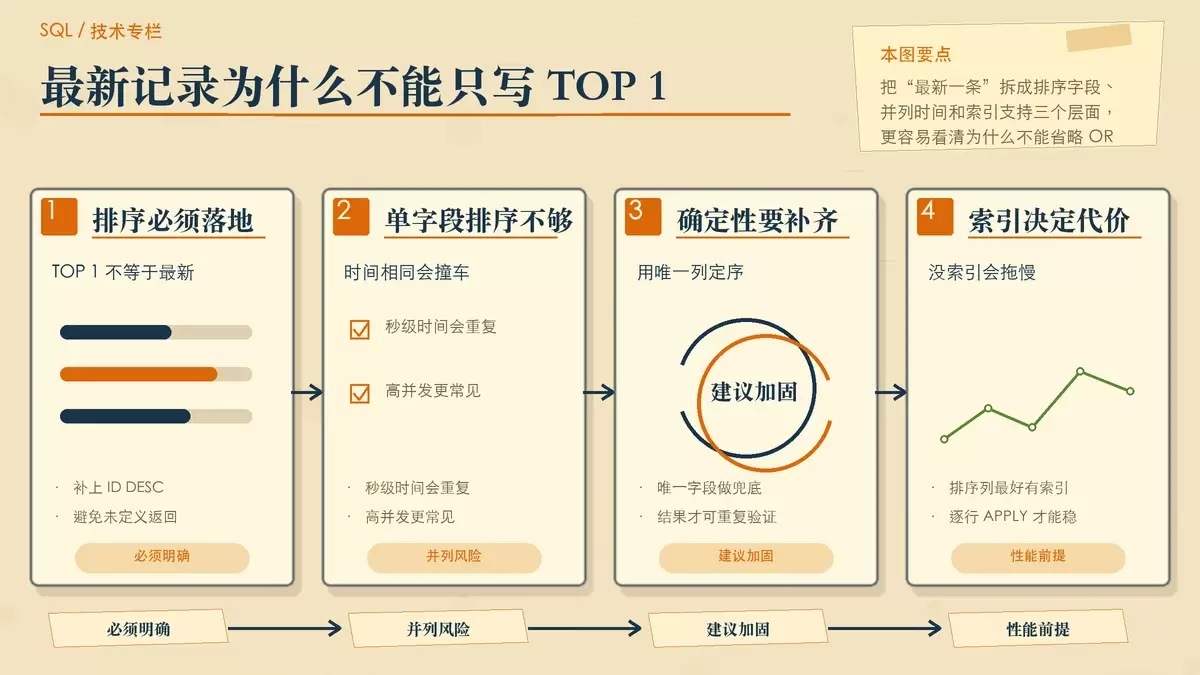
这类问题在有索引但排序字段未覆盖时尤其明显。优化器可能直接按可访问的物理顺序取第一行,而不是按你心里默认的时间倒序扫描,所以“看起来没问题”的 SQL,换一批数据、换一个执行计划,结果就可能变化。
- 要明确指定排序逻辑,例如
ORDER BY CreateTime DESC, ID DESC - 如果
CreateTime允许重复,比如只有秒级精度、又存在高并发写入,仅写CreateTime DESC仍可能落到任意一条记录上 - 这时应该补上
ID DESC或其他唯一字段,确保“最新一条”在逻辑上可唯一确定
另一个常被忽视的点是索引。排序字段如果没有合适索引支持,那么每次 APPLY 执行都可能触发高成本扫描。由于右侧表达式是跟着左表逐行调用的,外表行数一大,性能问题会被迅速放大。
ORDER BY CreateTime DESC, ID DESCCROSS APPLY 还是 OUTER APPLY,关键看左表行是否必须保留
CROSS APPLY 和 OUTER APPLY 的区别不在语法风格,而在结果语义。
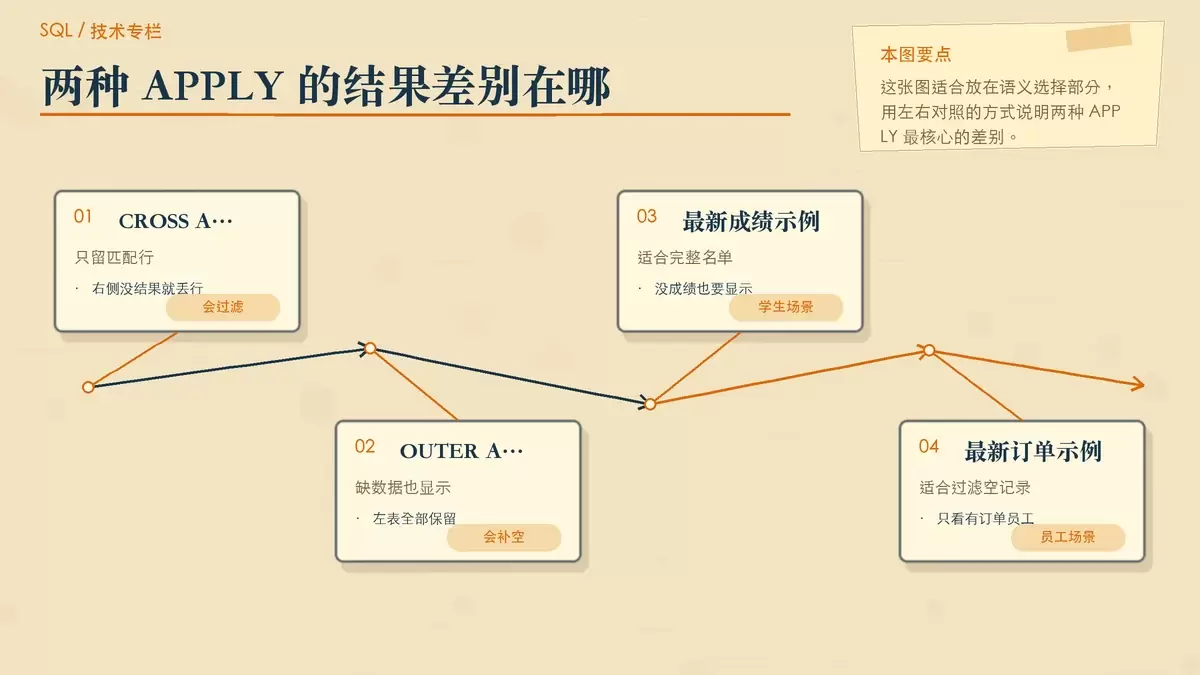
CROSS APPLY只返回右侧表达式能够匹配到结果的左表行OUTER APPLY会保留左表全部行,如果右侧没有匹配记录,就以NULL补齐
因此该选哪个,取决于业务是否允许左表“无匹配数据的行”被过滤掉。
- 如果要查“每个学生的最新成绩”,并且没成绩的学生也要显示出来,那就必须用
OUTER APPLY - 如果要查“每个有订单的员工的最新订单”,零订单员工本来就不需要出现在结果里,那么
CROSS APPLY会更直接,也可能略快一些,因为它不需要额外生成NULL行 - 把本该保留的左表行误用
CROSS APPLY过滤掉,是这类查询最隐蔽的错误之一,尤其边缘数据往往最难在测试中暴露出来
换句话说,这不是“哪个更高级”的问题,而是“结果能不能丢行”的问题。先定业务语义,再定 APPLY 形式,顺序不能反。
相关子查询必须写关联 WHERE,字段也要有索引
APPLY 右侧通常是相关子查询,但相关性并不会自动生成。你在子查询里如果没有显式写出和左表的关联条件,SQL Server 不会替你补上,结果既可能错,也可能慢得离谱。
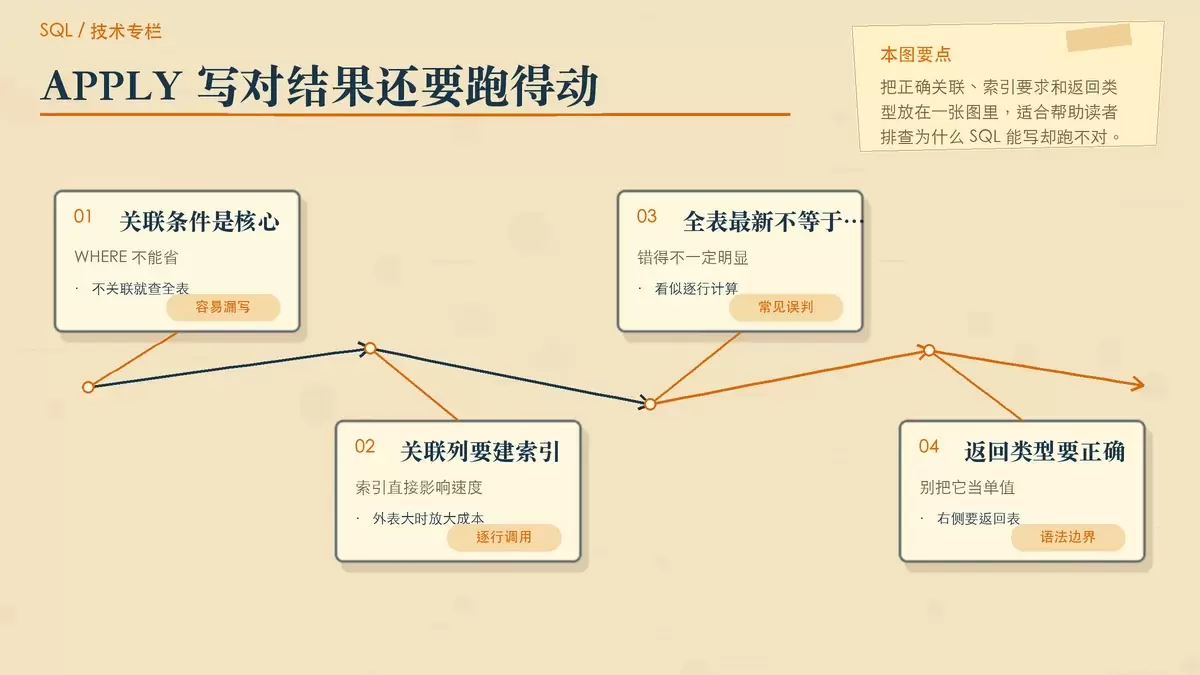
典型错误是只顾着取“最新一条”,却忘了限定“是谁的最新一条”。
SELECT TOP 1 Score FROM Score ORDER BY CreateTime DESC这段写法的问题是:它每次取到的都是整张 Score 表里最新的一条成绩,和当前学生无关。放进 APPLY 后,看起来像是逐行计算,实际上逻辑早就偏了。
正确写法应该把关联条件明确写出来:
SELECT TOP 1 Score
FROM Score
WHERE StudentId = s.StudentId
ORDER BY CreateTime DESC
这里的 WHERE StudentId = s.StudentId 才是 APPLY 成立的核心,它把右侧子查询限定在“当前左表这一行”的范围内。
同时,WHERE 中参与关联的字段应该有索引支持。因为 APPLY 本质上不是一次性展开的大 JOIN,而是对左表每一行去执行右侧逻辑。如果外表很大,而 StudentId 没有索引,查询会迅速退化成大量重复扫描。
为什么 APPLY 往往比 LEFT JOIN 加标量子查询更合适
不少旧写法会把“最新记录”放进 SELECT 列表中的标量子查询里,再配合 LEFT JOIN 使用,表面上看和 OUTER APPLY 能达到类似结果,但执行方式往往并不一样。
问题在于,标量子查询容易被当成嵌套循环的一部分处理,过滤条件也不一定能有效下推。结果就是:你以为自己只是补了一列,实际却给查询计划增加了重复求值和额外扫描的机会。
OUTER APPLY更容易让优化器把外部字段当作参数传入右侧表达式,配合索引后可以做到“每行只查必要的数据”- 如果同一个标量子查询在
SELECT列表中出现多次,可能被重复执行;而APPLY右侧表达式只需要计算一次,更利于复用结果 - 当右侧逻辑已经不止一张表,或者包含更复杂的筛选与排序时,
APPLY还能把动态部分集中收进一段子查询里,主查询结构通常更清晰
因此,从性能和可维护性两个角度看,凡是“按左表当前行去右侧取一小段结果”的场景,APPLY 往往都比散落在 SELECT 里的标量子查询更稳妥。
最后一个易错点:APPLY 右侧必须返回表结果
还有一个在调试初期很常见的坑:APPLY 右侧表达式不能只是纯标量值,它必须返回一个表结果,哪怕这个结果只有一列一行也一样。
例如,像 SELECT GETDATE() 这种纯标量形式,如果直接按错误方式放进 APPLY,通常会触发语法错误,而且 SQL Server 给出的报错信息未必直观,排查时容易把注意力放错位置。
判断方法很简单:把 APPLY 右侧当成一个“会随左表当前行变化的派生结果集”,而不是一个普通单值表达式。只要这个理解站稳了,很多写法上的误区都会自动避开。









