


很多人第一次写分组统计时,问题并不出在 COUNT() 或 AVG(),而是把“筛原始数据”和“筛统计结果”混在了一起。要把 GROUP BY、WHERE、HAVING 用对,关键不是死记语法,而是先分清查询到底在处理哪一层数据,以及 MySQL 5.7+ 对分组语句到底限制到了什么程度。
HAVING 为什么不能脱离 GROUP BY 使用
HAVING 面向的不是原始表记录,而是“每组聚合完成后得到的结果行”。这也是为什么单独写 HAVING 会直接报错,例如把 HAVING COUNT(*) > 5 放进没有 GROUP BY 的语句里,MySQL 会抛出 SQLSTATE[HY000]: General error: 1140。
原因很直接:没有分组,就不存在“每组聚合后的结果”;既然没有这个上下文,HAVING 自然无从判断条件。
在 HAVING 中,能合法出现的内容通常只有两类:
- 已经写进
GROUP BY的分组列,例如department、user_id - 聚合表达式,例如
COUNT(*)、AVG(salary)、SUM(amount)
反过来看,原始行字段不能直接拿到 HAVING 里使用。像 HAVING salary > 8000 这样的写法就不成立,因为 salary 既没有进入 GROUP BY,也没有经过聚合;到了 HAVING 阶段,单行明细本身已经不是当前语义里的判断对象了。
SELECT、GROUP BY 与 ONLY_FULL_GROUP_BY 的约束
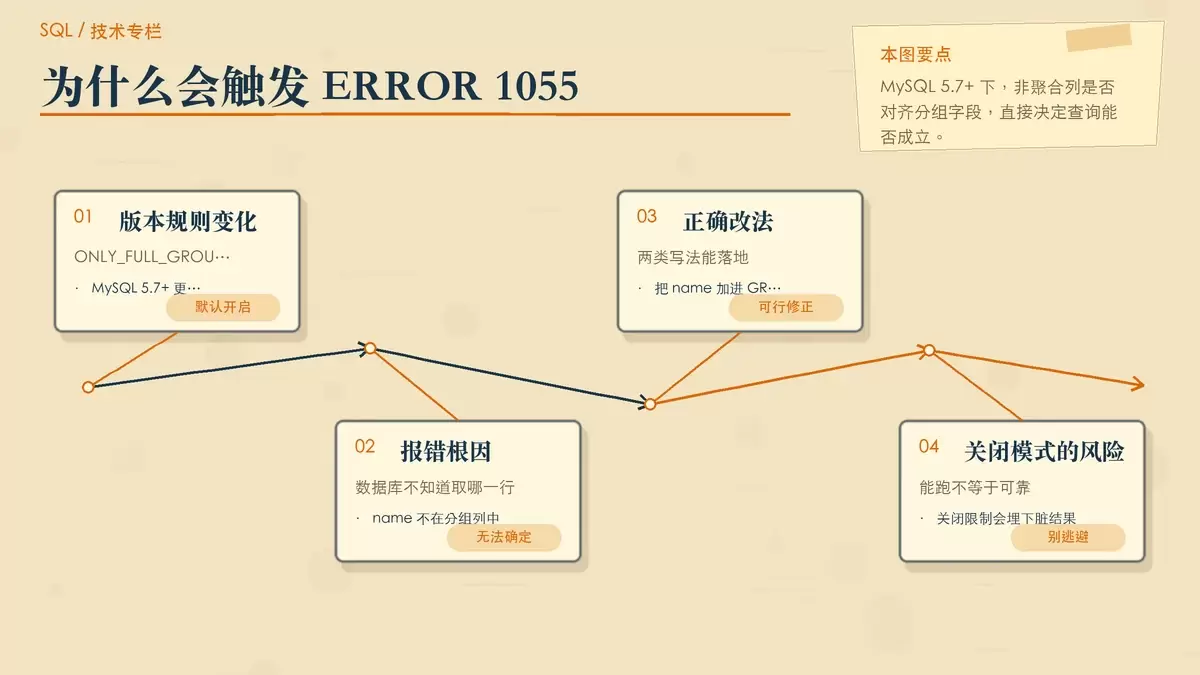
很多分组语句在旧版本 MySQL 里“看起来能跑”,放到 MySQL 5.7+ 就会直接失败,核心原因通常是默认启用了 ONLY_FULL_GROUP_BY。
例如下面这句:
SELECT name, department, COUNT(*) FROM employees GROUP BY department;这会触发 ERROR 1055。问题在于:查询按 department 分组,但 SELECT 里又拿了一个既没分组、也没聚合的 name。对数据库来说,一个部门往往对应多行员工记录,它无法判断这组结果里到底该返回哪一个 name。
能落地的修正方式通常只有两种:
- 把
name加入GROUP BY,前提是你的业务确实要按人和部门共同分组 - 把
name改成明确的聚合表达式,例如MAX(name)、GROUP_CONCAT(name),或者在特定场景下使用ANY_VALUE(name)
有些人会选择关闭 ONLY_FULL_GROUP_BY,但这通常只是把问题藏起来。查询也许能继续执行,结果却不再可靠;而且一旦切到 PostgreSQL 或 SQL Server,这类写法通常会直接失败,迁移成本更高。
WHERE 和 HAVING 该怎么分工
判断该把条件写在 WHERE 还是 HAVING,最稳妥的办法是看 SQL 的执行顺序。常见顺序可以概括为:
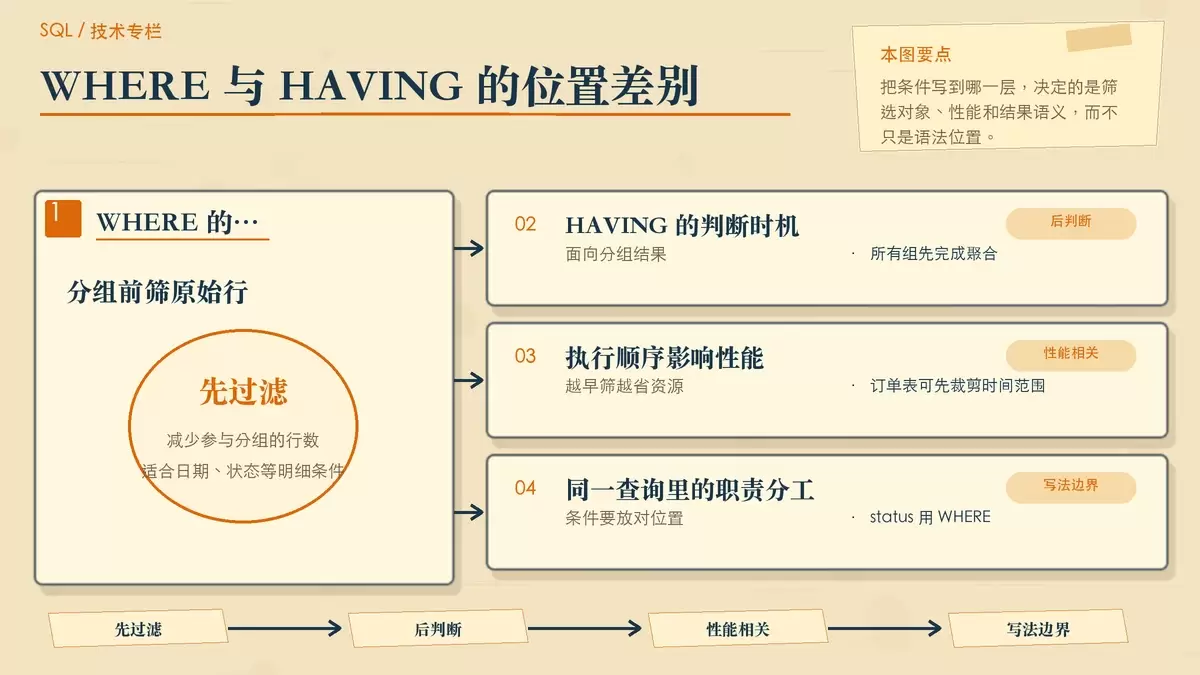
FROM → WHERE → GROUP BY → 聚合计算 → HAVING → SELECT → ORDER BY这个顺序决定了两者的职责边界:
WHERE在分组前执行,用来筛掉不需要参与统计的原始记录HAVING在聚合后执行,用来筛选已经算好的分组结果
这不仅影响语法,更影响性能。比如在千万级订单表上先加一段 WHERE order_date >= '2026-01-01',可能把后续分组耗时从 8 秒压到 0.3 秒;因为参与 GROUP BY 的数据量先被砍掉了。相反,HAVING COUNT(*) > 100 必须等所有组都完成计数后,才能再筛一次结果,它不会提前跳过分组计算。
一个典型例子是:想找出“活跃员工中,平均工资超过 12000 的部门”,正确写法应当是先过滤员工状态,再做分组统计:
WHERE status = 'active'
GROUP BY department
HAVING AVG(salary) > 12000
这里 status = 'active' 作用于原始员工记录,所以必须放在 WHERE;而 AVG(salary) > 12000 针对的是部门聚合后的平均值,所以只能放在 HAVING。如果把 status = 'active' 塞进 HAVING,不仅语义错位,很多情况下还会直接变成非法写法。
HAVING 遇到 NULL 时为什么结果容易反直觉
HAVING 的另一个高频坑点是 NULL。分组聚合后,如果表达式结果本身是 NULL,条件判断不一定会按很多人直觉中的“真或假”来走,而是可能得到 UNKNOWN,从而把整组排除掉。
例如:
HAVING AVG(salary) > 10000:如果某个部门所有salary都是NULL,那么AVG()的结果也是NULL,表达式NULL > 10000不成立,这个部门不会出现在结果里HAVING COUNT(*) > 0:即使一组里所有字段值都是NULL,只要实际存在记录,COUNT(*)仍然会返回 1,这组就会被保留
这也是为什么写聚合筛选时,不能只盯着函数名看,还要确认它面对空值时返回的到底是什么。
在数据库兼容性上,MySQL 和 PostgreSQL 对这类 NULL 聚合结果的默认处理基本一致。不过如果 PostgreSQL 启用了 transform_null_equals = on,某些涉及 NULL 比较的判断方式会被改写,间接影响带有 IS NULL 等逻辑的分组条件。这类场景不算日常高频,但在跨库迁移或排查边缘 bug 时值得留意。
写分组筛选时,先判断你到底在筛哪一层数据
把这类 SQL 写稳,真正重要的不是多记几个例子,而是先问自己一句:当前条件筛的是原始数据,还是统计结果。
- 如果筛的是明细行,用
WHERE - 如果筛的是聚合后的组结果,用
HAVING - 如果
SELECT里出现了非聚合列,就检查它是否与GROUP BY严格对齐,尤其是在 MySQL 5.7+ 默认开启ONLY_FULL_GROUP_BY的情况下
很多分组查询之所以难排查,不是因为语法本身复杂,而是错误往往介于“能报错”和“能运行但结果不可信”之间。把执行顺序、字段归属和空值行为这三件事理顺,GROUP BY 后的筛选基本就不会再偏题。









