


很多团队在做“每周新增用户”统计时,第一反应都是直接对时间字段套 WEEK() 分组,但这一步往往就把结果带偏了。问题不只在于不同数据库对“周”的定义不同,还包括“新增”到底按哪一次行为算、跨年周怎么归类,以及查询能不能跑得动。下面按这几个最容易踩坑的点拆开讲,读完你可以直接判断自己的 SQL 口径是否可靠。
不同数据库里,WEEK 的含义并不统一
WEEK()、EXTRACT(WEEK FROM ...) 和 DATEPART(week, ...) 看起来都在取“第几周”,但它们背后的规则并不一致。有的以周日为一周开始,有的按 ISO 标准计算,还有的把 1 月 1 日所在周直接视为第 1 周。结果就是:同样的“第 5 周”,在不同数据库甚至不同年份里,可能对应完全不同的日期范围。
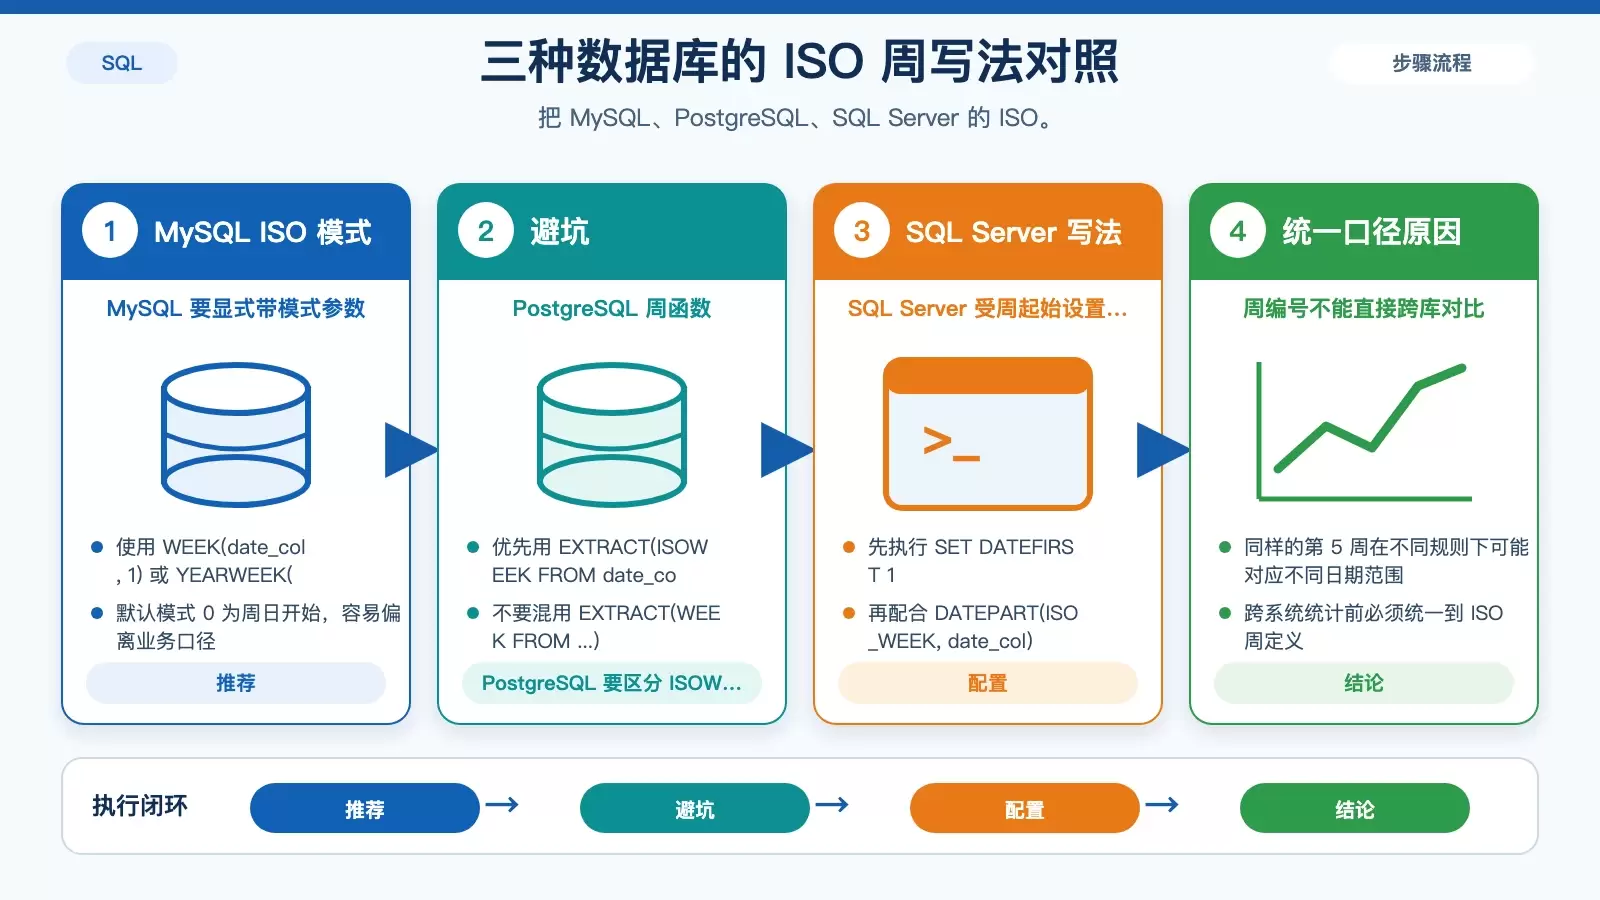
如果你的数据要跨系统对齐,优先统一到 ISO 周定义:周一是一周第一天,且第 1 周必须包含当年至少 4 天。
MySQL:优先使用 ISO 模式
MySQL 中建议优先使用:
WEEK(date_col, 1)
YEARWEEK(date_col, 1)
这里第二个参数 1 表示按周一作为每周开始,使用 ISO 风格周定义。不要依赖默认的 WEEK(date_col),因为默认模式 0 是周日开始,容易和业务口径不一致。
PostgreSQL:不要混用 WEEK 和 ISOWEEK
PostgreSQL 里更稳妥的写法是:
EXTRACT(ISOWEEK FROM date_col)不要直接写:
EXTRACT(WEEK FROM date_col)原文提示它依赖 datestyle 设置,口径不稳定。在需要跨年对齐或和其他数据库统一时,直接使用 ISOWEEK 更可靠。
SQL Server:配合 ISO 周参数使用
SQL Server 中建议使用:
SET DATEFIRST 1;
DATEPART(ISO_WEEK, date_col)
SET DATEFIRST 1 用来设置周一为每周第一天;如果直接使用 DATEPART(week, date_col),结果会受服务器默认设置影响,跨环境时尤其容易出现偏差。
统计每周新增用户,先明确“新增”口径
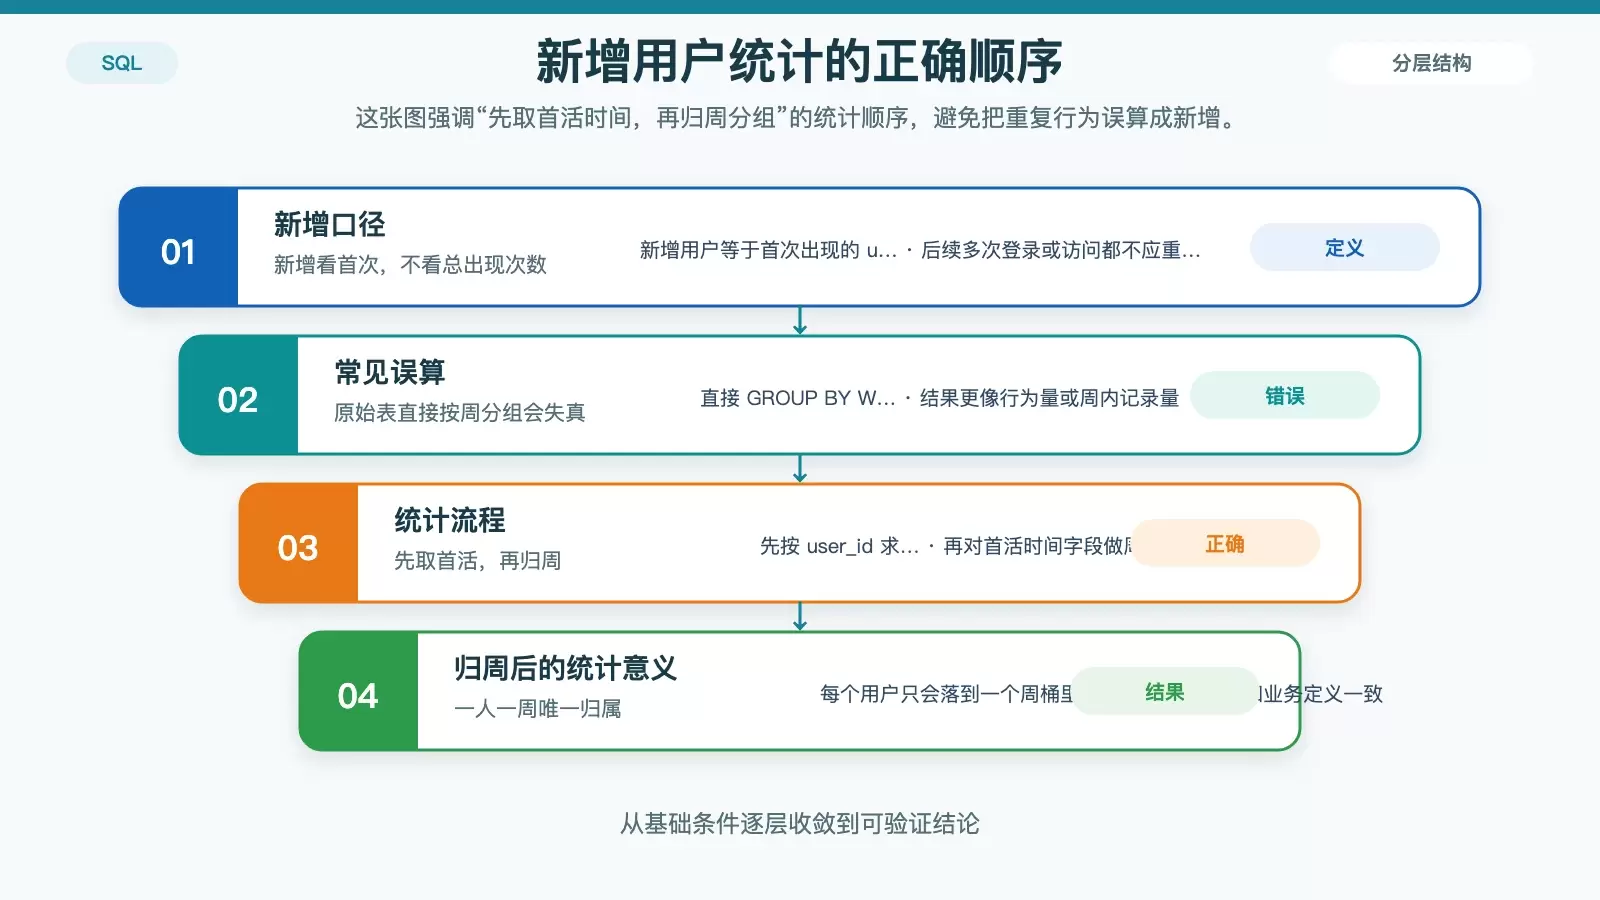
“新增用户”不是某周里出现过的用户,而是首次出现的用户 ID。也就是说,一个用户无论后续登录多少次,都只能在第一次出现的那一周被记为新增。
如果你直接在原始行为表上写:
GROUP BY WEEK(created_at)这统计出来的并不是“每周新增用户”,而更接近“每周发生过行为的记录量”或“每周注册量”,具体还要看 created_at 代表什么业务时间。
正确顺序:先找首活时间,再归周
更稳妥的做法分两步:
- 先按
user_id取最早时间,比如MIN(created_at)。 - 再对这个最早时间计算周编号并分组。
例如原文给出的思路是先生成“首活时间”结果集,再做周统计:
MIN(created_at)在 MySQL 中,再基于首活时间取周时可以写成:
WEEK(MIN(created_at), 1)实际落地时,通常会用子查询或窗口函数先把每个用户的首次时间算出来,再在外层分组,这样“新增”的定义才不会被重复行为污染。
跨年周为什么容易统计错
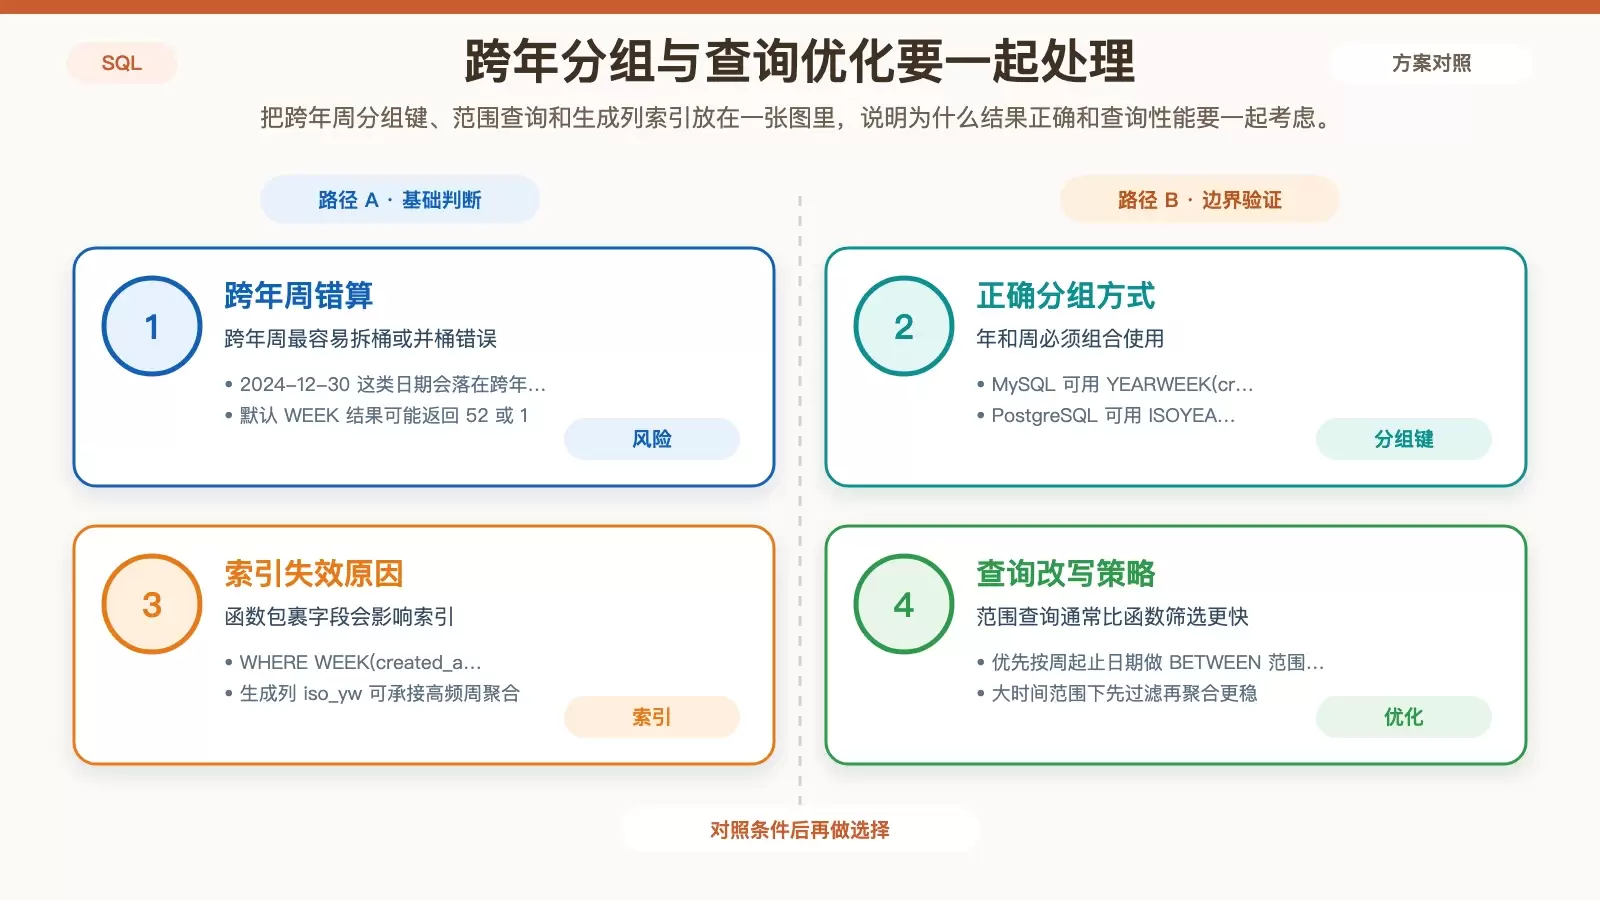
跨年周是周统计里最常见、也最隐蔽的错误来源。比如 2024-12-30 是周一,按 ISO 规则属于第 53 周,但 MySQL 默认 WEEK('2024-12-30') 可能返回 52 或 1,取决于模式参数和年份边界处理方式。
这会带来两个问题:同一个跨年周可能被拆到两个年份桶里,或者不同年份里相同周号的数据被误合并。
不要只用周数分组
只按 WEEK() 的结果分组是危险的,因为“第 1 周”每年都会出现。周统计要可用,分组键必须同时包含“年”和“周”。
更稳的分组键写法
原文给出的建议是直接生成 ISO 年周组合键:
MySQL:
YEARWEEK(created_at, 1)它会返回类似 202453 这样的整数,既便于排序,也适合作为分组键。
PostgreSQL:
EXTRACT(ISOYEAR FROM ...) * 100 + EXTRACT(ISOWEEK FROM ...)这样可以把 ISO 年和 ISO 周拼成同类整数键,避免单独使用 EXTRACT(WEEK FROM ...) 带来的错位问题。
展示层再格式化
如果前端想显示成 2024-W53 这种形式,建议在展示层处理,而不是在 SQL 里拼字符串。原因很直接:整数键更利于排序,也更容易配合索引使用。
性能陷阱:对时间字段直接套 WEEK 会拖慢查询
当你在条件或分组里直接写:
WHERE WEEK(created_at) = 5或者:
GROUP BY WEEK(created_at)数据库通常无法直接利用 created_at 上的普通 B-tree 索引,因为函数计算打断了原始值的有序性。数据量一大,扫描成本会明显上升。
优先改成日期范围查询
如果目标是查某一个 ISO 周,更推荐先算出这一周的起止日期,再按范围过滤。例如第 5 周对应:
created_at BETWEEN '2024-01-29' AND '2024-02-04'这种写法更容易命中已有时间索引,执行计划通常也更稳定。
需要长期聚合时,考虑生成列索引
如果周统计是高频查询,可以建立计算列或生成列索引。原文给出的 MySQL 方案是:
ALTER TABLE users ADD COLUMN iso_yw INT AS (YEARWEEK(created_at, 1)) STORED适用版本说明也要保留:MySQL 5.7+、PostgreSQL 12+ 可以考虑这类方案。这样做的好处是,把高频的周维度计算前置,避免每次查询都对全表重复执行函数。
大时间范围下,先过滤再聚合
如果查询时间跨度很大,更合理的顺序是先用日期区间缩小数据集,再做周聚合,而不是一上来就对全表计算 WEEK 后再筛选。这个差别在百万级以上数据表里会非常明显。
写周统计 SQL 之前,先检查这三个条件
要让“每周新增用户”统计结果可信,至少要同时满足三件事:
- 周定义统一,优先按 ISO 周处理。
- 新增口径明确,必须按用户首次出现时间归周。
- 分组键和查询方式可执行,跨年不混、索引不失效。
真正麻烦的从来不是怎么写一个 WEEK(),而是周口径、用户首活定义、性能策略能不能对齐。只要这三点没有统一,哪怕 SQL 能跑出结果,这个结果也很难直接拿去做业务判断。









