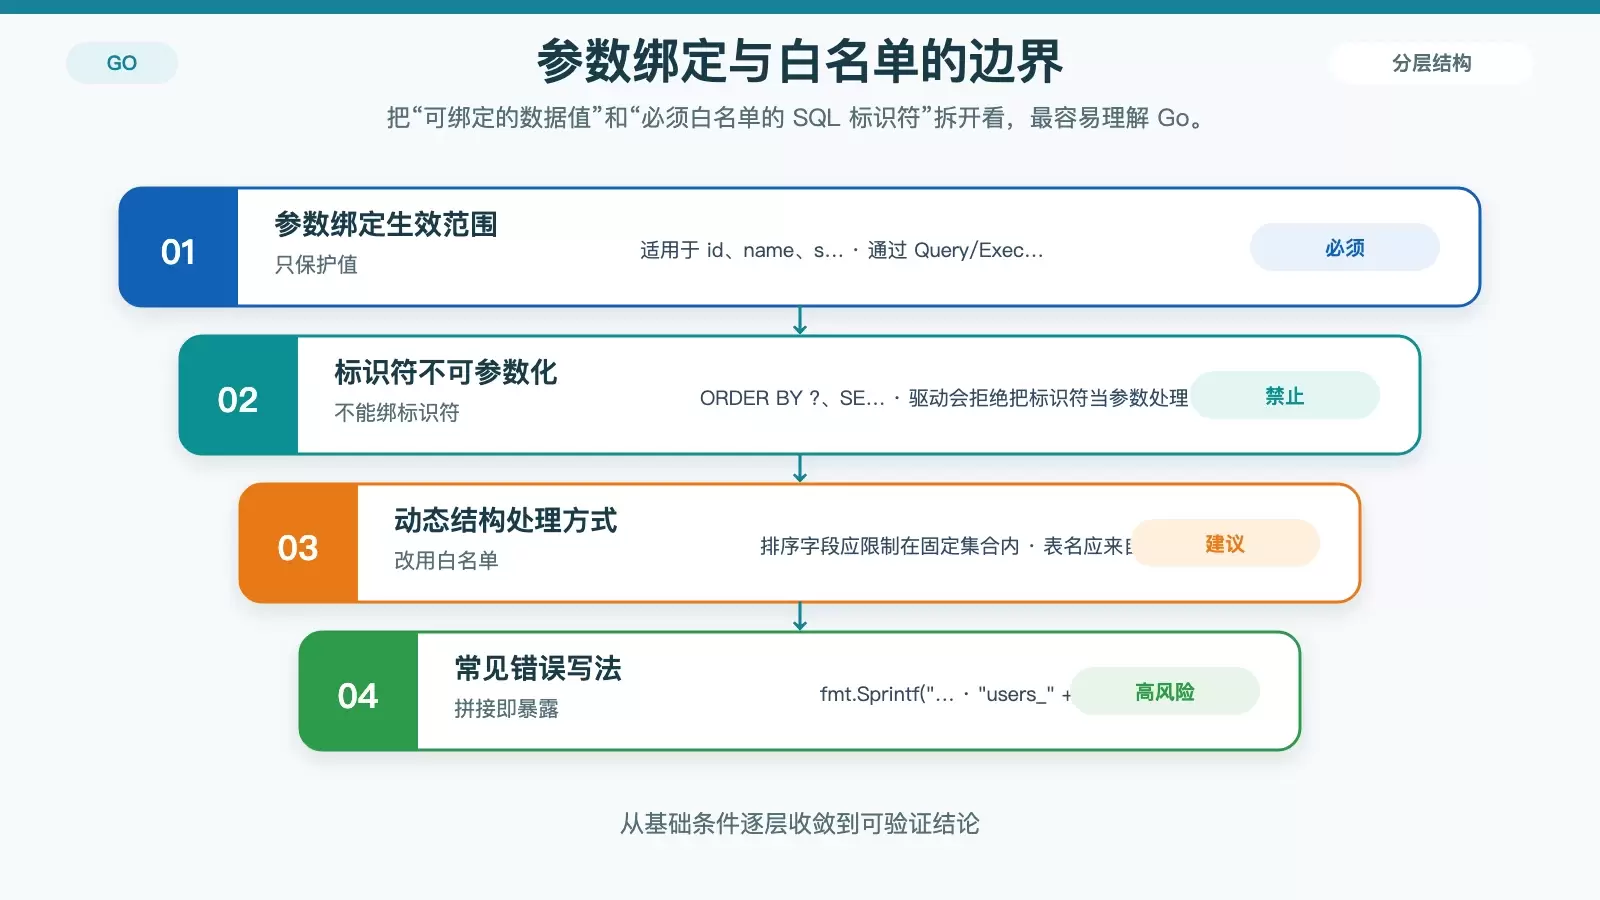
Go 1.22 项目如何防止 SQL 注入:参数绑定、白名单与 GORM 风险点
在 Go 1.22 项目里防 SQL 注入,关键不是只会写 `?`,而是同时把“参数绑定”和“标识符白名单”两件事做好。本文结合 `database/sql`、GORM 和 `Scan` 的常见误区,梳理哪些场景能参数化、哪些必须白名单校验,以及报错出现时该如何定位。
2026-08-23
162

在 Go 1.22 项目里防 SQL 注入,关键不是只会写 `?`,而是同时把“参数绑定”和“标识符白名单”两件事做好。本文结合 `database/sql`、GORM 和 `Scan` 的常见误区,梳理哪些场景能参数化、哪些必须白名单校验,以及报错出现时该如何定位。
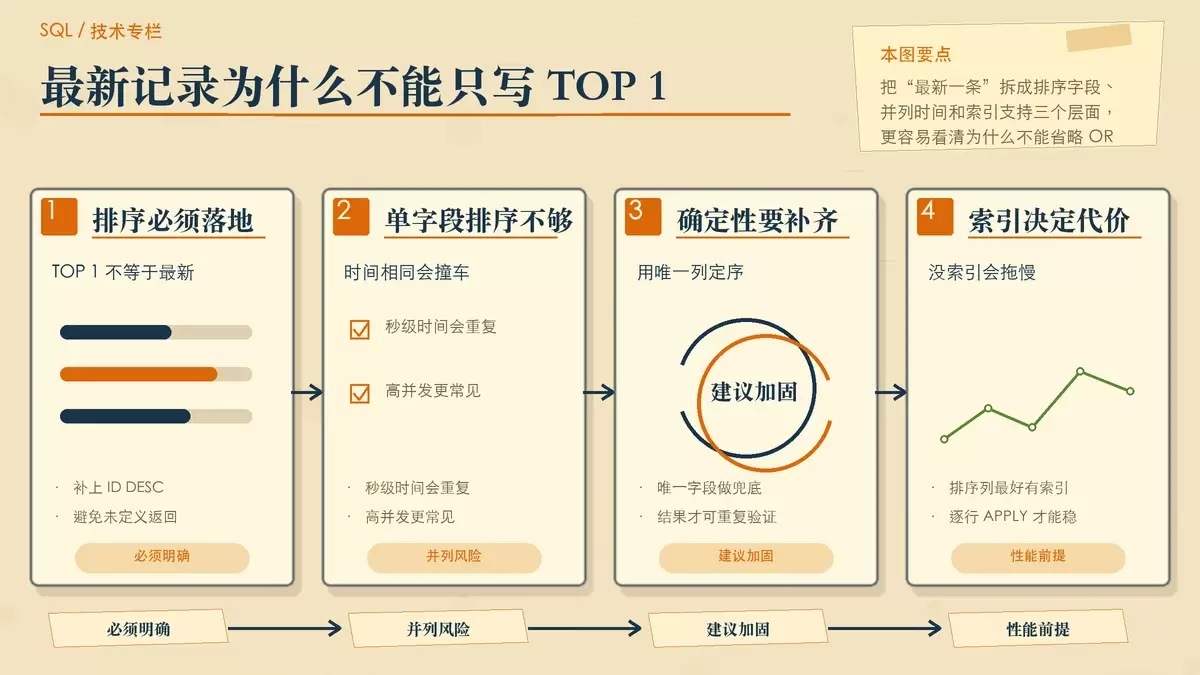
在 SQL Server 里用 APPLY 取“每组最新一条”时,语法能跑通不代表结果可靠。本文围绕 TOP 1 的排序确定性、CROSS APPLY 与 OUTER APPLY 的语义差异、关联条件与索引要求,以及 APPLY 相比标量子查询的执行优势,整理出一套更稳妥的写法判断标准。
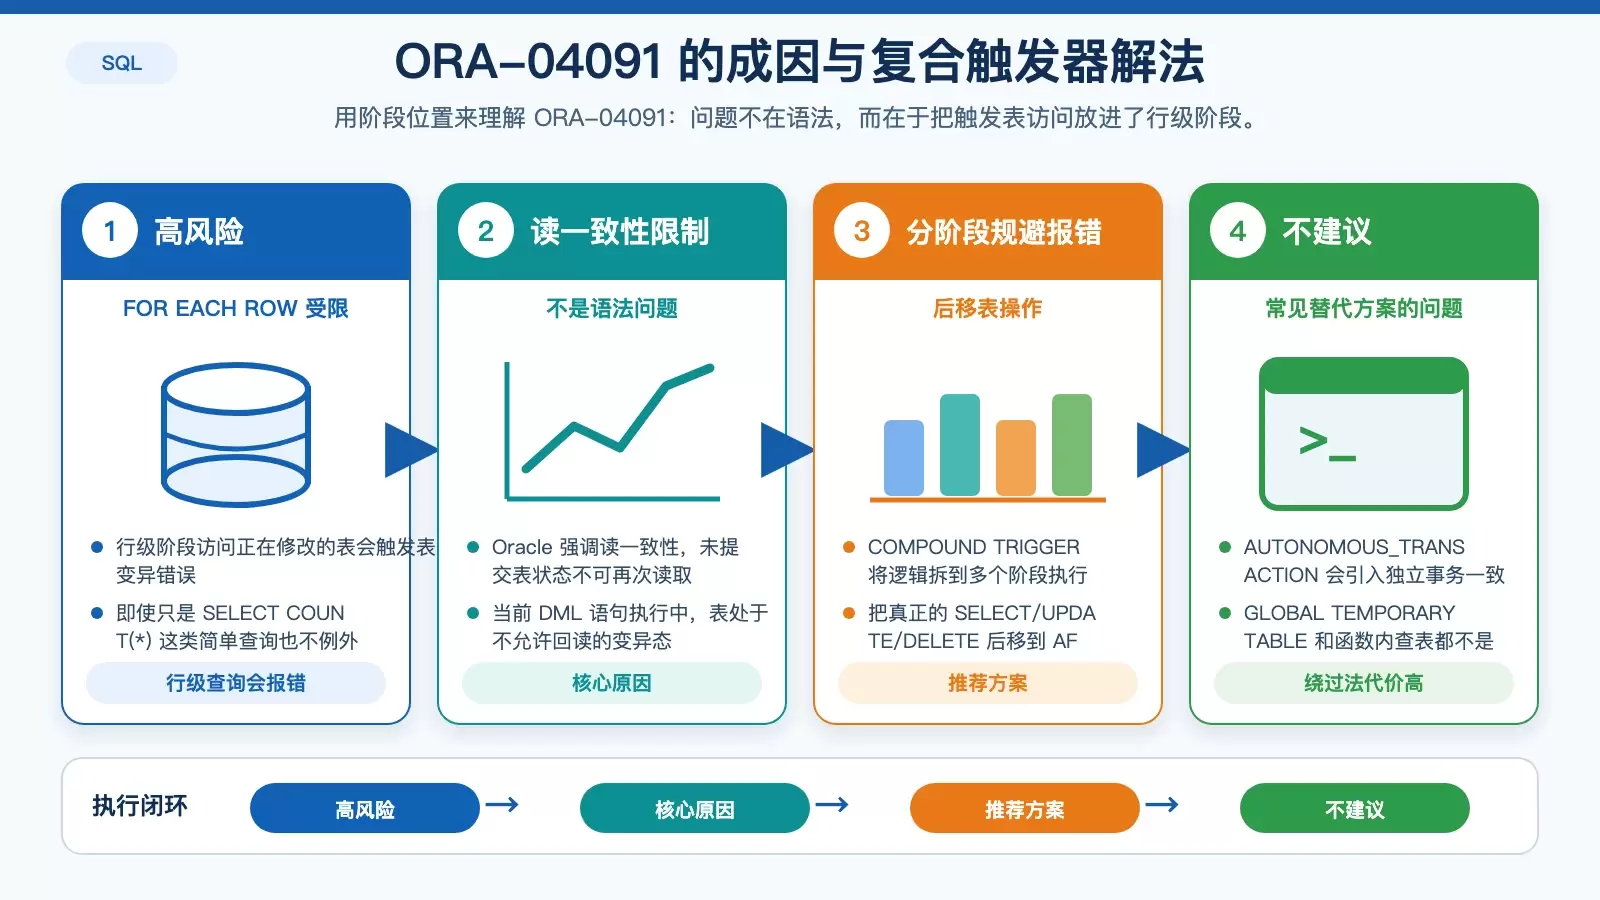
在 Oracle 19c 里,行级触发器一旦直接查询或修改当前触发表,通常就会撞上 ORA-04091。解决思路不是绕事务,而是改用 COMPOUND TRIGGER,把数据收集和表访问拆到不同阶段,尤其把真正的查询、更新和汇总后移到 AFTER STATEMENT。
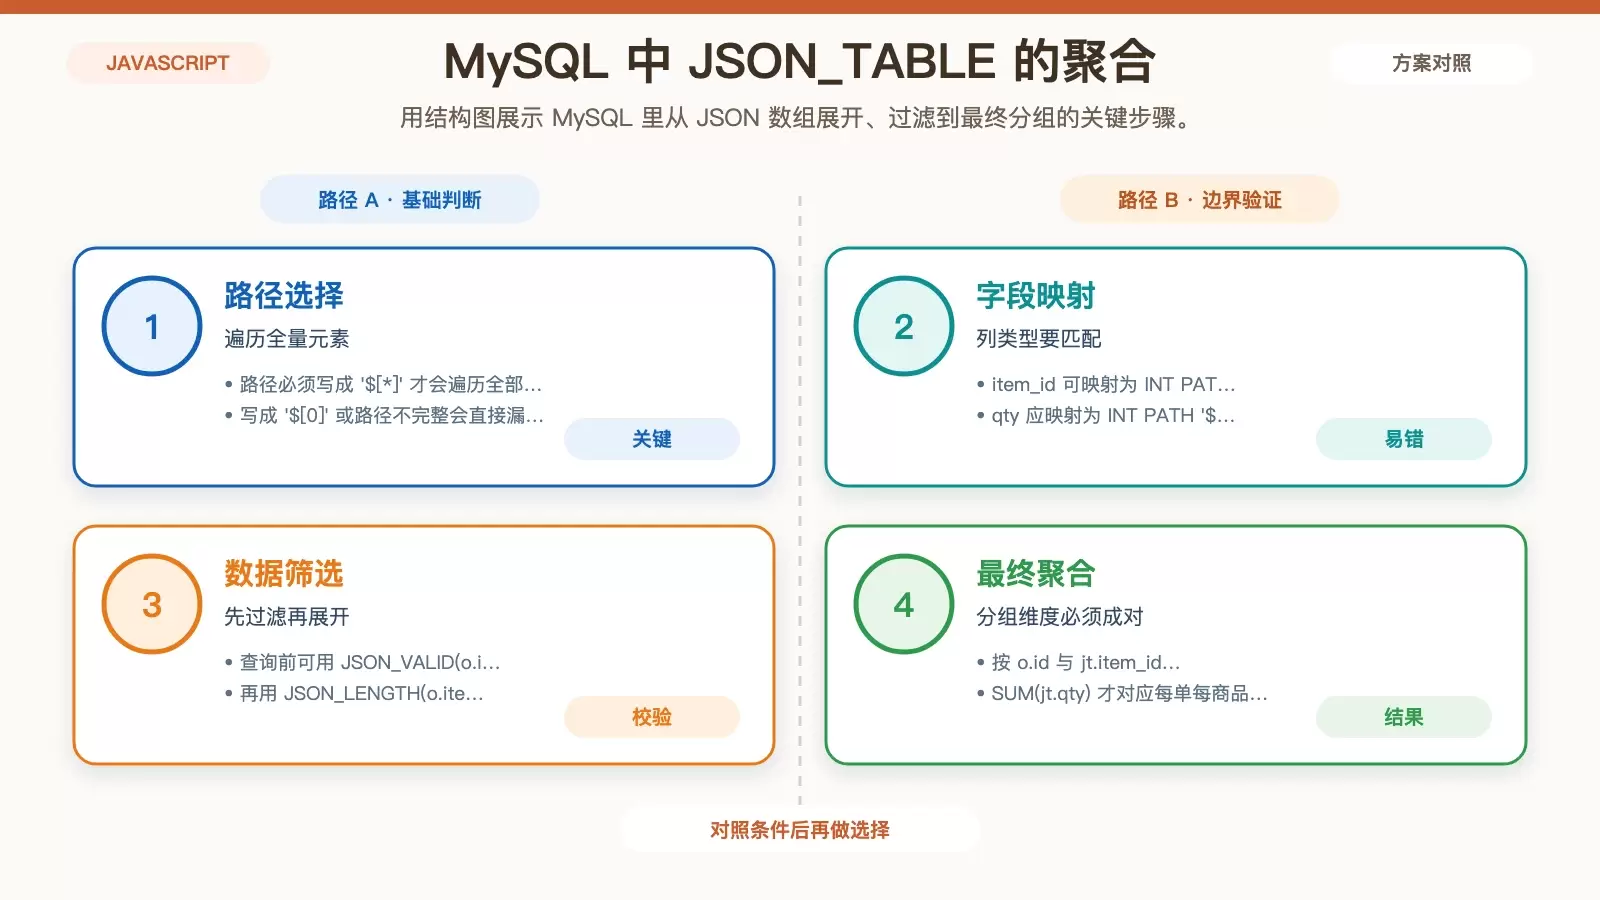
JSON 字段里的数组或对象,不能直接拿来做 `GROUP BY`。这篇文章把 MySQL 8.0+ 的 `JSON_TABLE()` 和 PostgreSQL 的 `jsonb_array_elements()` 拆开说明,并补上类型转换、空值过滤、分组维度选择这些最容易把统计结果做错的关键点。 JSON 字段里有数组或对象时,不能直接 GROUP BY 。正确做法是先展开成行,再按主键或提取字段分组。
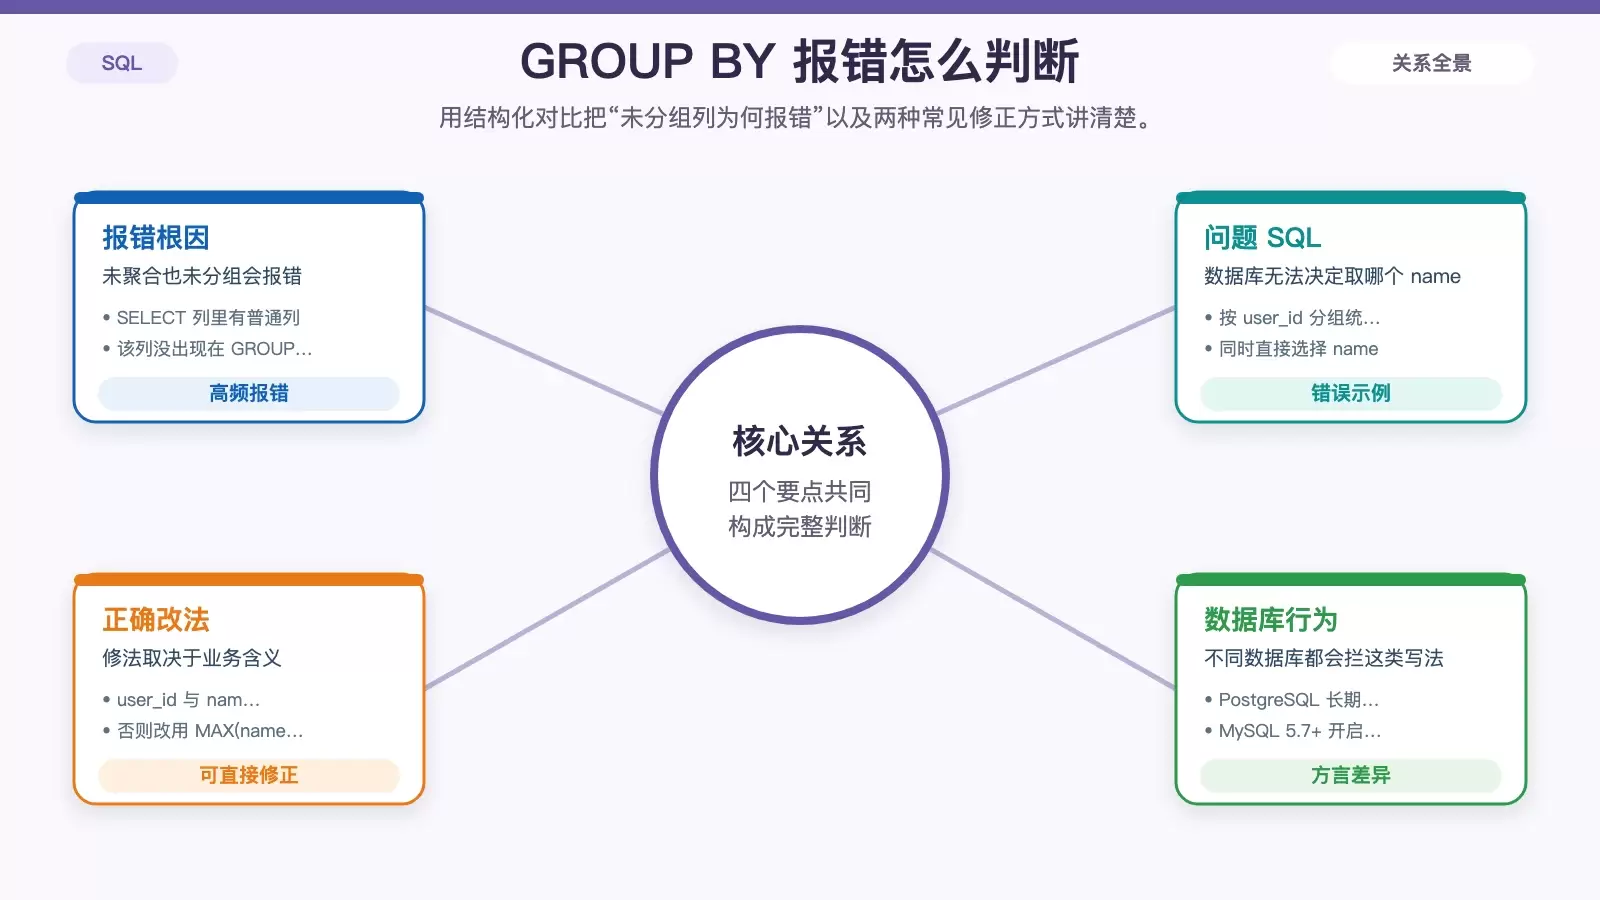
GROUP BY 常见问题并不在语法本身,而在“哪些列能选、哪些条件该先过滤、结果到底按什么维度分组”。这篇文章围绕报错原因、WHERE 与 HAVING 的边界、多字段分组理解,以及 DISTINCT 的替代关系,梳理一套更不容易写错的判断方法。
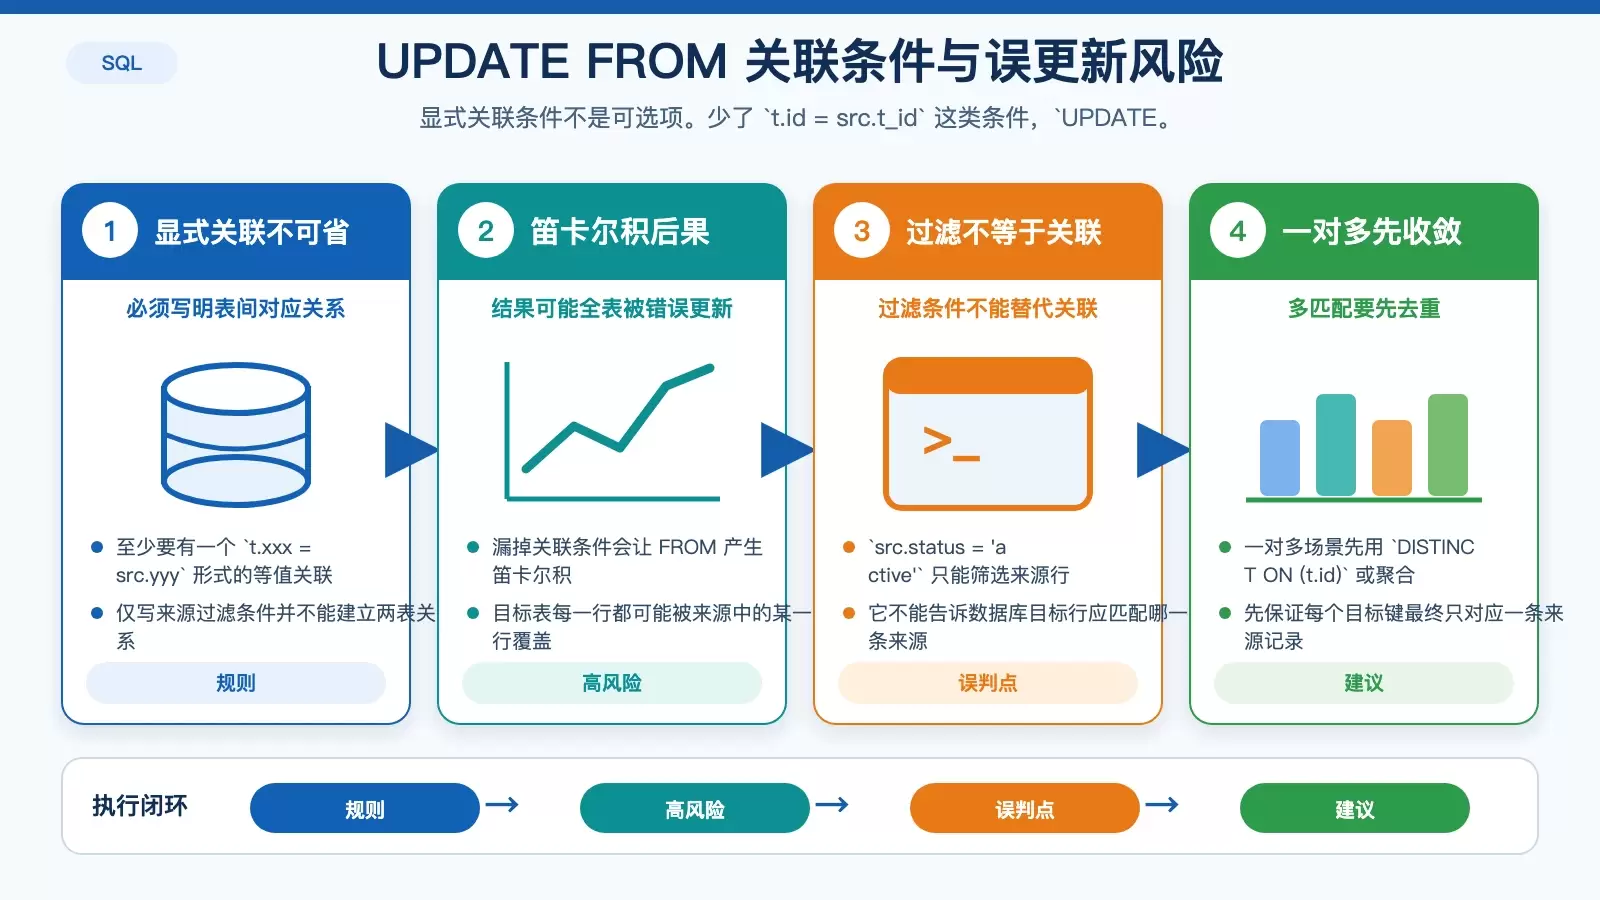
PostgreSQL 16 里的 `UPDATE ... FROM` 很好用,但几个细节处理错了,结果往往不是报错,而是“看起来执行成功,实际改错数据”。这篇文章把目标表声明规则、显式关联条件、子查询别名和更新前验证方法拆开说明,帮助你在写更新语句前先判断风险。
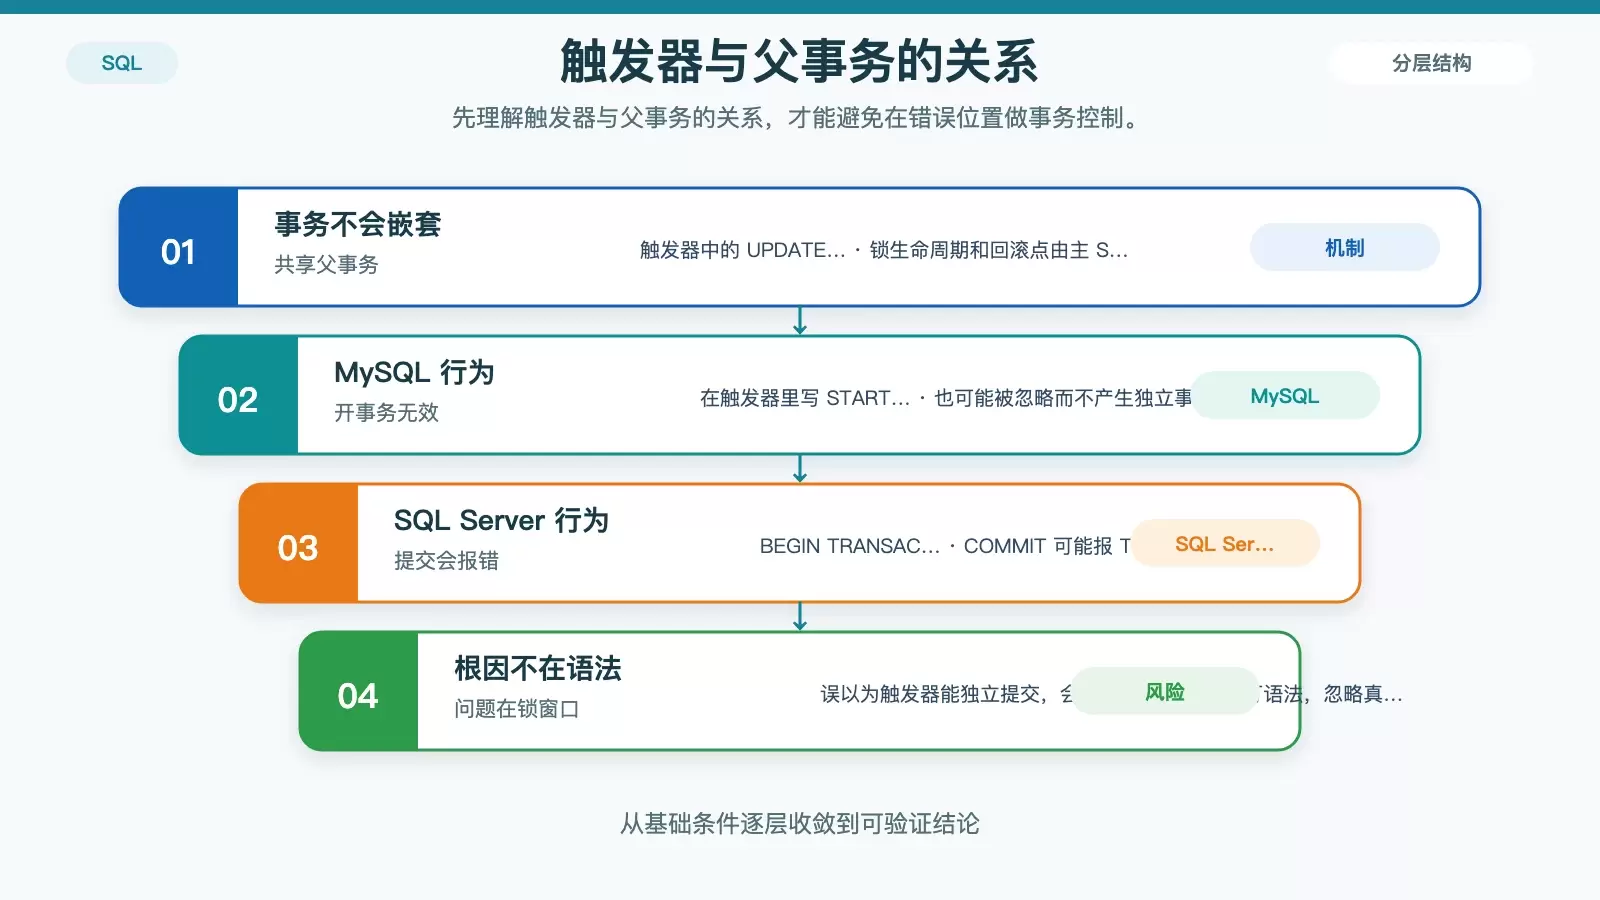
在 MySQL 和 SQL Server 里,DML 触发器并不会开启独立事务,而是直接运行在父事务上下文中。要减少死锁和锁等待,关键不在触发器里“补事务”,而在主事务开头预加锁、让触发器内 DML 只走唯一索引,并把非核心跨表操作尽量移出事务边界。
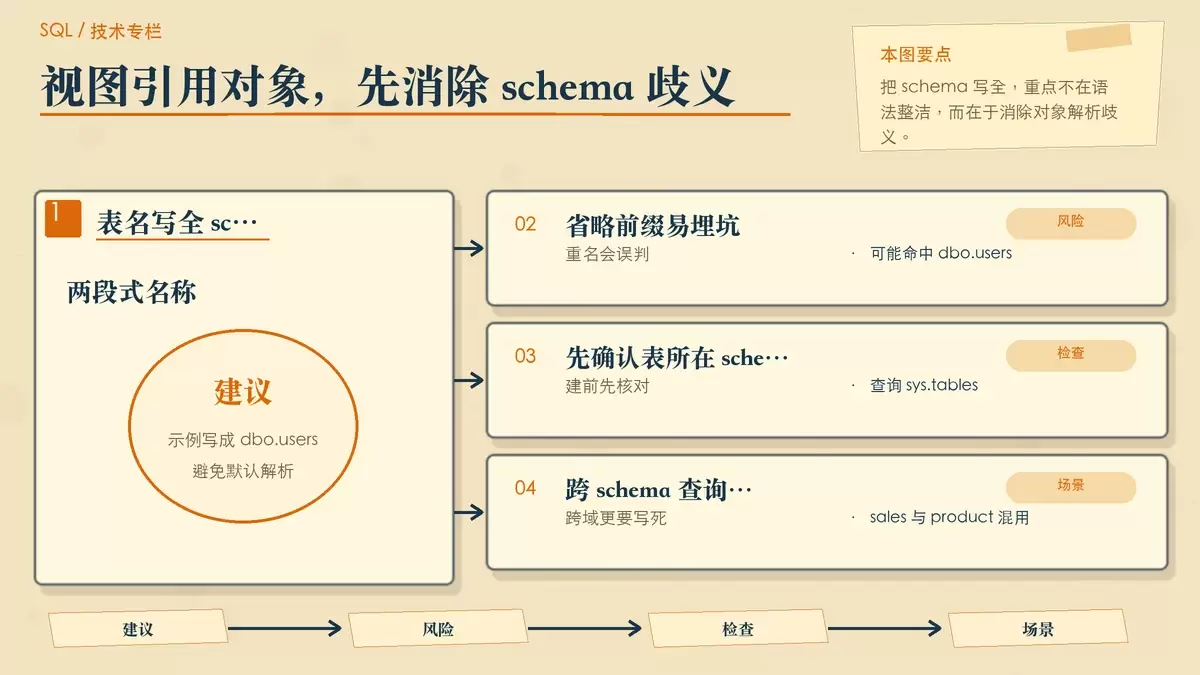
在 SQL Server 2019 里,视图并不只是把一段 SELECT 包起来。真正决定它是否稳定、可维护的,是架构名是否写全、是否启用 WITH SCHEMABINDING,以及过滤和计算逻辑放在什么位置。本文按创建、约束和排障三个层面梳理常见坑点与可执行做法。
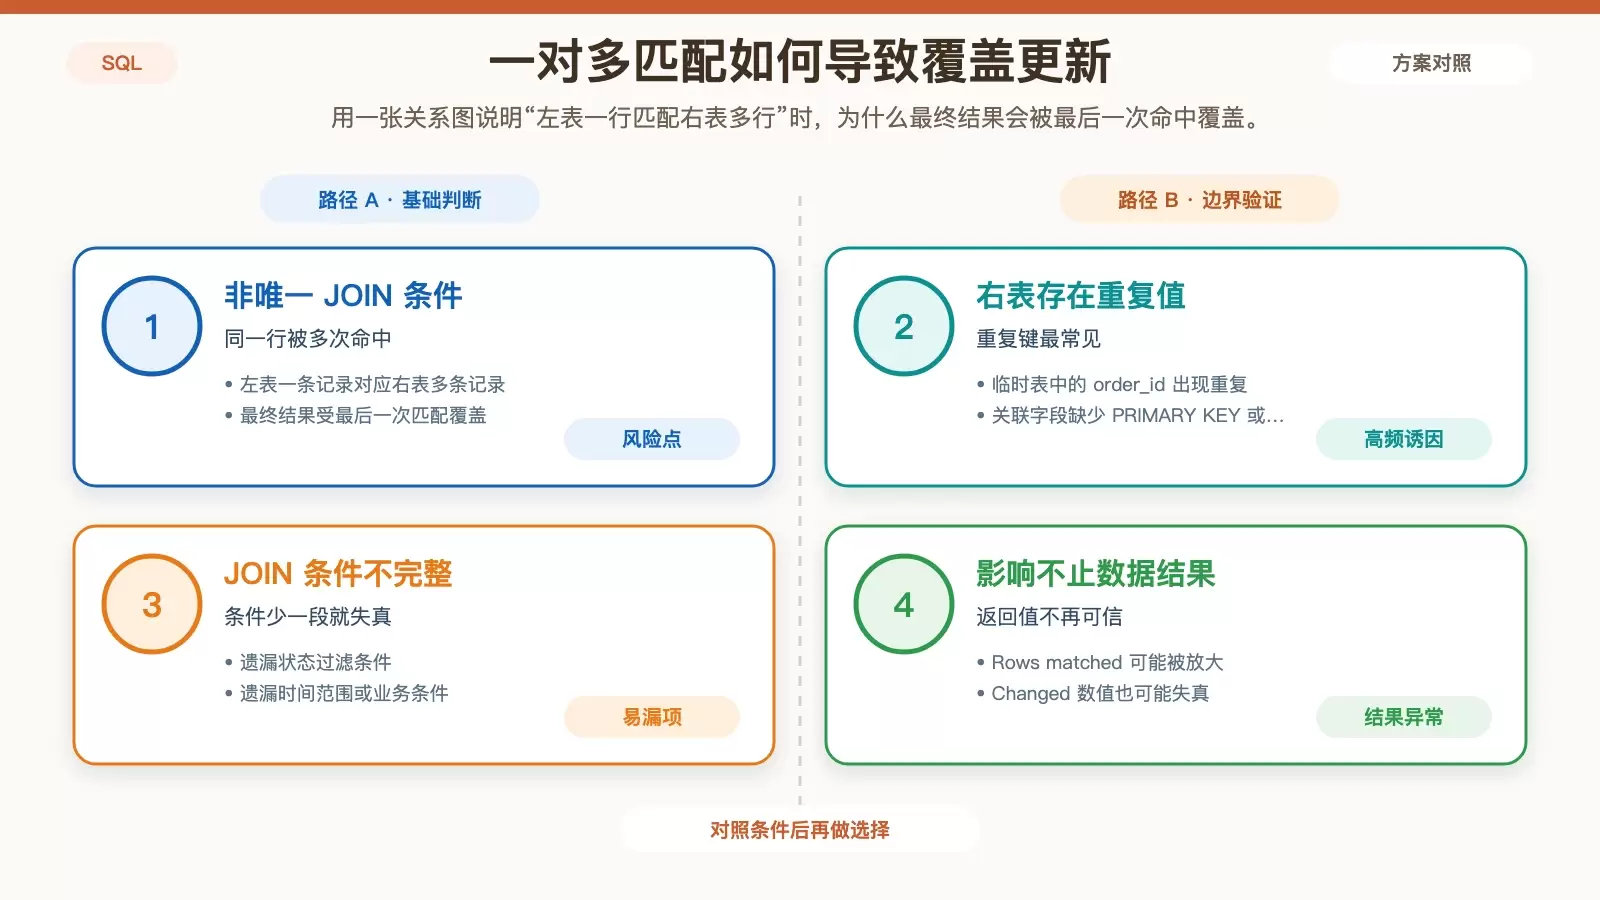
MySQL 的 `UPDATE ... JOIN` 一旦遇到非唯一匹配,往往不会报错,而是让同一行被多次命中,最终只保留最后一次结果。这类问题常由临时表重复、过滤条件缺失或误用 `LEFT JOIN` 引起。本文从成因、排查、改写方式和上线前校验四个方面,梳理一套更稳妥的处理方法。
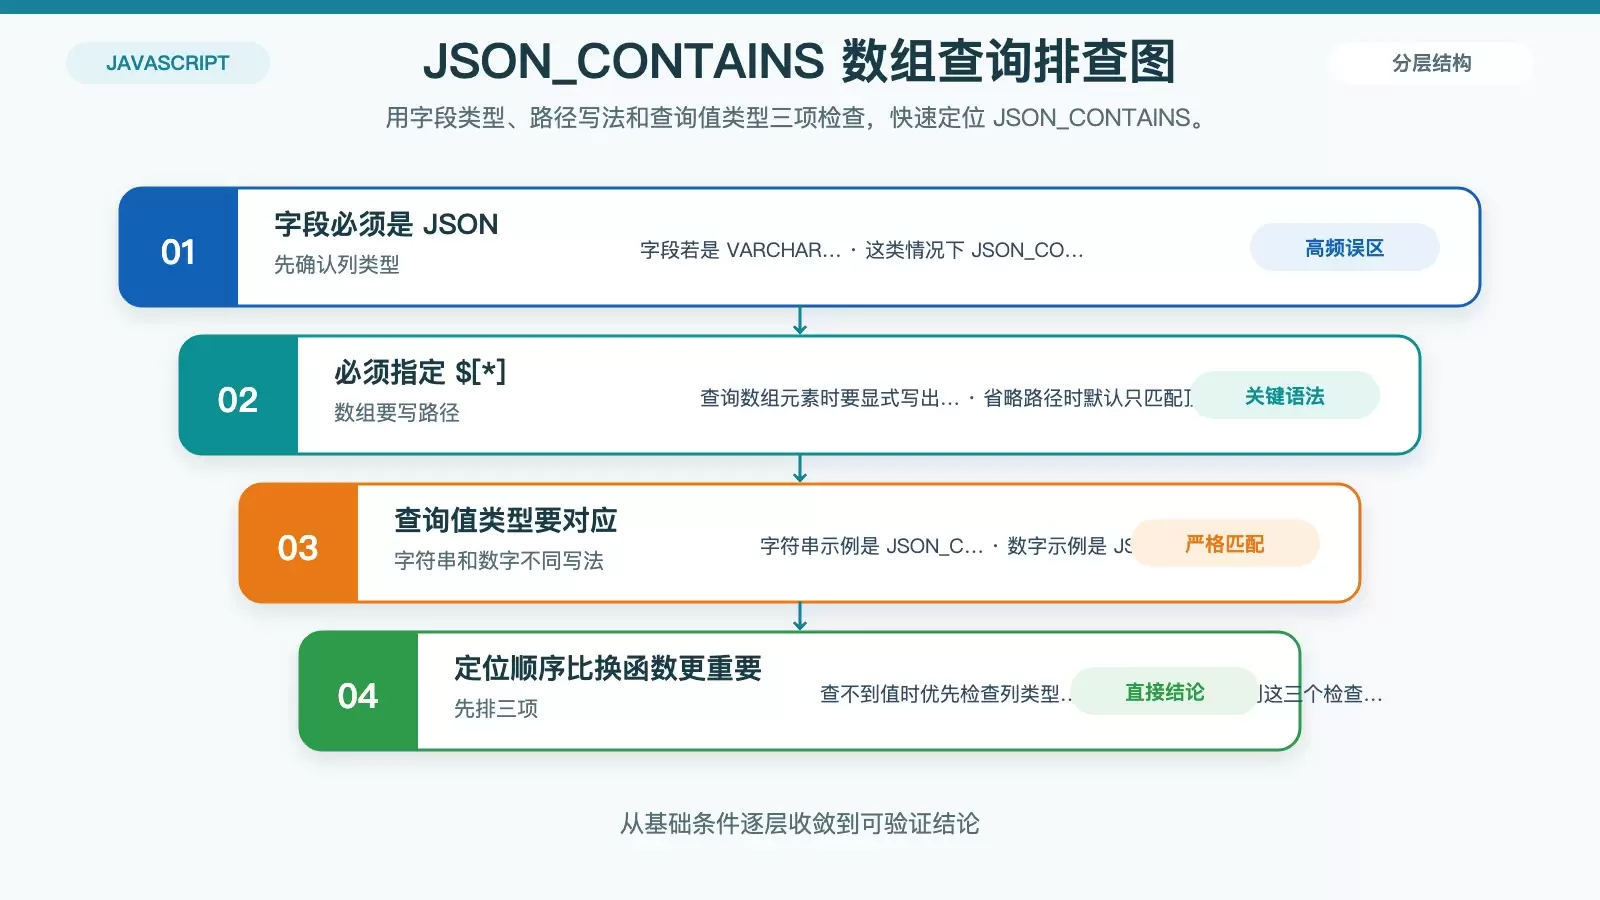
查询 SQL JSON 数组时,最常见的问题不是函数失效,而是字段类型、路径表达式和元素类型没对上。本文用 MySQL 与 PostgreSQL 两套写法,梳理 JSON_CONTAINS、JSON_EXTRACT、JSON_TABLE 与 jsonb 操作符的适用场景、坑点和性能差异。 很多人第一次查 SQL 里的 JSON 数组,都会遇到同一个现象:语句看起来没错,结果却始终查不到。
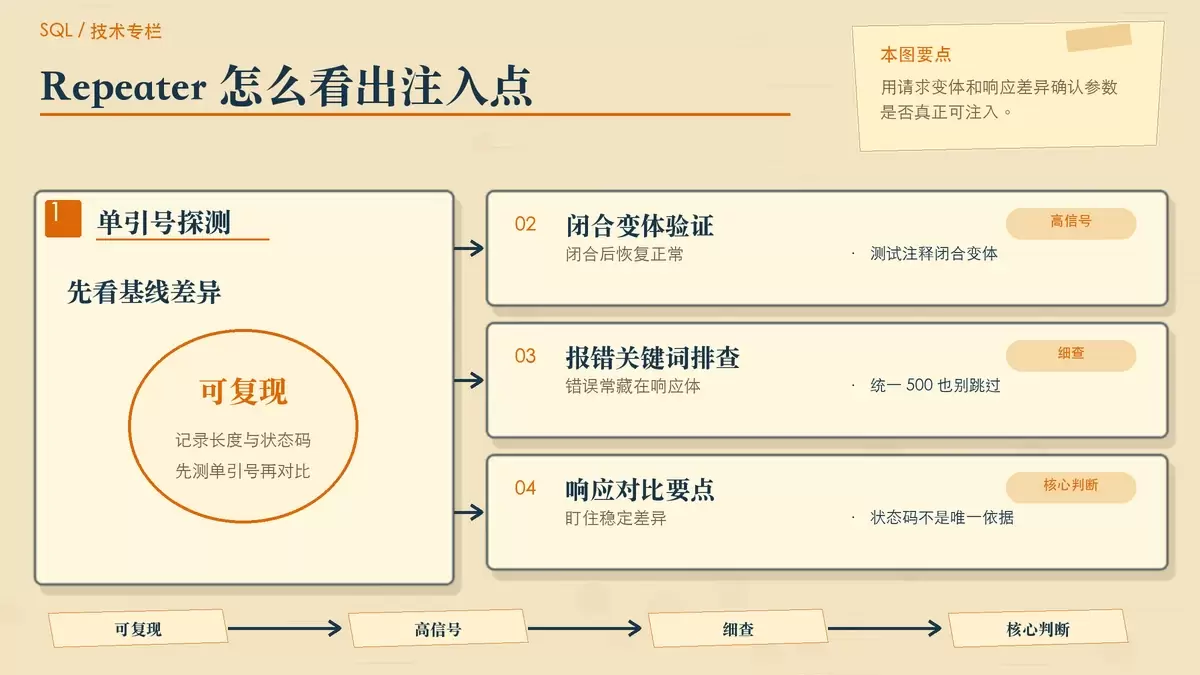
用 Burp Suite 验证 SQL 注入,关键不在“跑没跑扫描器”,而在能否通过 Repeater 和 Intruder 把响应差异抓实。本文按手工确认注入点、区分 Union 与盲注、批量跑布尔盲注、理解 Scanner 漏报四步展开,帮助你判断漏洞是否真实、属于哪一类、后续该怎么验证。
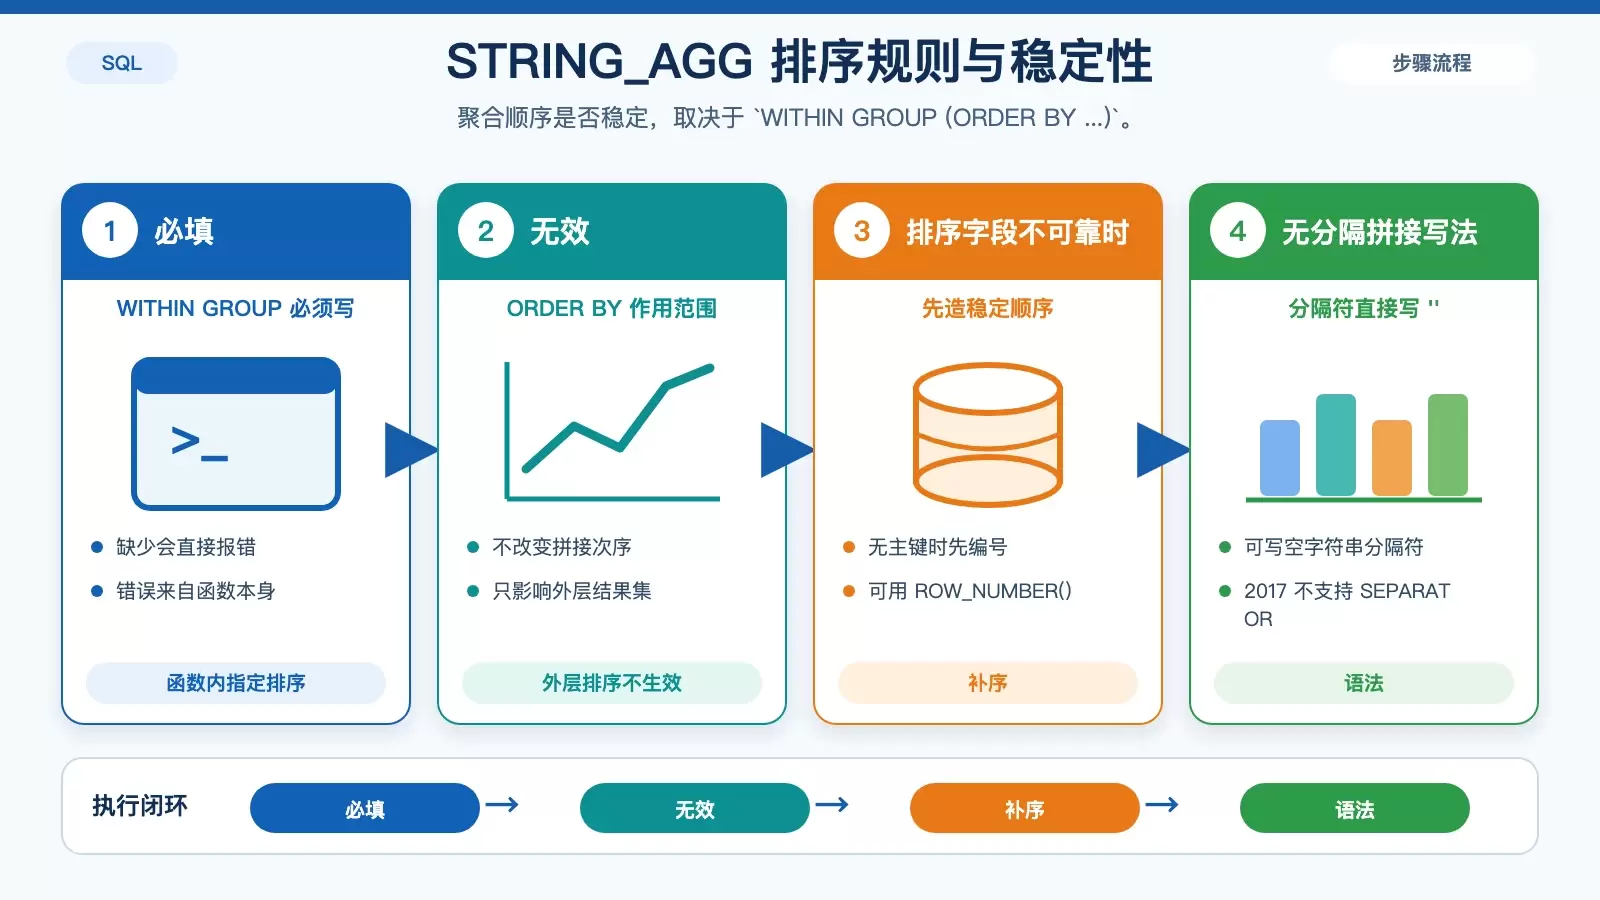
在 SQL Server 2017 及以上版本里,存储过程要把多行文本稳定合并成一个字符串,核心做法是使用 `STRING_AGG`,并明确写出 `WITHIN GROUP (ORDER BY ...)`。真正容易出错的地方不在语法本身,而在排序、`NULL` 处理、去重以及空结果组返回值这几个细节上。