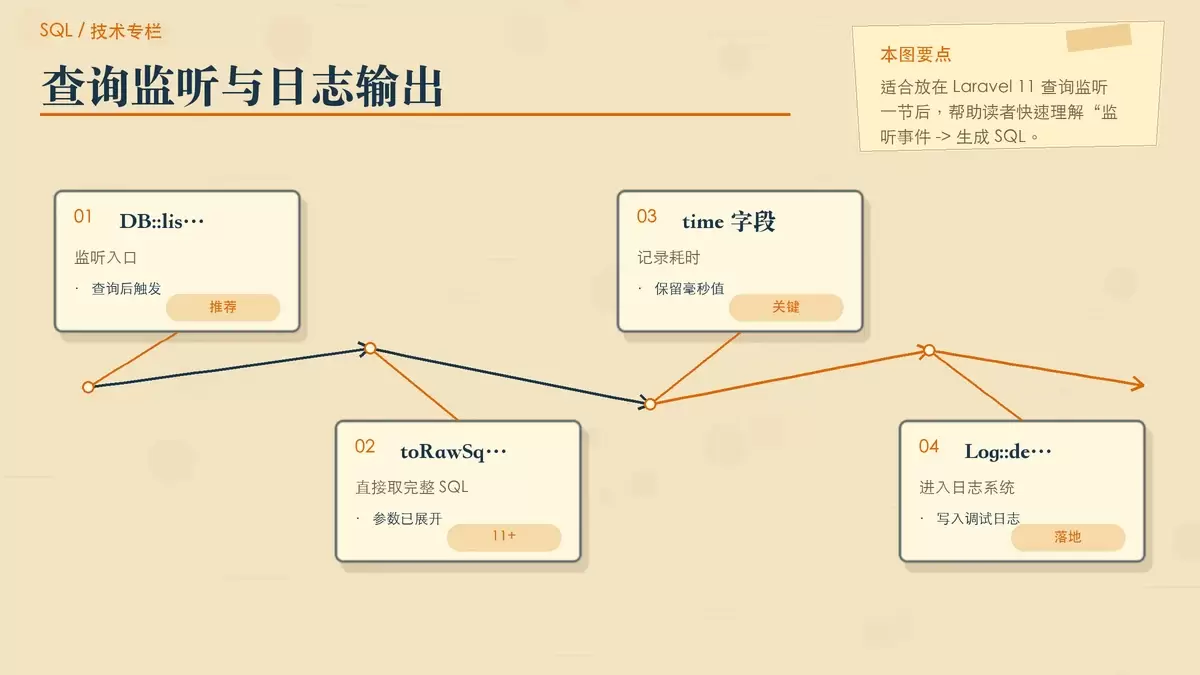
Laravel 中如何把 SQL 打印到日志,并监视慢查询耗时
在 Laravel 排查数据库问题时,把 SQL 与耗时写入日志是最直接的办法。本文基于 Laravel 11 与 Laravel 10 的差异,整理了查询监听、完整 SQL 拼接输出,以及慢查询耗时监视的具体写法,便于你快速接入并判断该用哪种方案。
2026-08-25
198

在 Laravel 排查数据库问题时,把 SQL 与耗时写入日志是最直接的办法。本文基于 Laravel 11 与 Laravel 10 的差异,整理了查询监听、完整 SQL 拼接输出,以及慢查询耗时监视的具体写法,便于你快速接入并判断该用哪种方案。
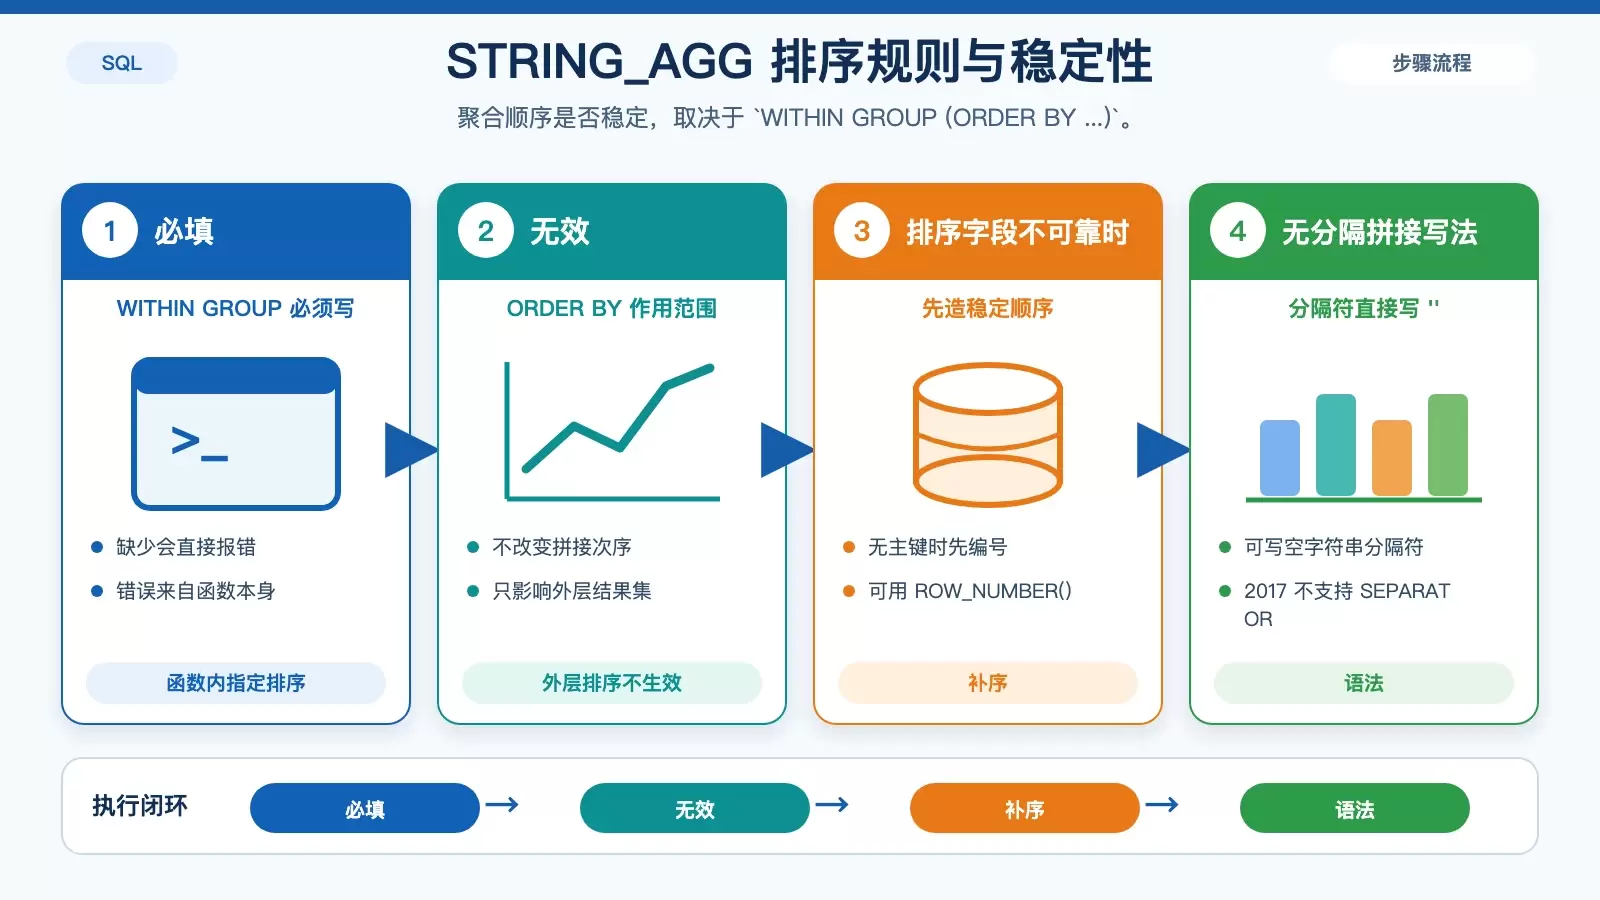
在 SQL Server 2017 及以上版本里,存储过程要把多行文本稳定合并成一个字符串,核心做法是使用 `STRING_AGG`,并明确写出 `WITHIN GROUP (ORDER BY ...)`。真正容易出错的地方不在语法本身,而在排序、`NULL` 处理、去重以及空结果组返回值这几个细节上。
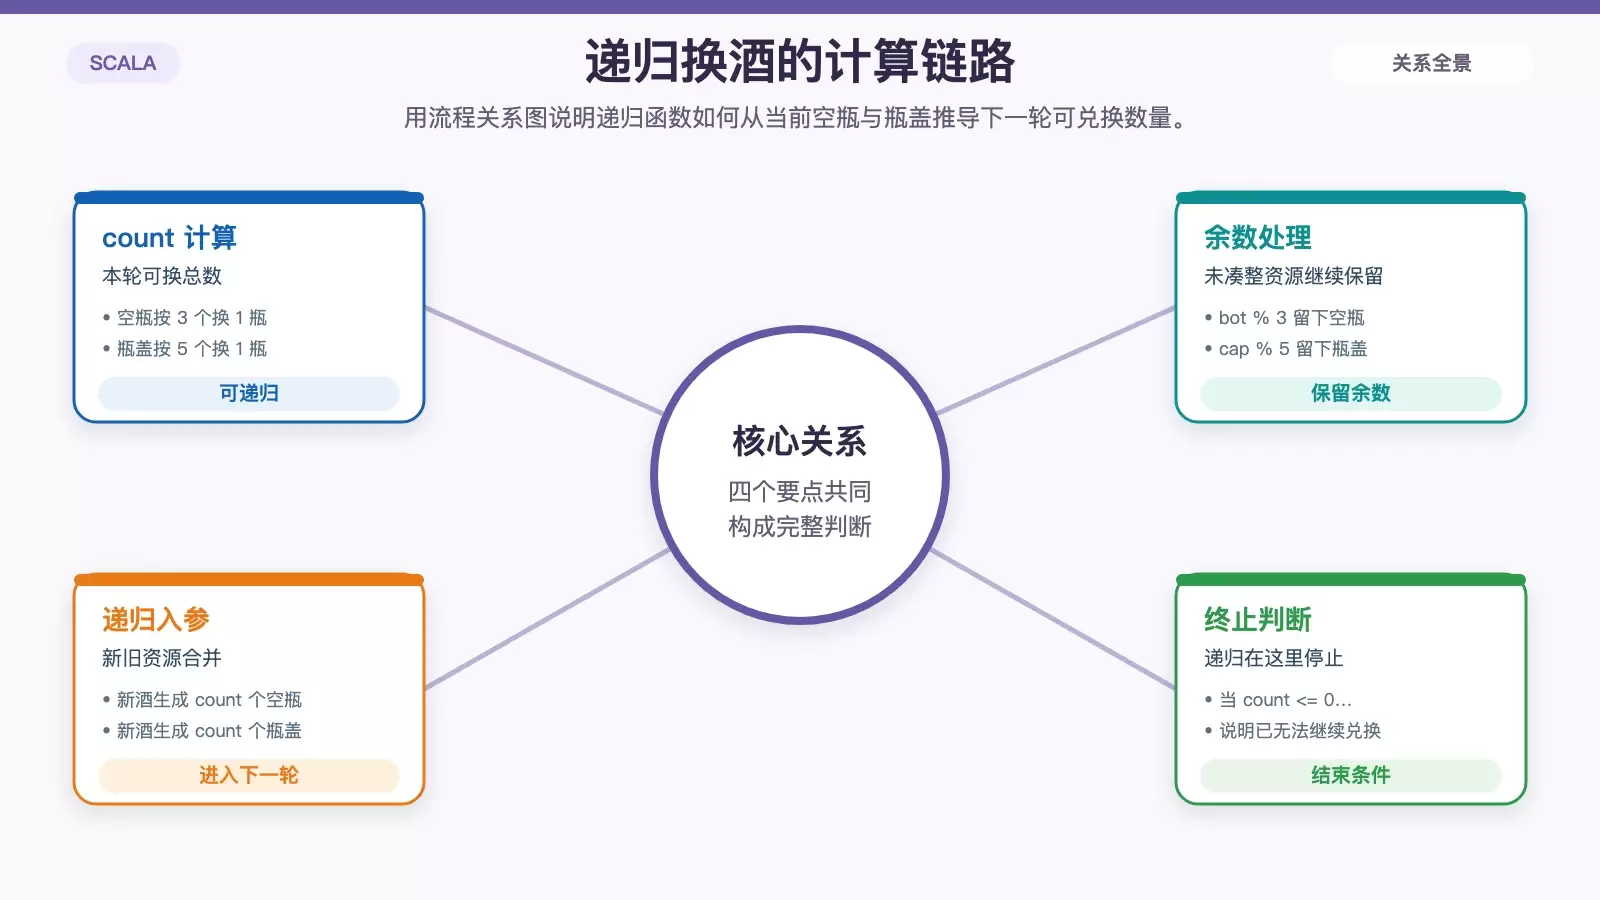
这篇内容把几段常见的 Scala 与 Akka 练习题重新整理成可发布的技术文章,涵盖递归求解“喝酒换瓶”、控制台猜拳、位置时长汇总 SQL,以及 Actor 通讯与 Master/Worker 心跳机制。重点不在堆代码,而是说明每题解决什么问题、核心实现如何运转,以及哪些写法值得直接借鉴。
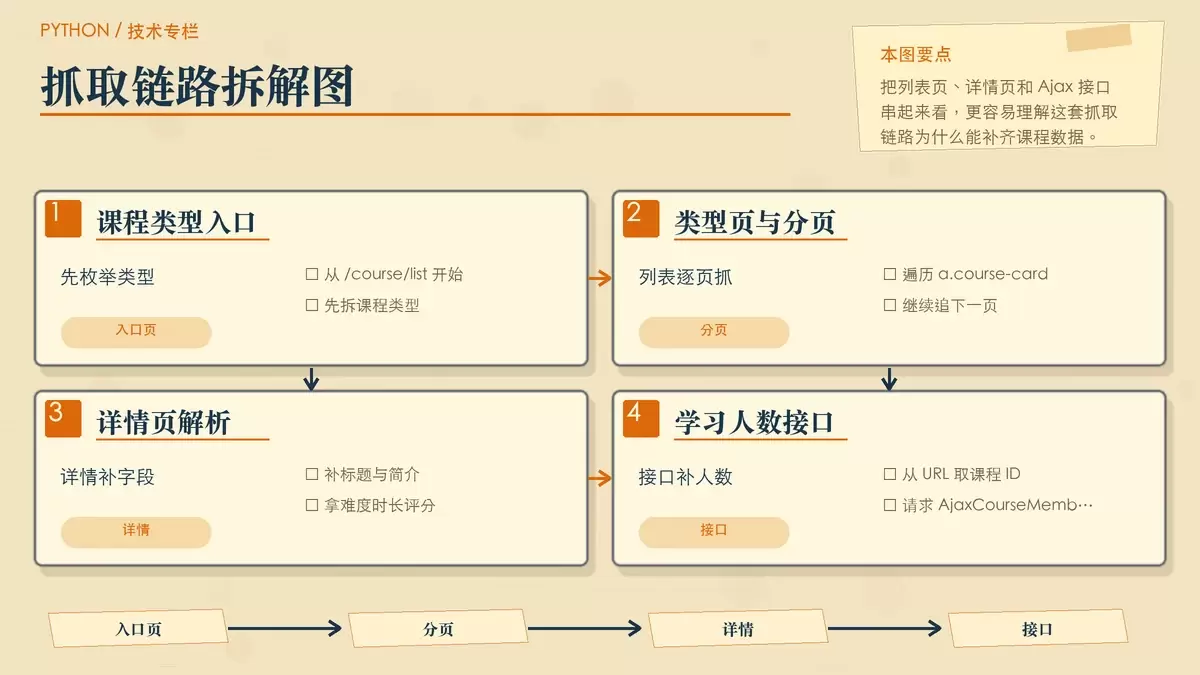
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
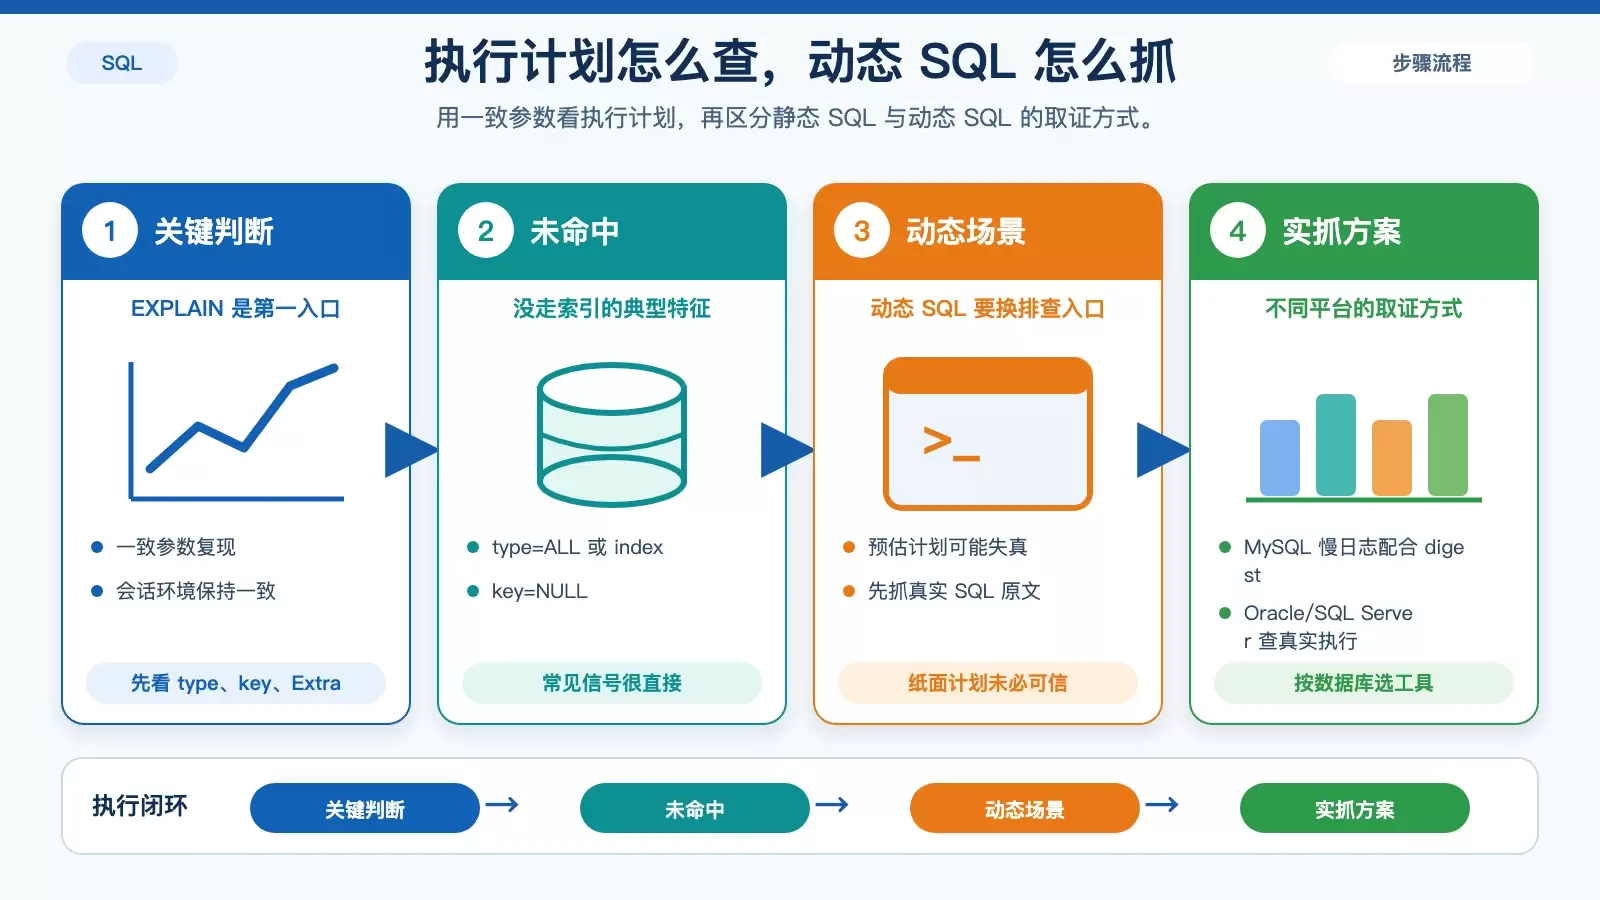
存储过程是否走索引,关键不在“过程”本身,而在其中具体 SQL 被优化器怎样执行。判断时要先用一致参数和会话环境复现,再重点排查隐式转换、复合索引顺序、动态 SQL 与统计信息失真这些高频原因。
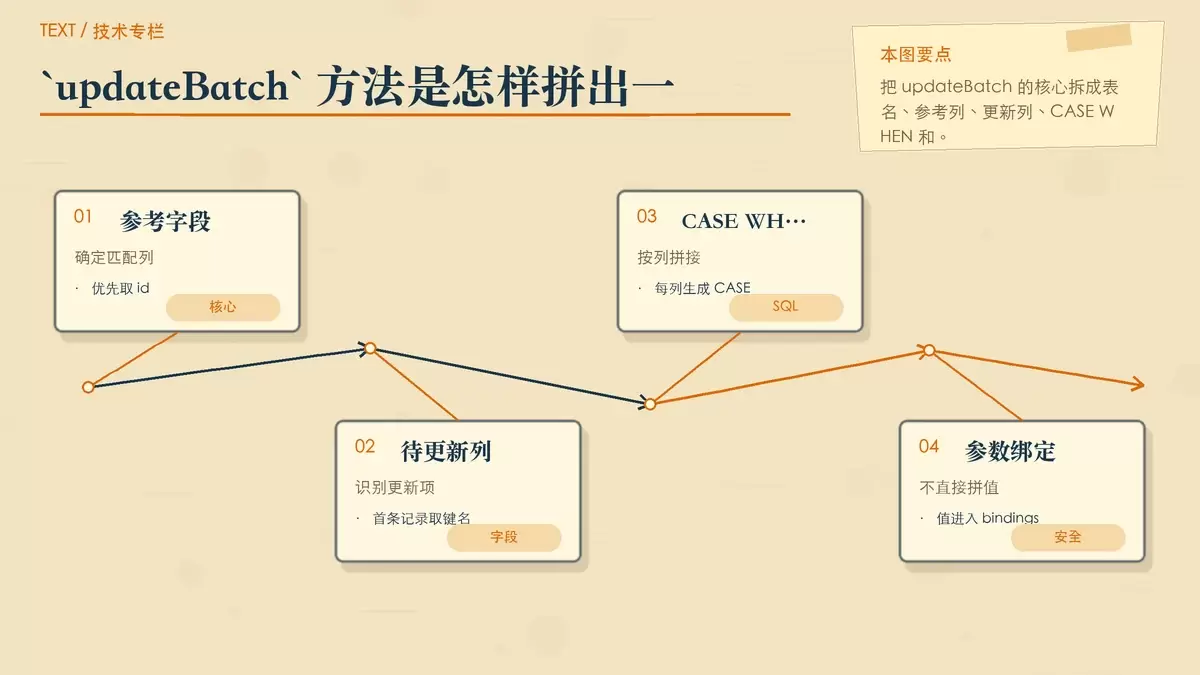
Laravel 原生提供批量插入,却没有像 ThinkPHP `saveAll` 或 CI `update_batch` 那样直接可用的批量更新接口。本文基于 Eloquent 整理出一套可复用的 `CASE WHEN` 批量更新方案,重点保留参数绑定做法,既能一次更新多条记录,也能降低 SQL 注入风险。
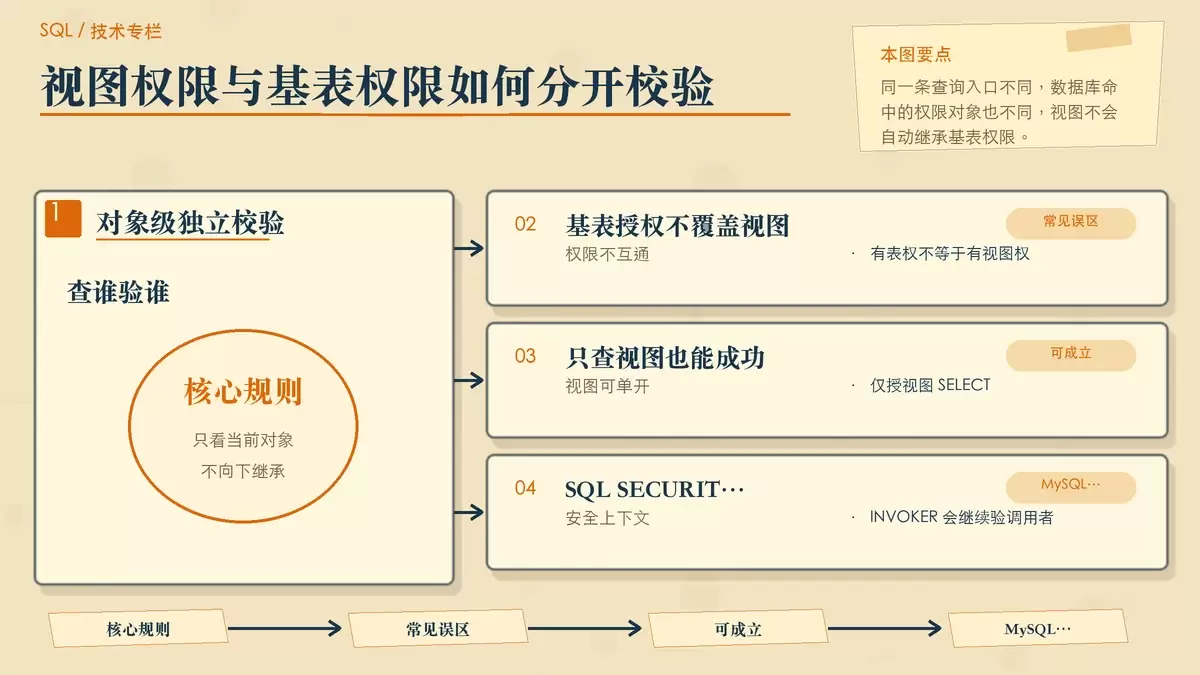
用户能查 SQL 视图却查不了原表,并不是权限漏配,而是数据库把“视图”和“基表”当成两类独立对象分别校验。本文结合 MySQL、SQL Server 与 PostgreSQL 的典型报错,说明权限为何不会自动继承,以及在 MySQL 中如何真正实现“只开放视图、不开放原表”。
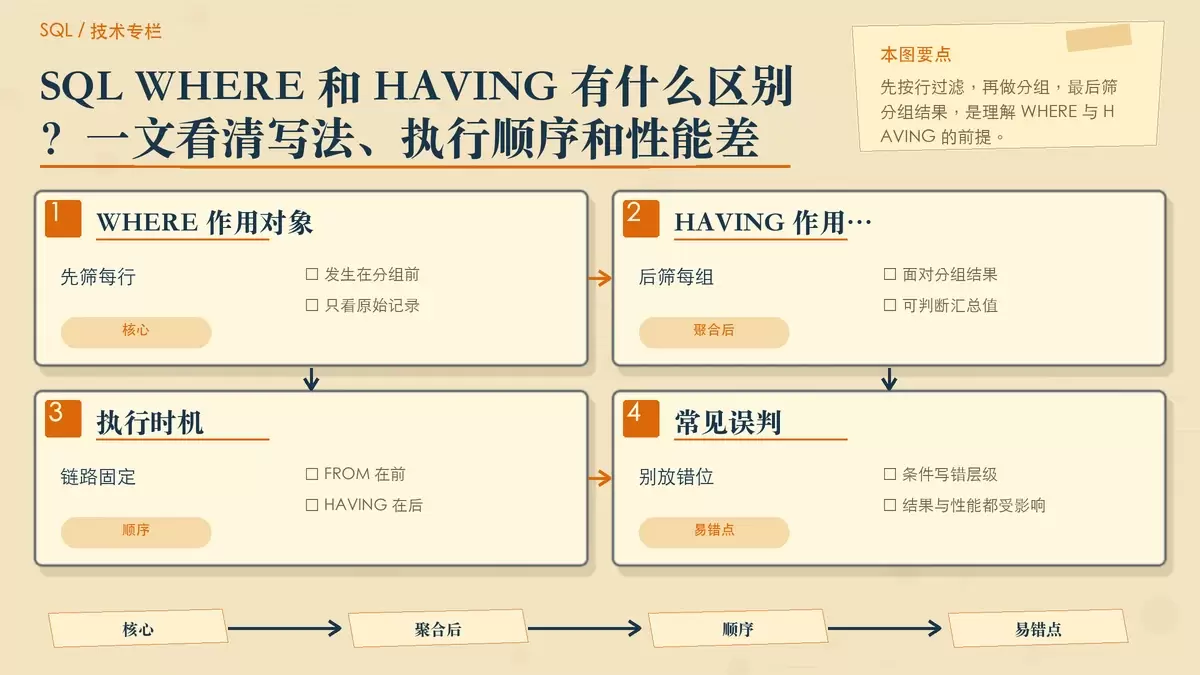
WHERE 和 HAVING 都能“筛数据”,但作用对象和执行时机完全不同:前者筛原始行,后者筛分组结果。把条件写错位置,不仅容易报错,还会让聚合查询白白多做一轮计算,性能差距在大表上尤其明显。
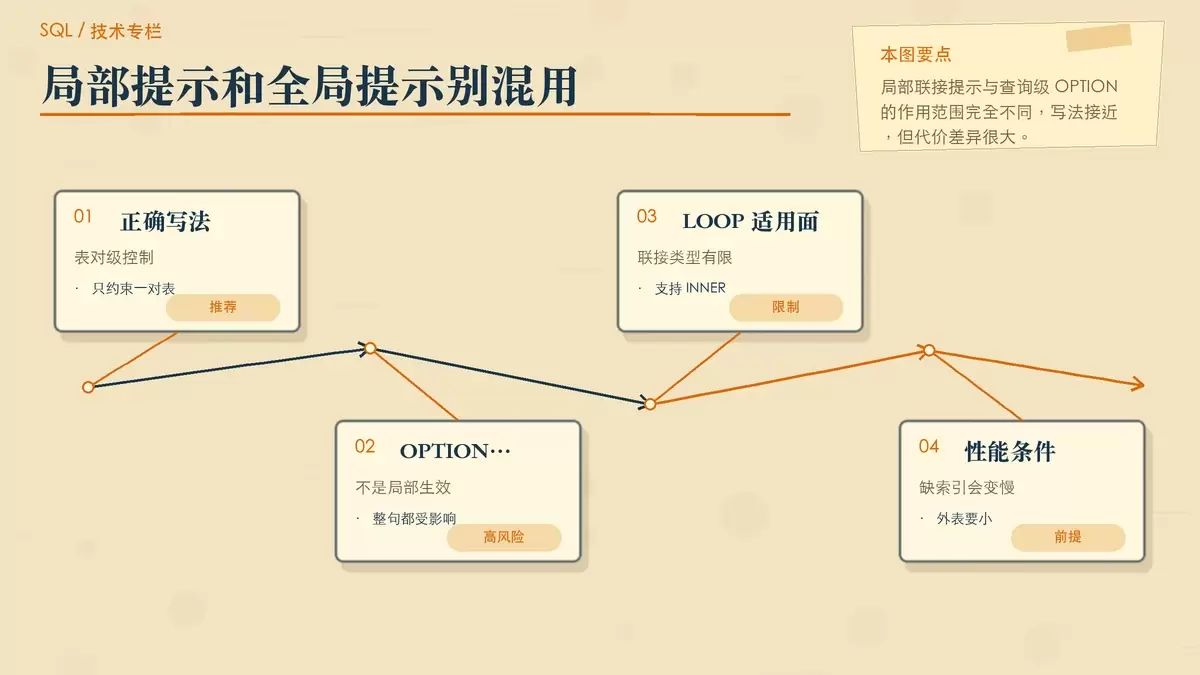
在 SQL Server 里,想强制某一对表使用指定 JOIN 算法,关键不在语句末尾加 `OPTION`,而在 `JOIN` 关键字旁边写对提示。本文把 `LOOP`、`MERGE` 等常见用法、失效原因和验证方法拆开讲清,帮助你判断什么时候该提示、什么时候该让优化器自己选。
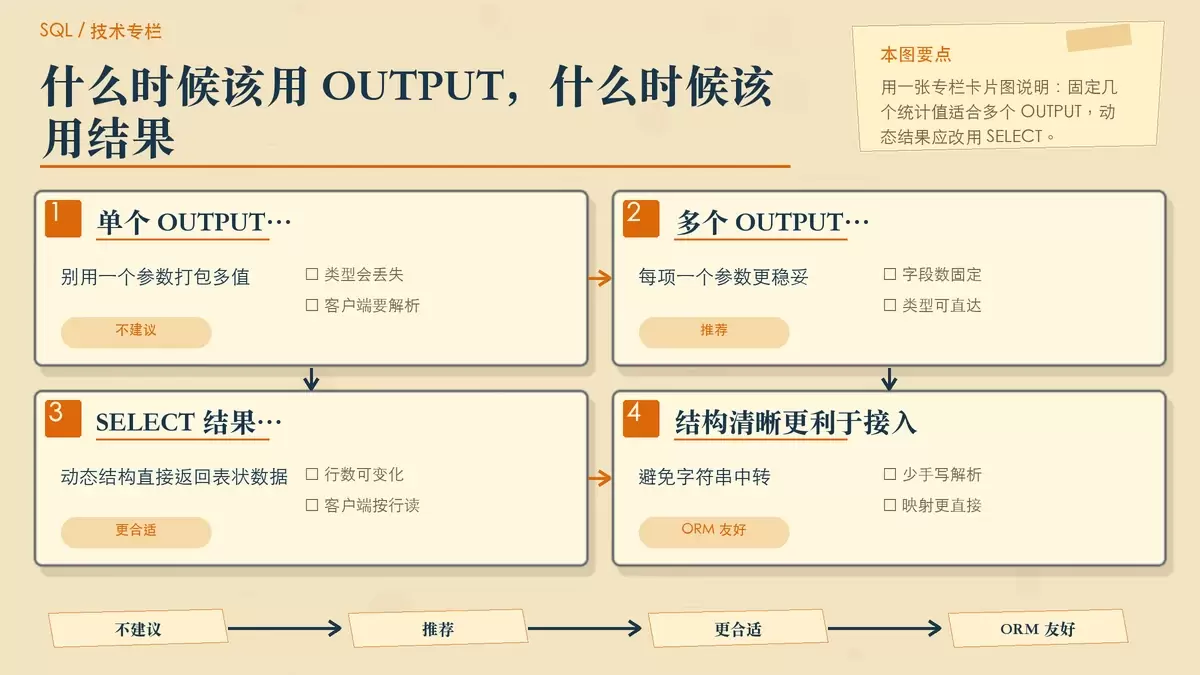
在 SQL Server 里,存储过程的 OUTPUT 参数一次只能回写一个标量值。要返回多个统计结果,正确做法是为每个值单独声明 OUTPUT 参数;如果结果列数或行数不固定,则应直接返回 SELECT 结果集。本文用订单统计示例梳理定义、调用、读取时最容易踩的点。
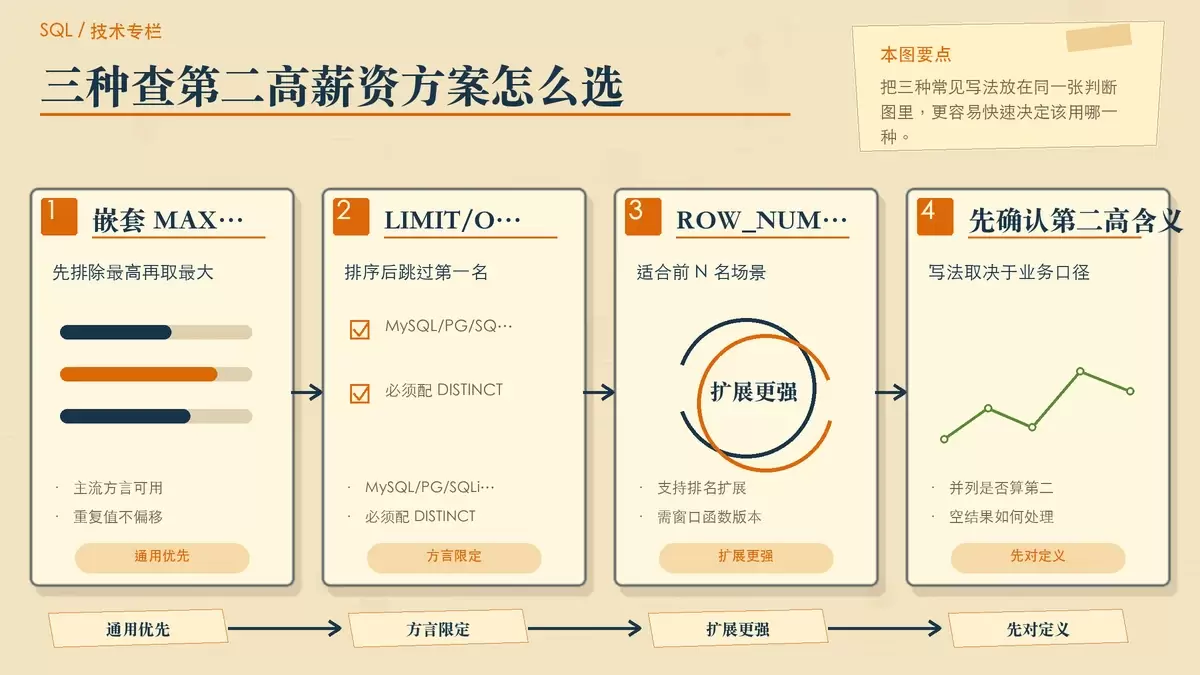
查询“第二高薪资”看起来像一道基础 SQL 题,真正容易出错的却是并列值、空结果和方言兼容性。本文把常见写法放到同一张判断表里,说明各自适用场景、限制和为什么多数情况下应优先用嵌套 `MAX()` 子查询。
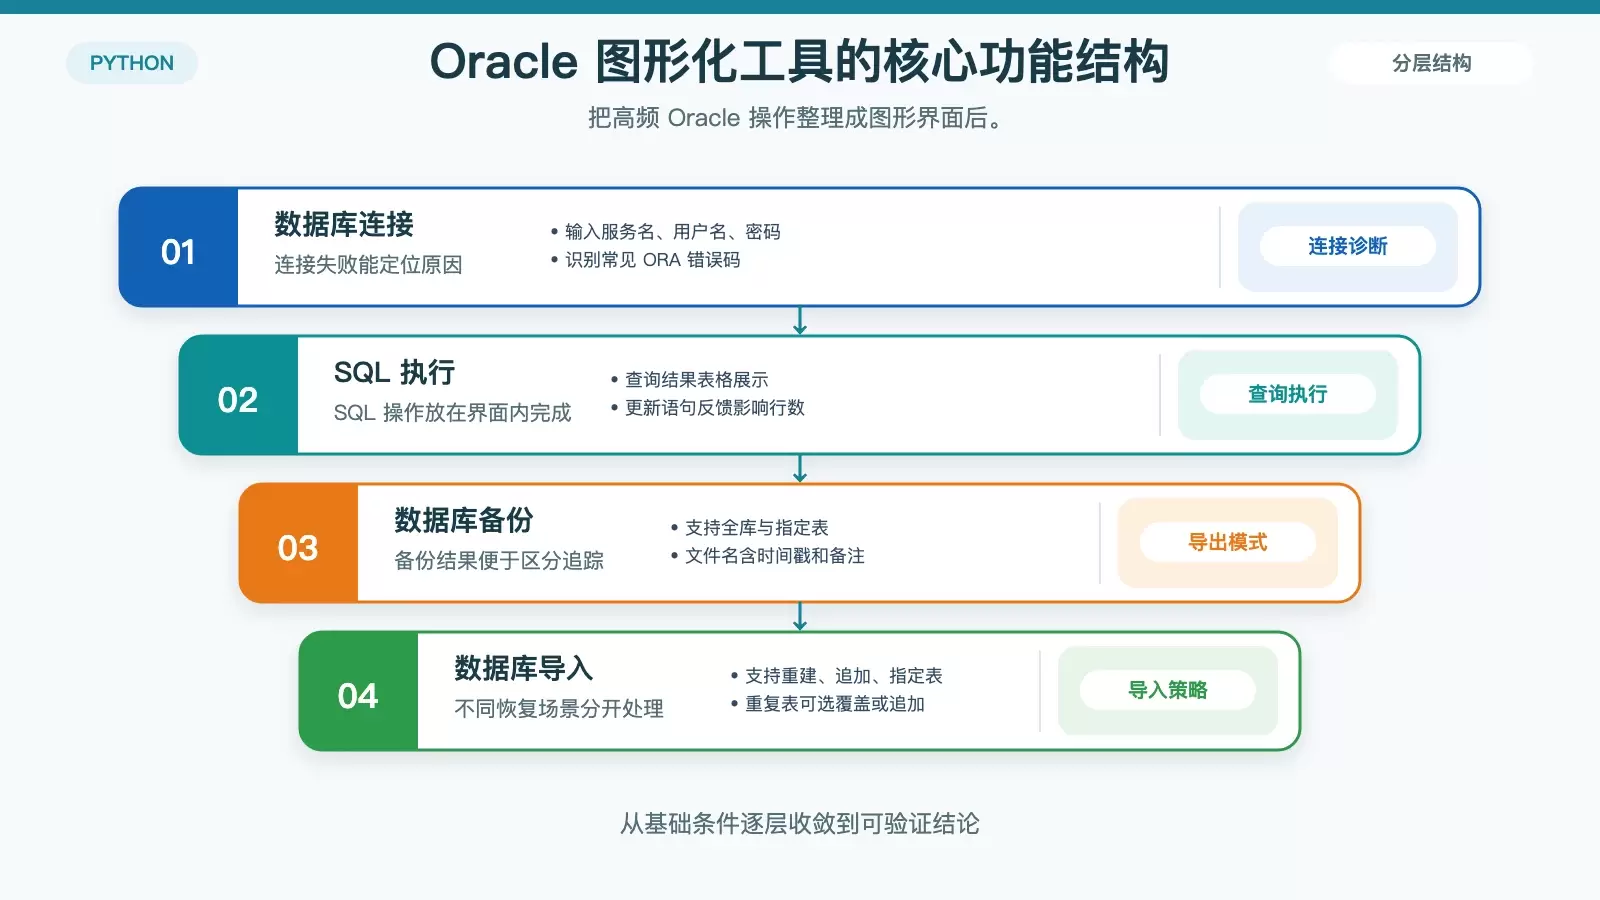
这款用 Python + Tkinter 编写的 Oracle 图形化工具,核心目标是把常见的备份、导入、SQL 执行和用户管理操作,从难记的命令行改成可视化流程。文章按实际使用场景梳理实现思路、关键代码和部署方式,便于判断它是否适合团队日常运维。