


Laravel 里批量插入很常见,但一旦遇到“多条记录、按不同条件更新不同值”的场景,开发者往往只能循环 `save()` 或手写 SQL,代码和性能都不够理想。下面这篇内容把一个可直接落到 Eloquent 模型中的批量更新方法重新整理出来,同时拆开说明它的 SQL 结构、参数绑定方式,以及实际调用时该关注哪些边界。
为什么 Laravel 里批量更新不顺手
熟悉 Laravel 的人通常都知道,框架对批量插入支持得比较直接,但对“多条记录一次性更新为不同内容”并没有提供同样现成的方法。
这也是很多人会拿它和其他框架做比较的原因:比如 ThinkPHP 有类似 `saveAll` 的思路,CodeIgniter 里也有 `update_batch`。而在 Laravel 里,如果直接按常规写法处理,最容易出现两种情况:
- 循环执行多次 `update` 或 `save`,数据库往返次数多;
- 自己拼接原生 SQL,但如果处理不好参数,容易留下 SQL 注入风险。
这类需求本质上不是“批量设置同一个值”,而是“同一批记录根据各自主键,更新成各自不同的字段值”。要解决它,比较常见的做法就是借助 SQL 的 CASE WHEN 结构,把多条更新合并成一条语句。
基于 Eloquent 封装一个 `updateBatch` 方法
下面这段代码可以直接放进模型中使用。它的核心点不是单纯拼出 SQL,而是把值放进绑定参数里,通过 DB::update($sql, $bindings) 执行,避免把动态数据直接拼到语句中。
<?php
namespace AppModels;

use DB;
use IlluminateDatabaseEloquentModel;

/**
 * 学生表模型
 */
class Students extends Model
{
    protected $table = 'students';

    //批量更新
    public function updateBatch($multipleData = [])
    {
        try {
            if (empty($multipleData)) {
                throw new Exception("数据不能为空");
            }
            $tableName = DB::getTablePrefix() . $this->getTable(); // 表名
            $firstRow  = current($multipleData);

            $updateColumn = array_keys($firstRow);
            // 默认以id为条件更新,如果没有ID则以第一个字段为条件
            $referenceColumn = isset($firstRow['id']) ? 'id' : current($updateColumn);
            unset($updateColumn[0]);
            // 拼接sql语句
            $updateSql = "UPDATE " . $tableName . " SET ";
            $sets      = [];
            $bindings  = [];
            foreach ($updateColumn as $uColumn) {
                $setSql = "`" . $uColumn . "` = CASE ";
                foreach ($multipleData as $data) {
                    $setSql .= "WHEN `" . $referenceColumn . "` = ? THEN ? ";
                    $bindings[] = $data[$referenceColumn];
                    $bindings[] = $data[$uColumn];
                }
                $setSql .= "ELSE `" . $uColumn . "` END ";
                $sets[] = $setSql;
            }
            $updateSql .= implode(', ', $sets);
            $whereIn   = collect($multipleData)->pluck($referenceColumn)->values()->all();
            $bindings  = array_merge($bindings, $whereIn);
            $whereIn   = rtrim(str_repeat('?,', count($whereIn)), ',');
            $updateSql = rtrim($updateSql, ", ") . " WHERE `" . $referenceColumn . "` IN (" . $whereIn . ")";
            // 传入预处理sql语句和对应绑定数据
            return DB::update($updateSql, $bindings);
        } catch (Exception $e) {
            return false;
        }
    }
}
这段方法到底做了什么
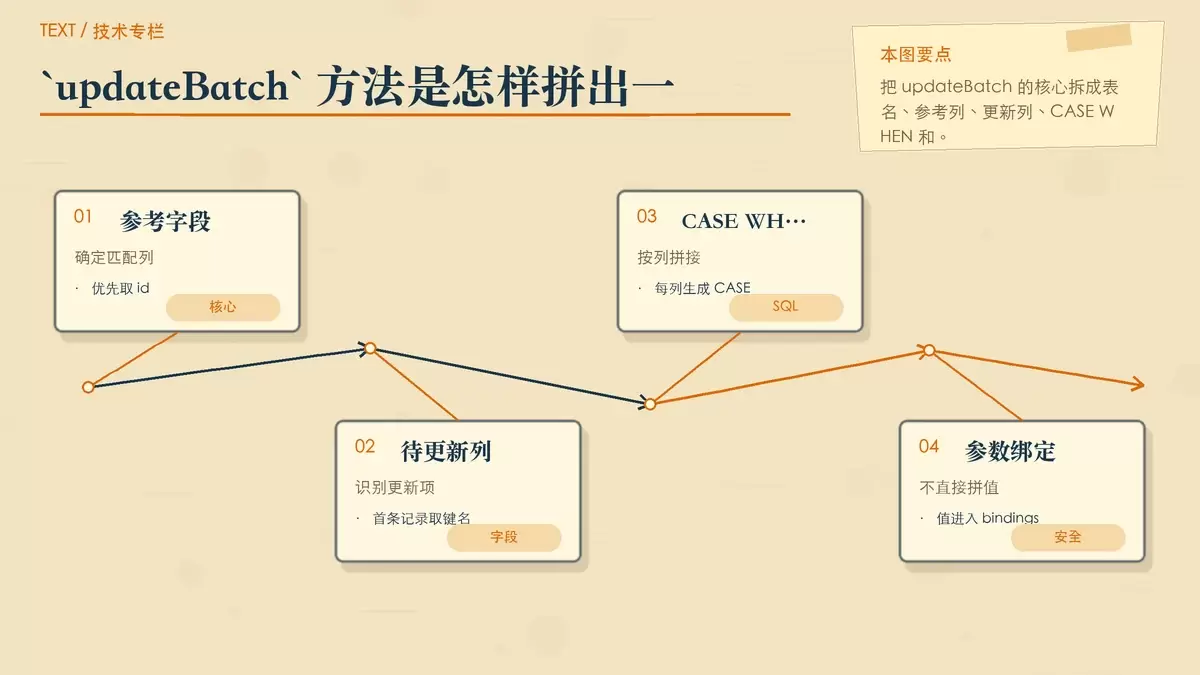
如果把逻辑拆开看,这个方法主要完成了几件事:
- 先检查传入的
$multipleData是否为空,空数据直接返回失败; - 通过
DB::getTablePrefix() . $this->getTable()取得实际表名; - 读取第一条数据的字段列表,推断哪些字段需要更新;
- 优先使用
id作为匹配条件,如果没有id,就退回到第一个字段; - 为每个待更新字段生成一个
CASE WHEN片段; - 把所有动态值写入
$bindings,最后统一交给数据库驱动做预处理。
也就是说,它不是生成多条 UPDATE,而是生成一条大的 UPDATE ... SET field = CASE WHEN ... END 语句,让数据库一次完成整批记录修改。
为什么参数绑定更关键
很多网上流传的版本,思路本身没问题,但会把更新值直接拼进 SQL 字符串里。这样虽然能跑通,但只要输入数据里混入特殊内容,风险就会立刻出现。
这里的处理方式是:
WHEN `字段` = ? THEN ?使用占位符;- 每次循环把匹配值和更新值依次压入
$bindings; - 最后
WHERE IN里的条件值也继续使用占位符拼接。
这样生成的是预处理 SQL,真正的值不会直接混入语句文本中。对于需要保留 Eloquent 模型结构、又必须执行批量更新的项目来说,这种写法比纯字符串拼接更稳妥。
实际调用方式与输入格式
这个方法的调用方式比较直接,重点是传入数组结构要统一,每一项都需要包含同样的字段,尤其是作为匹配条件的字段。
// 要批量更新的数组
$students = [
    ['id' => 1, 'name' => '张三', 'email' => 'zhansan@qq.com'],
    ['id' => 2, 'name' => '李四', 'email' => 'lisi@qq.com'],
];

// 批量更新
app(Students::class)->updateBatch($students);
从这个示例可以看出,数组里的每个元素代表一条待更新记录:
id用作定位条件;name和email是要更新的字段;- 所有数据会在一次数据库操作中完成更新。
如果你的业务里不一定使用 id 作为主条件,这个方法也给了后备策略:当首条数据里没有 id 时,会默认取第一个字段作为参考列。不过从可维护性来看,明确使用主键或唯一键仍然更合适,避免误更新。
最终生成的 SQL 长什么样
以上示例最终会拼出一条类似下面的 SQL:
UPDATE pre_students
SET NAME = CASE
WHEN id = 1 THEN
    '张三'
WHEN id = 2 THEN
    '李四'
ELSE
    NAME
END,
 email = CASE
WHEN id = 1 THEN
    'zhansan@qq.com'
WHEN id = 2 THEN
    'lisi@qq.com'
ELSE
    email
END
WHERE
    id IN (1, 2)
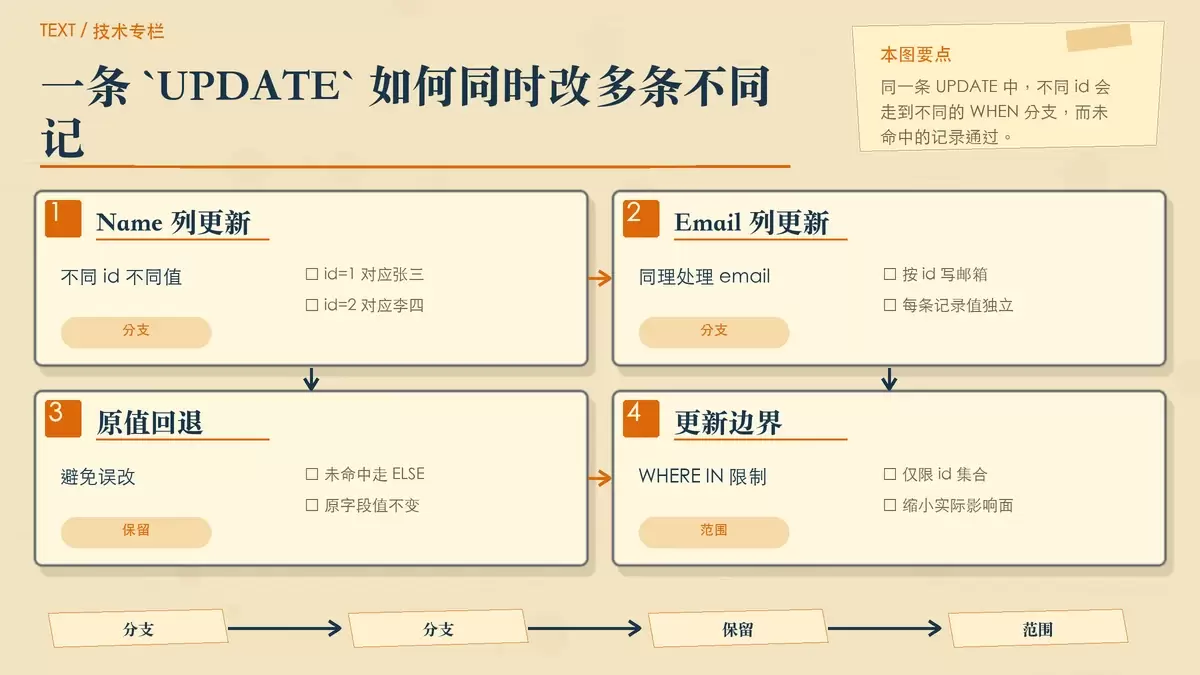
这条语句可以直接看出 CASE WHEN 的工作方式:
- 同一个字段只更新一次,但会按不同
id分配不同值; ELSE 字段本身的作用是,没命中的记录保持原值不变;WHERE id IN (...)把更新范围限制在这批数据内,避免整表扫描式误伤。
因此,这种批量更新方式的优势并不只是“少写几行代码”,而是把多次往返数据库的操作收束为一次执行。在记录量适中、字段结构统一的场景下,通常会比循环更新更有效率。
落地时需要注意的几个问题
这套方法已经能解决多数批量更新需求,但在正式项目里,仍然有几个地方值得额外留意。
1. 传入数组字段必须尽量一致
代码是通过第一条记录的键名来推断更新字段的。如果后面的记录缺少某个字段,执行到 $data[$uColumn] 时就可能出现未定义索引,或者把本不该为空的值写成异常结果。
更稳妥的做法是:在调用前先整理好数据结构,确保每条记录的字段集合一致。
2. 参考列最好是主键或唯一键
虽然方法支持“没有 id 时使用第一个字段”这种回退逻辑,但如果第一个字段不是唯一值,更新结果就可能不可控。批量更新本质上依赖“一个条件精确命中一条记录”,所以实际使用时最好明确传入主键、业务唯一键或联合唯一条件对应的字段。
3. 异常处理要结合项目代码再补齐
原方法里使用了 try ... catch (Exception $e),但示例代码没有展开异常类的完整引入。在真实项目中,你需要确认异常命名空间是否正确,以及返回 false 是否符合当前服务层的错误处理约定。
4. 它适合批量更新,但不等于无限放大
把很多记录、很多字段一次塞进同一条 SQL,确实能减少请求次数,但 SQL 文本也会同步变长,绑定参数数量也会增加。对于超大批次数据,依然需要按业务规模分批提交,而不是把所有记录一次性压进一条语句里。
如果你的目标是替代循环逐条更新,这个方案已经足够实用;如果你的目标是处理极大规模数据,则还要结合批次拆分、事务策略以及数据库本身的承载能力继续优化。
适合什么场景使用
总结下来,这个 updateBatch 方法适合的场景很明确:你需要在 Laravel 中一次更新多条记录,而且每条记录更新后的值都不同;同时你又希望保留模型层组织方式,而不是完全脱离框架去写裸 SQL。
它的关键价值有两个:
- 通过
CASE WHEN合并多条更新,减少数据库交互次数; - 通过参数绑定保留安全性,避免简单拼接 SQL 带来的注入问题。
如果项目里经常出现后台批量改资料、批量同步状态、批量修正字段值这类需求,这种封装方式基本值得保留成一个通用工具方法,再按你自己的模型规范和字段规则继续细化。









