


很多人在写 SQL Server 存储过程时,都会想把多个统计值“塞进一个 OUTPUT 参数”一起返回,比如订单总数、总收入、平均客单价一次带回。问题在于,OUTPUT 本质上是按引用回写单个标量值的机制,不适合承载多字段、多行、动态结构的数据。
这篇文章把判断规则拆开说明:什么场景该用多个 OUTPUT 参数,什么场景该直接返回结果集,以及定义、调用、读取三个环节里最常见的漏写点。看完之后,你可以更快判断该选哪种返回方式,也能避开 NULL、旧值和 ORM 无法映射这类隐蔽问题。
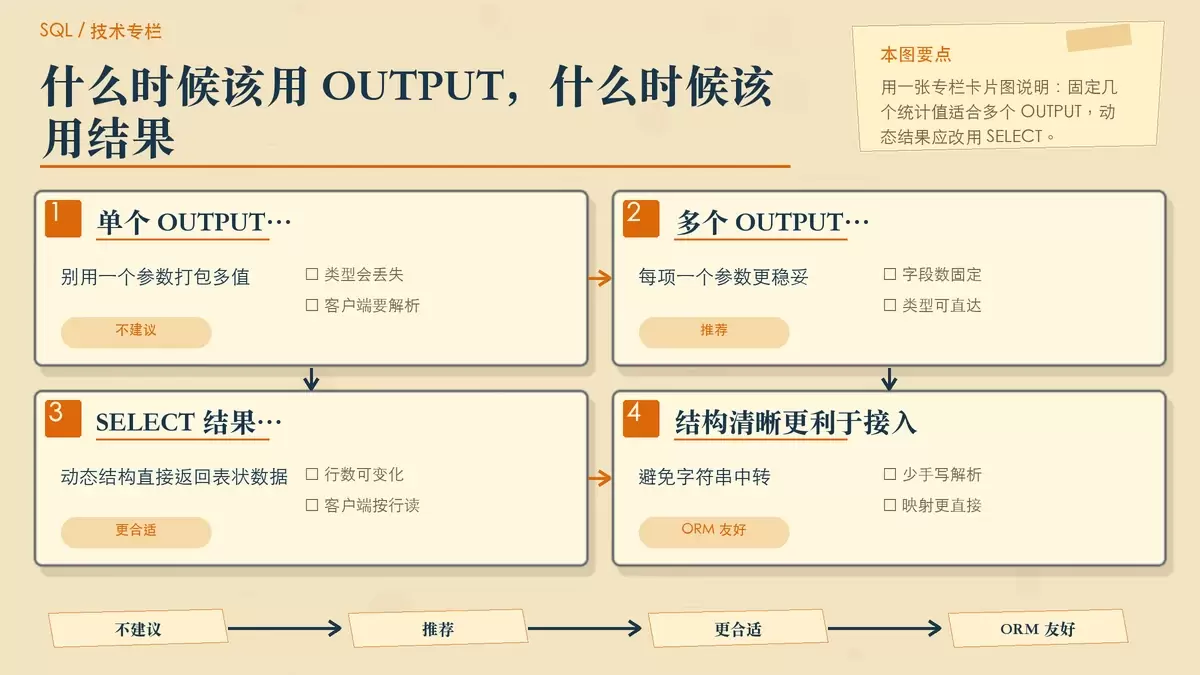
OUTPUT 参数只能回写单个标量值
SQL Server 存储过程不能用单个 OUTPUT 参数返回多个统计值。像 @total_count、@avg_amount、@max_date 这类结果,必须分别定义为独立参数,例如 INT OUTPUT、DECIMAL(18,2) OUTPUT、DATETIME OUTPUT。
如果试图用一个 @result NVARCHAR(MAX) OUTPUT 去拼 JSON 或逗号分隔字符串,虽然表面上“能传回去”,但会马上带来几个问题:
- 原本明确的数值、日期类型被压成字符串,类型信息丢失。
- 客户端还要额外拆分和转换,解析逻辑变重,出错概率更高。
- 像 Entity Framework 这类 ORM 很难直接按字段映射,通常只能手写解析。
因此,OUTPUT 适合固定数量、固定类型的回写值,不适合“打包返回”。只要你返回的是多个独立统计项,就应该按项拆成多个 OUTPUT 参数。
这类写法最常见的三个错误
- 定义参数时漏写
OUTPUT:参数会变成普通输入参数,调用端拿不到回写结果。 - 执行
EXEC时漏写OUTPUT:例如写成@a = @x,而不是@a = @x OUTPUT,变量会保持原值或仍为NULL。 - 调用前没有先
DECLARE变量:会直接报错Must declare the scalar variable。
多个 OUTPUT 参数怎么定义和调用
多 OUTPUT 参数要想稳定工作,关键不在“能不能写”,而在定义、赋值、调用三段是否完全对齐。下面这个订单统计示例就是一个标准写法:
CREATE PROCEDURE dbo.CalculateOrderStats
@start_date DATE,
@end_date DATE,
@total_orders INT OUTPUT,
@total_revenue DECIMAL(18,2) OUTPUT,
@avg_order_size DECIMAL(18,2) OUTPUT
AS
BEGIN
SELECT
@total_orders = COUNT(*),
@total_revenue = ISNULL(SUM(amount), 0),
@avg_order_size = ISNULL(AVG(CAST(order_items AS FLOAT)), 0)
FROM orders
WHERE order_date BETWEEN @start_date AND @end_date;
END
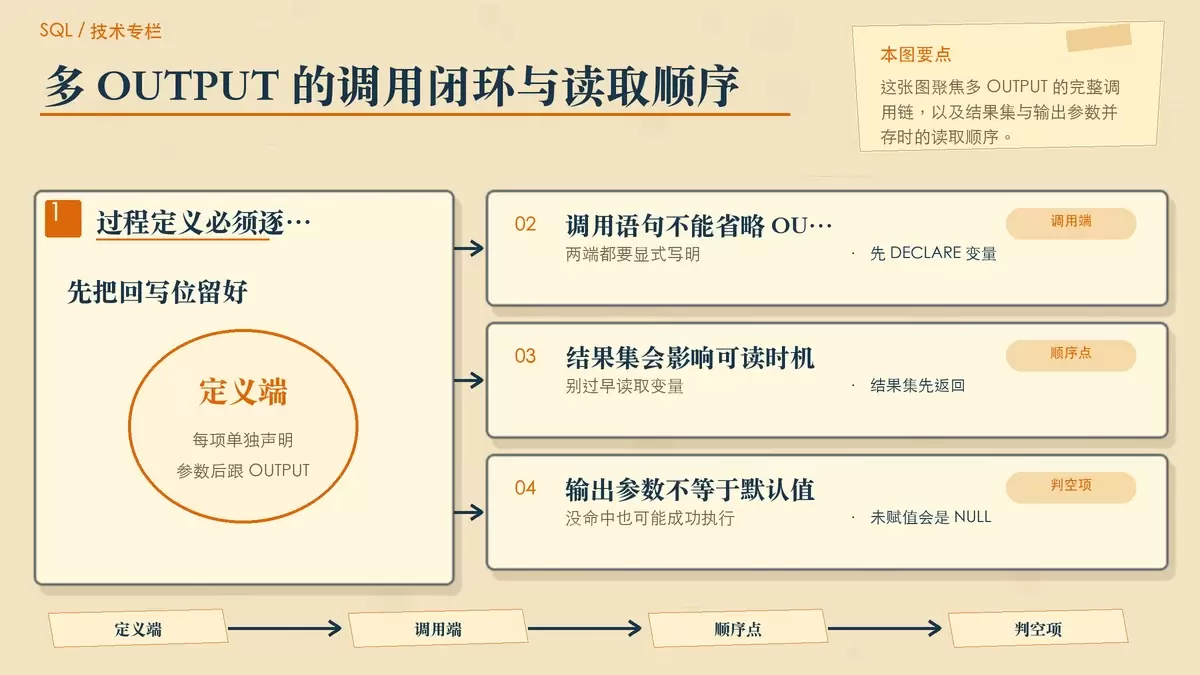
调用时也要一一对应,不能省略任何一步:
- 先声明接收变量:
DECLARE @a INT, @b DECIMAL(18,2), @c DECIMAL(18,2) - 再执行存储过程:
EXEC CalculateOrderStats '2024-01-01', '2024-12-31', @a OUTPUT, @b OUTPUT, @c OUTPUT - 最后再读取变量值,确认每个参数都已被成功回写
这套方式特别适合固定结构的汇总结果,例如报表页顶部的几个关键指标、一次查询返回的几个总计字段,或者需要同时带回数值与日期边界的场景。
为什么说调用链必须“显式闭环”
因为 OUTPUT 参数不是自动推断的。你在存储过程定义里写了 OUTPUT,只代表该参数允许回写;调用端如果没有明确声明变量并在 EXEC 时标注 OUTPUT,SQL Server 不会替你补全。
实际排查问题时,可以按这个顺序检查:
- 存储过程参数定义中是否为每个需要回写的值都写了
OUTPUT - 过程体里是否真的给这些参数赋过值
- 调用端变量类型是否匹配
EXEC语句中是否逐个追加了OUTPUT
只要这条链路中断一处,结果通常就是调用成功但变量没值,排查起来比语法报错更麻烦。
结果数量不固定时,直接用 SELECT 结果集
如果你返回的是动态列、动态行,或者统计项数量并不固定,就不应该硬套 OUTPUT 参数。一个典型例子是按月份聚合销售额:查询 3 个月和查询 12 个月,返回的数据行数显然不同,这种结构根本不适合预先声明固定数量的 OUTPUT 参数。
有些人会退而求其次,把结果拼成类似 'Jan:1200;Feb:1500' 的字符串再通过一个 OUTPUT 带回。但这样做的问题非常直接:
- 客户端必须自己拆分文本,再逐项转换类型,逻辑复杂且脆弱。
- 数字先变成字符串,后续如果还要计算,就得反复
CAST。 - ORM 无法自然映射,像 EF Core 的
FromSqlRaw也很难直接接住这种结果。
更合理的方式,是让存储过程直接输出结果集,例如:
SELECT month_name, sales_amount
这样客户端按行读取即可,结构清晰,也更符合数据库处理多行数据的天然方式。
怎么判断该选 OUTPUT 还是 SELECT
可以用一个简单标准来判断:
- 如果返回值数量固定、字段类型固定,而且就是几个标量统计值,用多个 OUTPUT 参数。
- 如果返回的是一组记录、动态月份、动态维度,或者未来可能扩展字段,用
SELECT结果集。
换句话说,OUTPUT 更像“回写几个确定的结果”,而结果集才适合“返回一批数据”。两者职责不同,别混用成字符串中转站。
同时存在结果集和 OUTPUT 时要注意什么
一个存储过程里,SELECT 结果集和多个 OUTPUT 参数可以同时存在,但程序端读取顺序不能想当然。很多问题不是 SQL 写错了,而是客户端还没把结果集消费完,就提前去读 OUTPUT 值。
需要记住的规则有三条:
- 结果集会先发送给客户端,OUTPUT 值要在所有结果集被读取或跳过后才能稳定取得。
- 在 SSMS 里看起来像是“马上就有值”,主要因为工具帮你自动遍历了结果集;应用程序里通常得自己处理。
- 如果使用 ADO.NET,并且过程中有额外
SELECT,就要反复调用reader.NextResult(),直到所有结果集都被消费完,再读取@a、@b这类输出变量。
JDBC 里也有类似限制。调用 SQL Server 存储过程时,应使用 SQLServerCallableStatement,先 registerOutParameter,再 execute,最后通过 getXXX 获取输出值,而不是简单拿 executeQuery 代替。
还有一个最容易被忽略的细节:未赋值就会返回 NULL
即使参数定义和调用方式都正确,如果存储过程内部没有给 OUTPUT 参数赋值,调用端拿到的仍然可能是 NULL。常见原因是 WHERE 条件没有匹配到记录,或者分支逻辑根本没走到赋值语句。
这意味着调用端不能默认它一定有结果,更不能把它当成“没查到时自动回传 0”。如果业务上要求稳定的默认值,就应该在存储过程里显式赋值,或者在应用层做好判空处理。
实战里的推荐做法
把规则压缩成一句话就是:SQL Server 存储过程想返回多个统计值时,不要用一个 OUTPUT 参数硬拼内容;固定几个值,就拆成多个独立 OUTPUT;结果数量不确定,就直接返回 SELECT 结果集。
这套做法的好处不只是语法正确,还包括类型清晰、客户端处理成本更低、ORM 更容易接入,后续维护时也更容易定位问题。尤其在报表统计、后台聚合、服务接口封装这些场景里,越早把 OUTPUT 和结果集的边界分清,后面越不容易埋坑。









