如何解决 SQL 日期边界导致的数据遗漏?
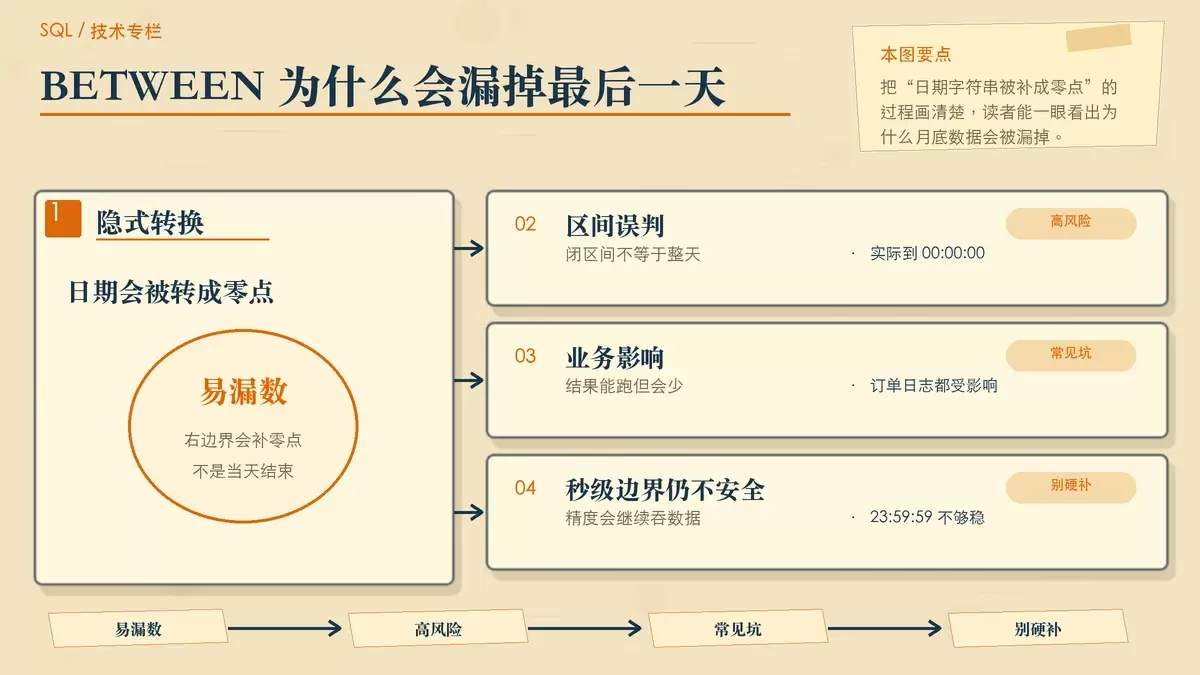
按日期筛选数据时,`BETWEEN` 常因隐式转换把右边界变成当天 `00:00:00`,导致最后一天的数据被漏掉。本文用订单、日志等常见场景说明问题根源,并给出更稳妥的左闭右开写法、动态边界生成方式,以及字符串日期字段的处理建议。
2026-08-25
153

按日期筛选数据时,`BETWEEN` 常因隐式转换把右边界变成当天 `00:00:00`,导致最后一天的数据被漏掉。本文用订单、日志等常见场景说明问题根源,并给出更稳妥的左闭右开写法、动态边界生成方式,以及字符串日期字段的处理建议。
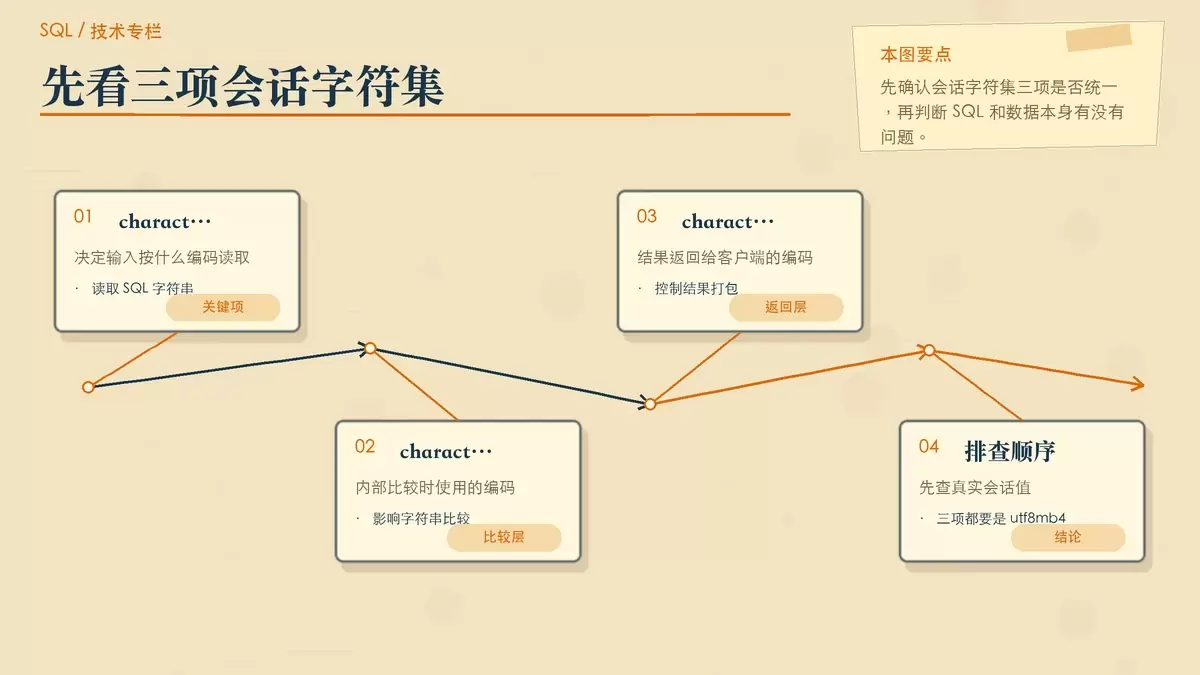
SQL JOIN 中文字段“看起来一样却匹配不上”,常见根因不在表结构,而在连接层字符集和校对规则不一致。本文按排查顺序梳理三项连接字符集、各语言连接写法、COLLATE 差异及错误修复方式,帮你快速判断问题到底出在连接、比较规则,还是存储层。
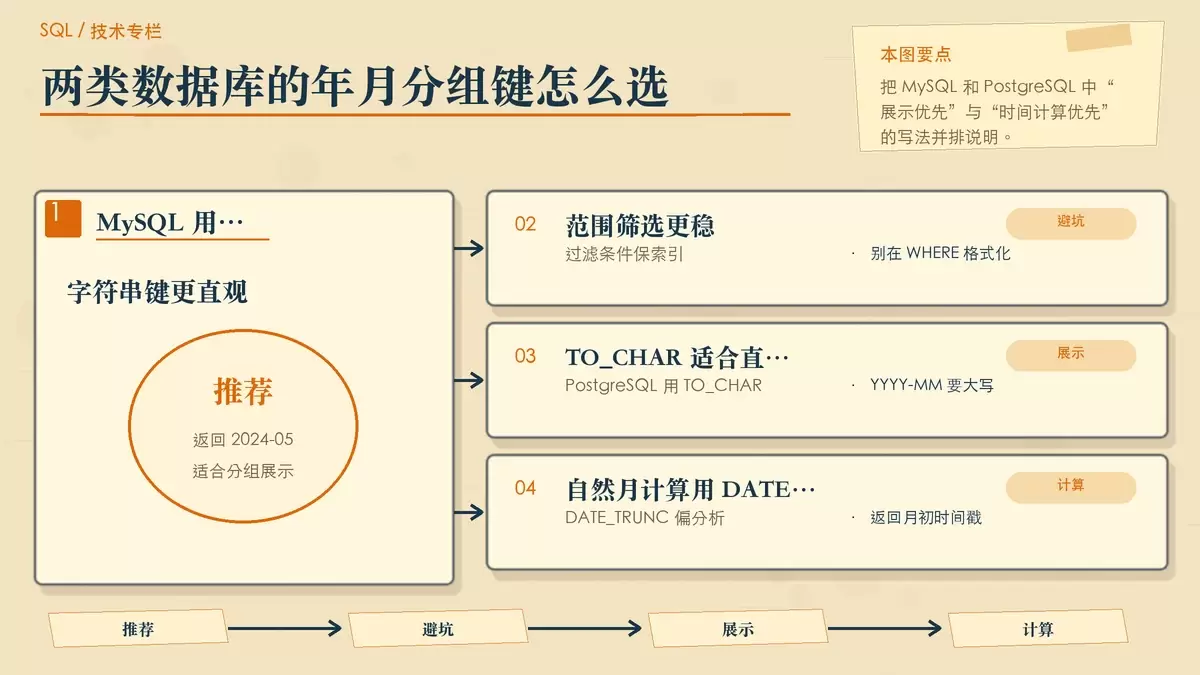
按年月统计订单并不难,难点在于分组键是否稳定、展示是否直观,以及查询能否继续走索引。本文按 MySQL、PostgreSQL、SQL Server 和跨库写法分别整理可直接落地的方案,同时指出常见误区与性能边界。
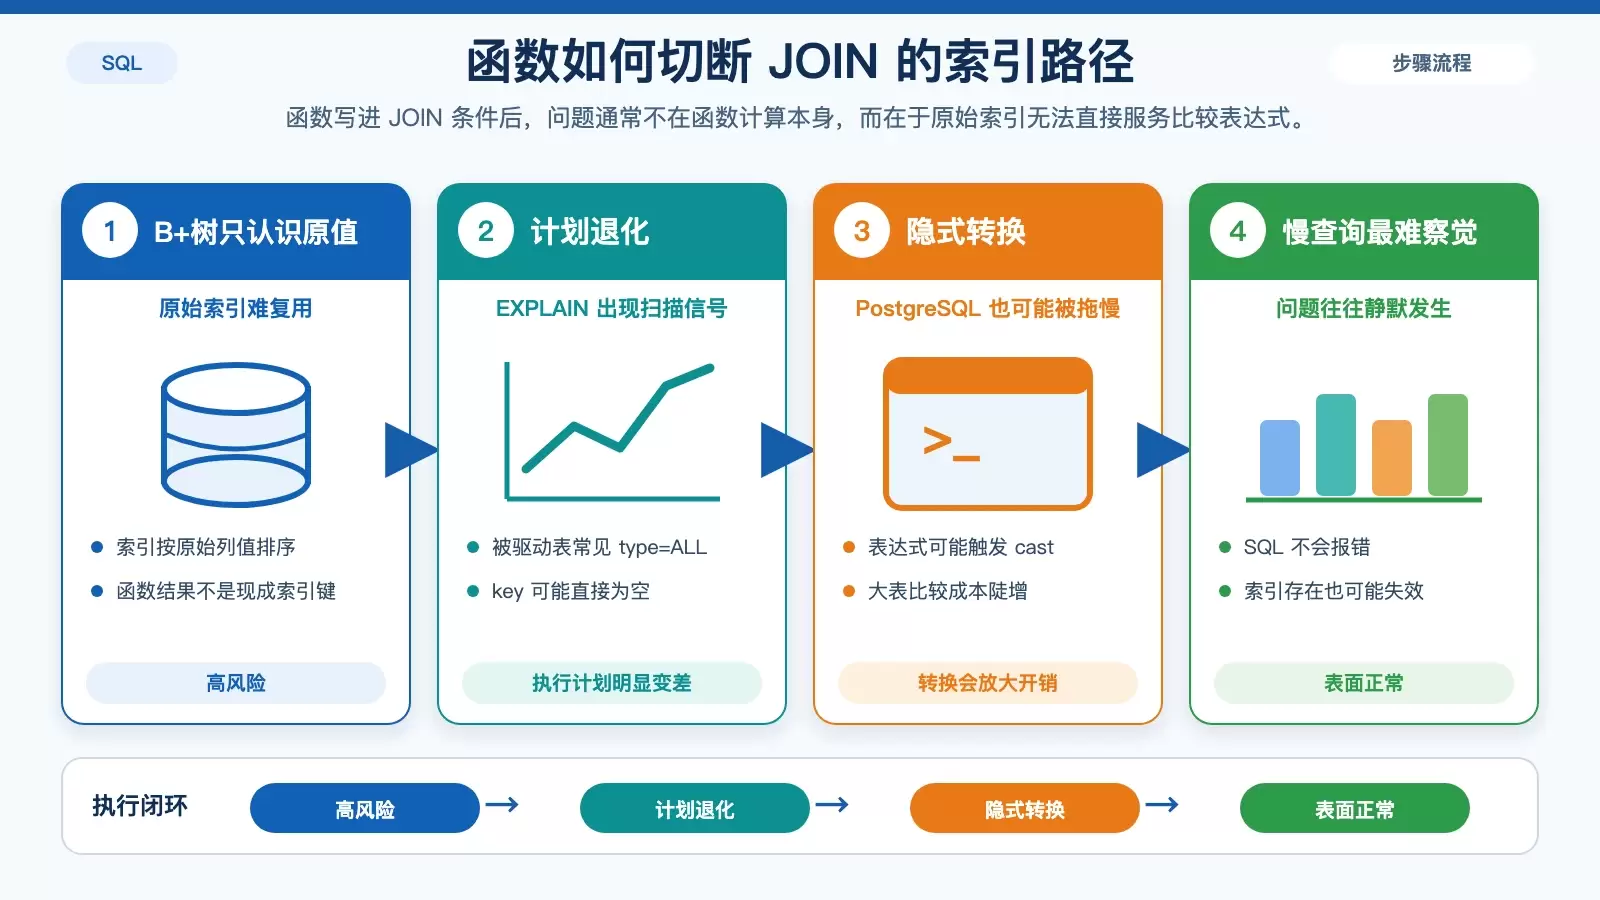
在 SQL 的 JOIN 条件里直接套 `UPPER()`、`DATE()` 这类函数,常见后果不是“多算几次”那么简单,而是优化器放弃索引、执行计划退化成扫描。本文从索引失效的原因、`COLLATE` 误区到两条可行优化路径,说明该怎么判断问题并改写 SQL。
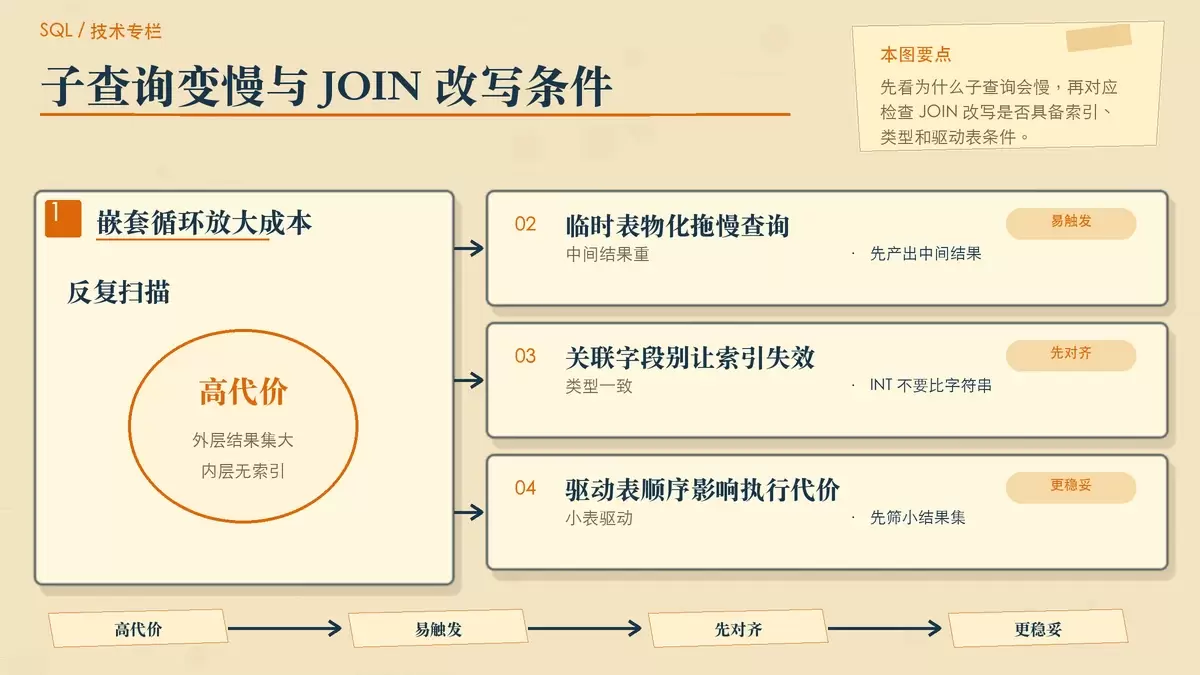
在亿级数据表上,子查询慢往往不是语法本身的问题,而是嵌套循环、临时表物化和索引缺失叠加造成的。本文围绕何时把 IN/EXISTS 改写为 JOIN、索引该补在哪些位置,以及深度分页场景该如何拆解,整理出一套更适合线上排查的判断方法。
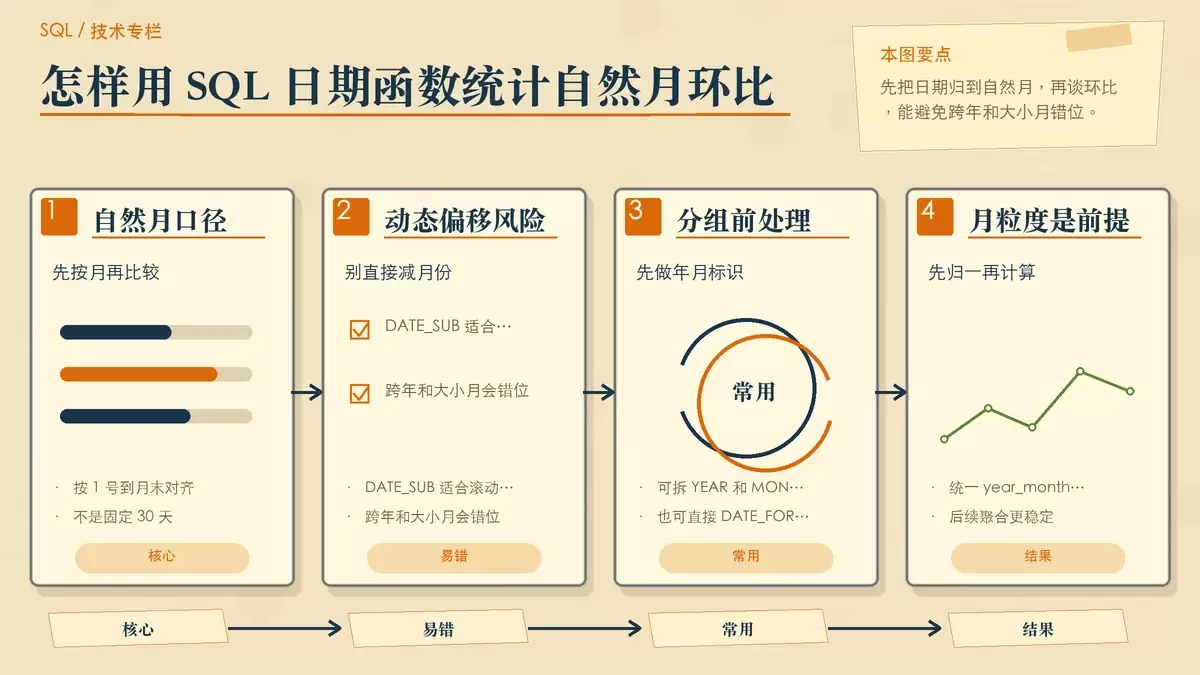
统计自然月环比,难点不在公式本身,而在“按日历月对齐”和“上月值如何准确关联”。本文按 MySQL 8.0+ 与 5.7 及以下两种场景,整理可直接套用的 SQL 写法,并补出时区、空值、除零和时间口径这些最容易让结果失真的细节。
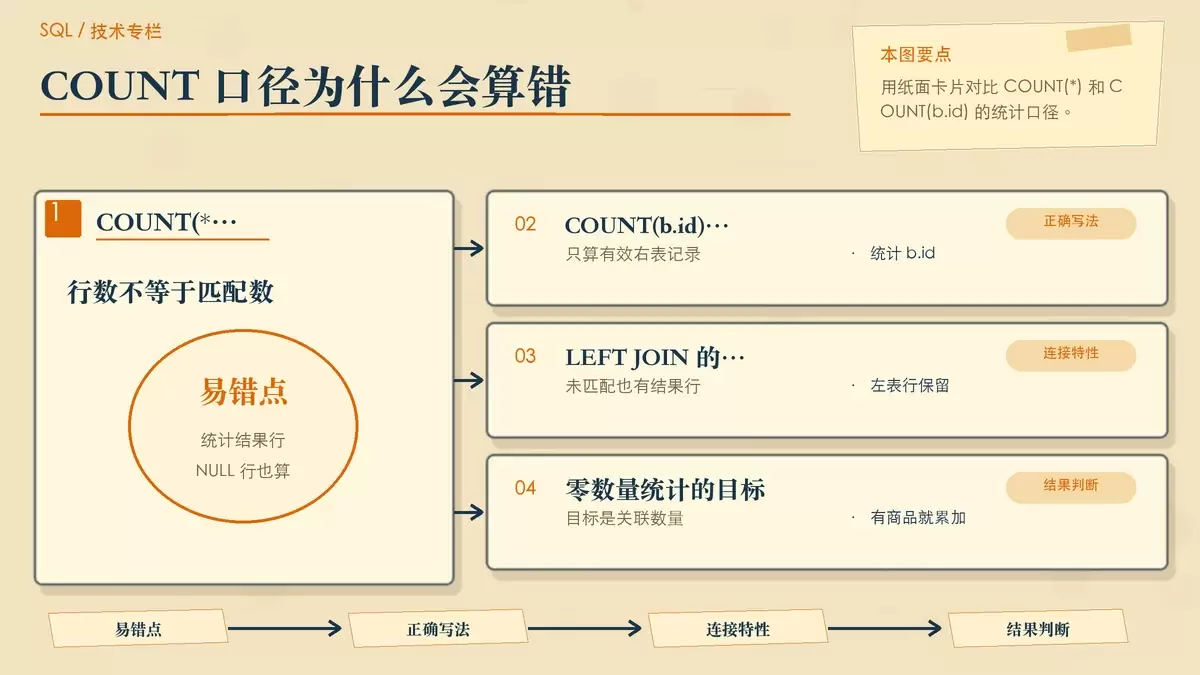
用 LEFT JOIN 做“零数量统计”时,最常见的坑有三个:把 COUNT(*) 当作关联记录数、GROUP BY 写错分组键、以及把左表过滤条件误塞进 ON 子句。本文用订单与商品示例拆开说明这些问题,并给出在 MySQL、PostgreSQL 等数据库里更稳妥的写法与性能判断依据。
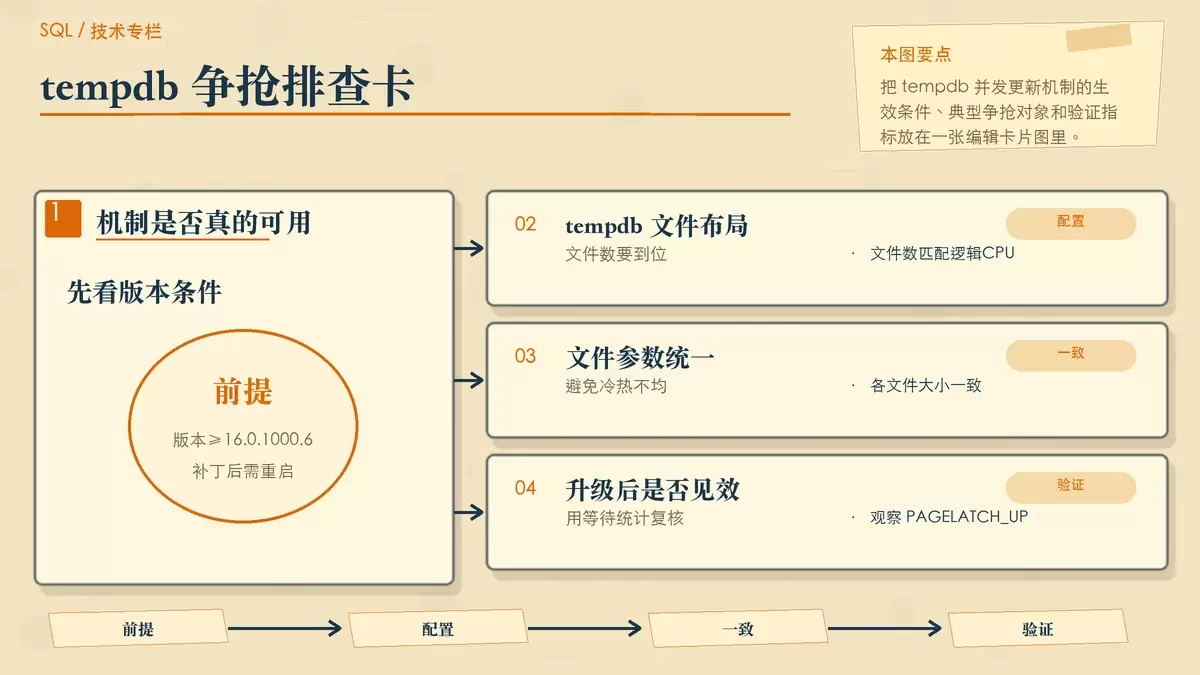
SQL Server 2022/2024 中,存储过程执行计划优化的重点不在改写语法,而在于让既有过程正确触发新机制。排查时应先看统计信息,再分别确认 tempdb 并发更新、参数敏感计划(PSP)、RECOMPILE 使用边界,以及查询存储中的优化重播是否真正带来编译收益。
GROUPING SETS 适合把多个彼此独立、又要同时出现在一张结果表里的聚合需求合并成一次查询。它的优势不是“更高级的汇总语法”,而是精确控制分组组合;但要注意 MySQL 8.4 及以下不支持,结果里的 NULL 也必须配合 GROUPING() 才能正确解释。
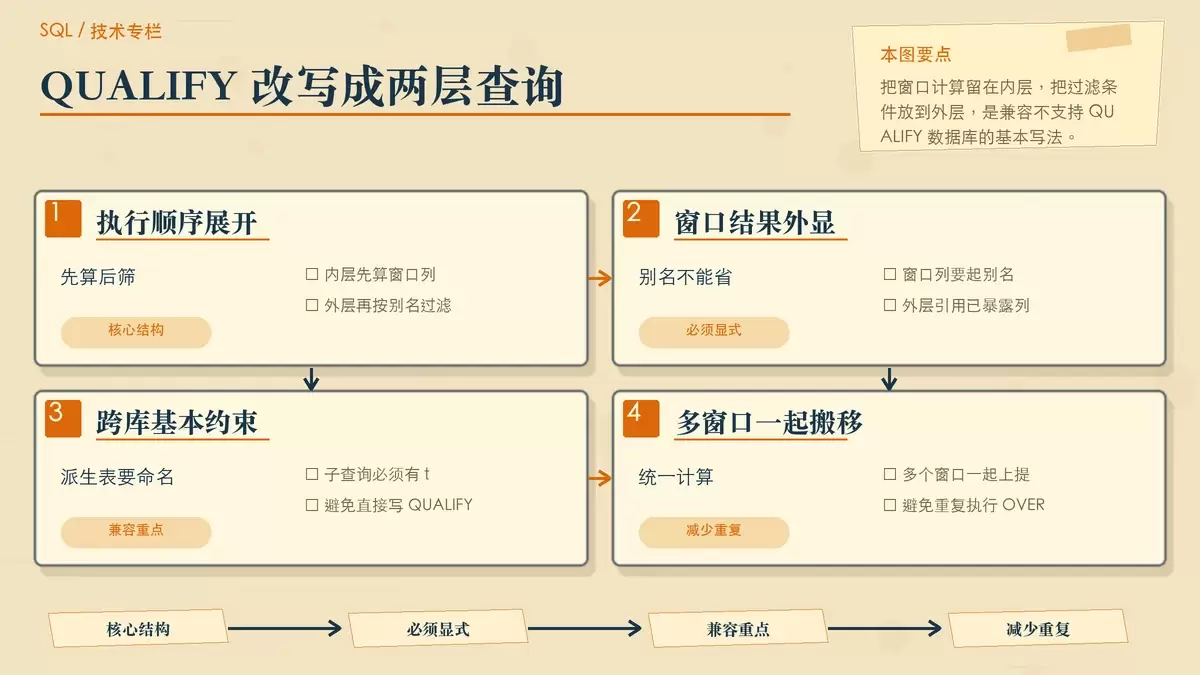
`QUALIFY` 适合在窗口函数计算后直接筛行,但它并不是 SQL 标准语法。遇到 PostgreSQL、SQL Server、以及不支持该关键字的 MySQL 版本时,最稳妥的办法是把查询改写成“内层算窗口、外层做过滤”的两层结构,同时检查排序、NULL 语义和执行计划。
按日期统计每日新增用户,常见误区不是 SQL 语法,而是统计口径和时间处理。关键点有三处:先把时间截断到“日”,再用每个用户的最早注册时间定义新增,最后把时间过滤放进子查询,同时排除 NULL 和异常时间值,结果才可靠。
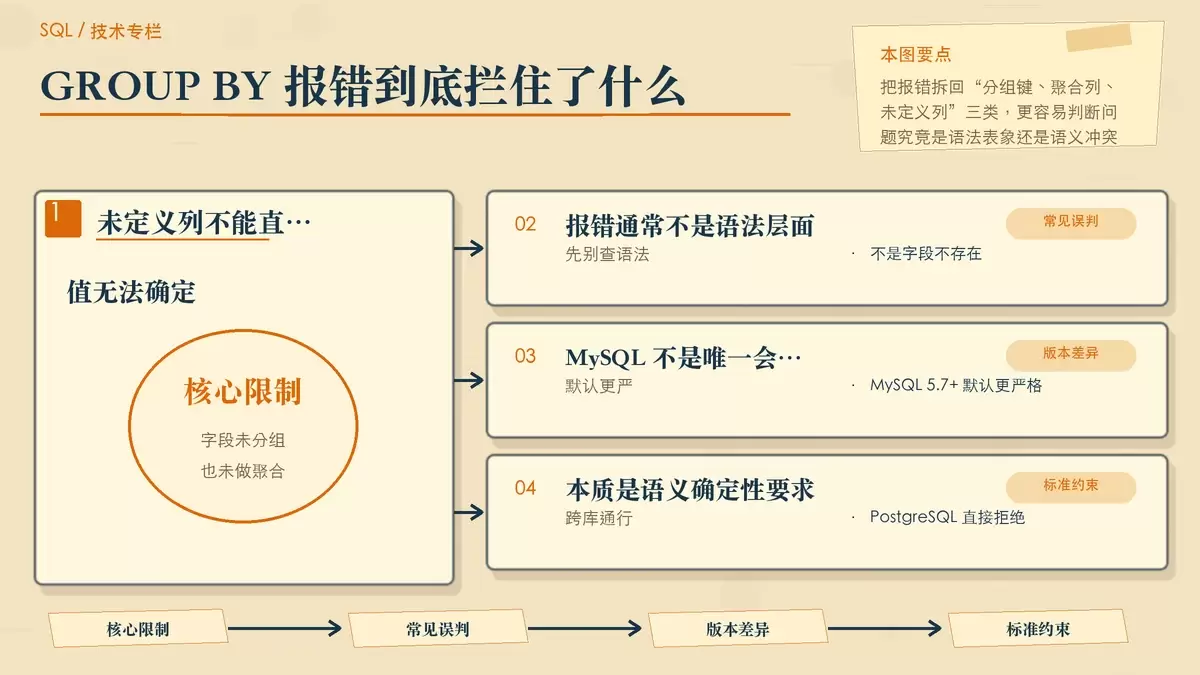
`GROUP BY` 语法看起来没问题却报错,通常不是拼写失误,而是数据库在拦截“结果不确定”的查询。本文从报错含义、常见误判、分组键设计、`ORDER BY` 别名可见性,到 `ANY_VALUE()` 的适用边界,梳理出更稳妥的排查与改写方式。