


在 SQL Server 调优里,很多人会把“指定 JOIN 算法”理解成在语句末尾补一个 OPTION 提示,但这往往不是你真正想要的效果。要想只约束某一对表的连接方式,必须写对联接提示的位置、适用范围和前提条件;否则轻则提示被忽略,重则直接报错或把整条查询拖慢。本文按实际排错顺序梳理:先说正确写法,再看常见误区,最后给出上线前必须核验的判断点。
强制指定某对表的 JOIN 算法,正确写法是什么
如果你的目标是让某两张表明确使用 LOOP JOIN,写法必须放在 JOIN 关键字附近,例如:
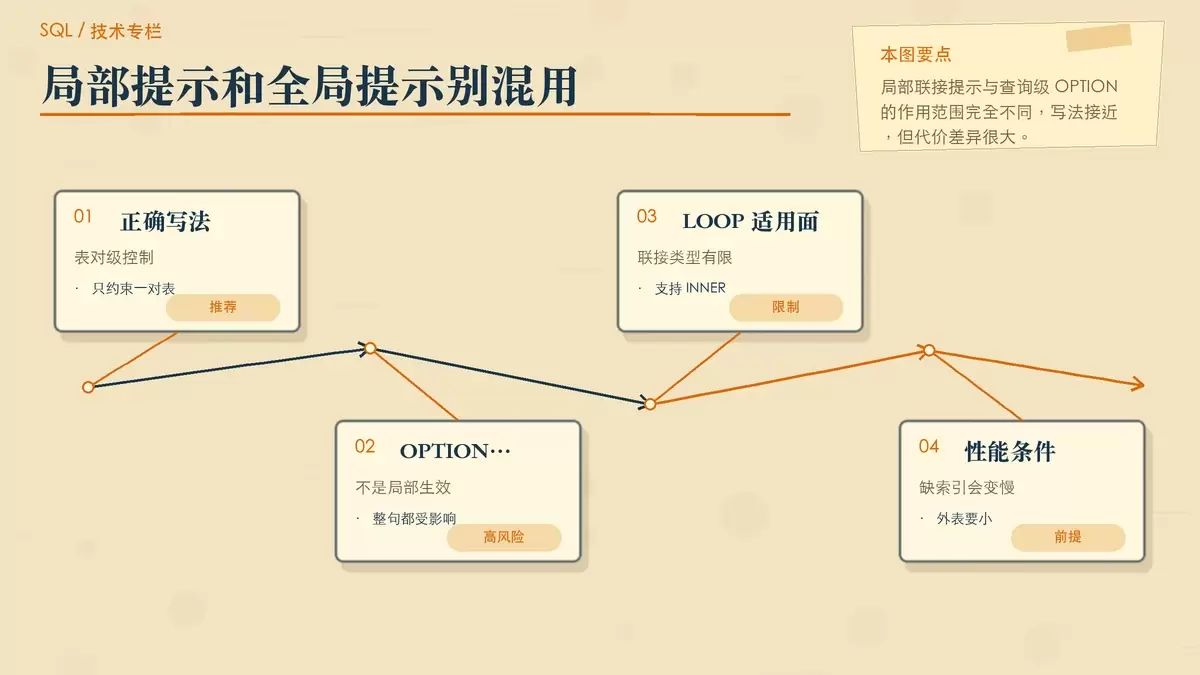
t1 INNER LOOP JOIN t2这一点很关键。很多人会把提示写成语句末尾的 OPTION (LOOP JOIN),但这并不是“只让这两个表走嵌套循环”,而是会把整条查询中的所有 JOIN 都往 LOOP 上推。对于多表查询,这种全局强制很容易带来两个问题:
- 触发错误
8622,也就是优化器无法生成可执行计划 - 把原本更适合
HASH的大表连接也硬改成嵌套循环,性能明显恶化
因此,想控制“某一对表”的算法,应该使用表级联接提示,而不是依赖查询级 OPTION。
这里还有几个高频误区需要一次说清:
LOOP只支持INNER JOIN、LEFT OUTER JOIN、RIGHT OUTER JOIN- 如果写成
FULL OUTER LOOP JOIN,会直接报错Msg 137 - 语法位置不能写错。正确是
t1 INNER LOOP JOIN t2,错误不是语义接近就能替代
另外,LOOP JOIN 能不能跑得快,前提通常是外表足够小,而内表连接列上有合适索引。否则每次匹配都要做额外查找,随机 I/O 会迅速升高,结果可能比 HASH JOIN 更差。
为什么 USE_NL 在 SQL Server 里没有效果
一些同时接触过 Oracle 和 SQL Server 的开发者,常会习惯性写出类似下面的提示:
/*+ USE_NL(t2) */但在 SQL Server 里,这种 Oracle 风格的注释提示根本不会生效。原因很直接:SQL Server 不识别 USE_NL 这一套语法,它只接受自己的联接提示形式,例如 LOOP、HASH、MERGE,并且要求写在 JOIN 关键字旁边。
所以即便你把 /*+ USE_NL(t2) */ 写进 SQL,SQL Server 也只会把它当普通注释跳过。最终执行计划里该出现 HASH JOIN 还是会出现 HASH JOIN,不会因为这条注释发生改变。
在 SQL Server 里,可替代的做法主要有两种:
- 直接改成
INNER LOOP JOIN这类明确写法,只约束目标表对 - 使用
OPTION (FORCE ORDER)配合索引和访问路径控制连接顺序
不过第二种方式要谨慎。FORCE ORDER 的代价,是关闭整条查询原本可用的 Join Reordering 优化能力。一旦数据分布、基数估算或输入规模发生变化,原来勉强可用的固定顺序可能迅速退化,出现明显的性能雪崩。
MERGE JOIN 报 unsorted inputs,问题通常出在哪
MERGE JOIN 最大的使用前提,是两侧输入在连接键上有序。这里最容易误解的点在于:有索引不等于输入有序,尤其不是“只要建了非聚集索引就一定能直接做 MERGE JOIN”。
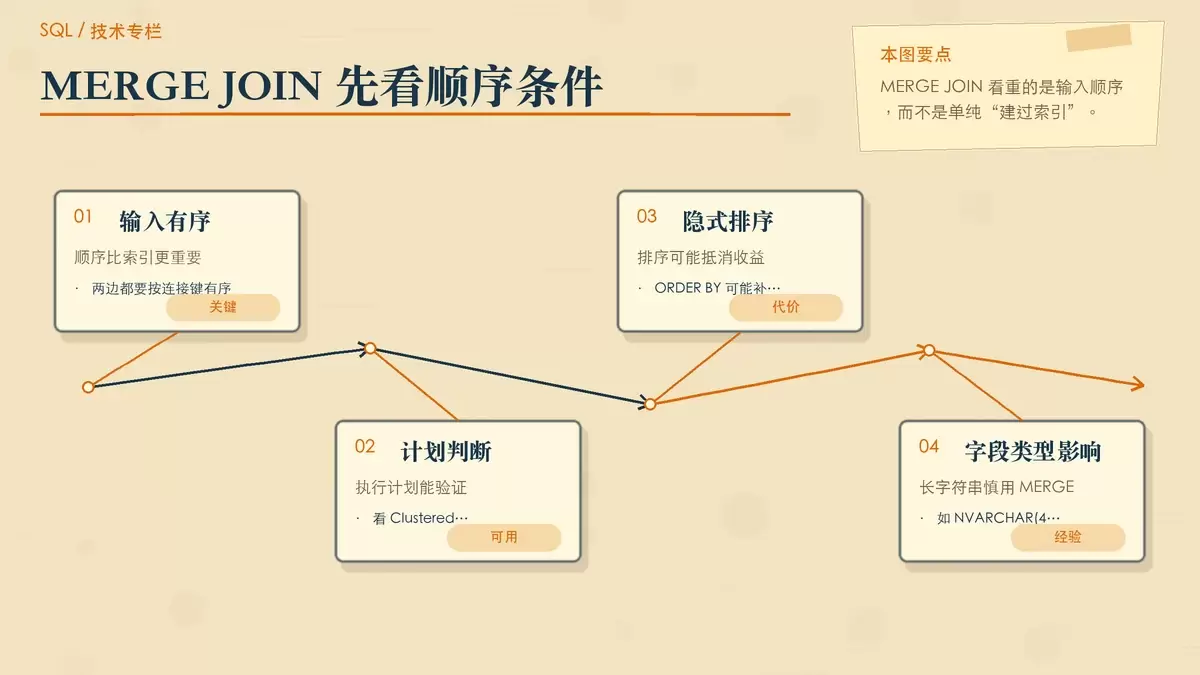
更准确地说,执行计划需要证明两边输入流已经按连接字段排序好。比如某些 Clustered Index Scan 可以天然满足顺序要求;有些 Index Seek 也可以,但前提通常是在计划属性中能看到有序输出,而不是仅仅“走了索引”这么简单。
排查时可以重点看这几项:
- 检查执行计划,确认连接字段对应的访问算子是不是
Clustered Index Scan,或是带有Ordered: true的Index Seek - 不要把
ORDER BY当成免费修复手段。它虽然可能补齐顺序条件,但通常会额外引入Sort,从而抵消MERGE JOIN的收益 - 连接列如果是长字符串,例如
NVARCHAR(400),很多场景下HASH反而更稳,因为MERGE对重复值更敏感,而HASH更偏向一次性哈希匹配
因此,看到 unsorted inputs 时,不要先急着补提示,先确认排序条件到底是天然满足、索引顺带满足,还是靠额外 Sort 硬做出来的。三种情况对应的成本完全不同。
加 JOIN 提示前,至少验证这三件事
即便你已经把语法写对了,也不能默认提示一定按预期生效。SQL Server 是否真正采用了你指定的算法,最终还是要看它能否生成合法计划,以及执行计划里是否真的出现对应算子。
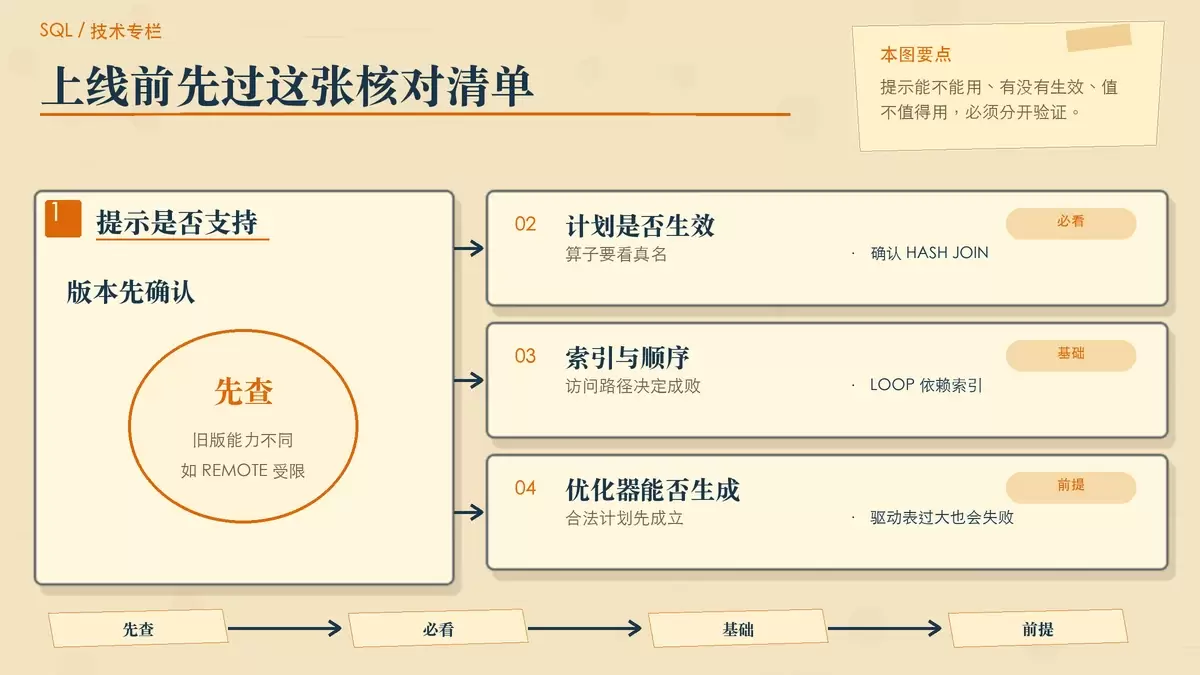
上线前至少核验下面三件事:
- 先看当前 SQL Server 版本是否支持相关提示。某些提示在旧版本里本来就不可用,例如旧版不支持
REMOTE - 再看执行计划输出里是否真实出现
HASH JOIN、NESTED LOOPS或MERGE JOIN,不要把Hash Cond、Join Filter之类的字样误判成联接算法已生效 - 最后检查连接字段上的索引和访问路径。没索引的
LOOP可能比HASH更慢;没有合适顺序输入的MERGE,往往会先触发隐式Sort
还有一个很常被忽视的前提:提示只有在优化器能生成合法执行计划时才有意义。如果驱动表过大、内存不足,或者统计信息已经过期,SQL Server 可能直接拒绝这条计划,而不是“勉强按提示执行”。这类情况下,先处理数据分布、索引和统计信息,再谈强制指定 JOIN 算法,通常更实际。
实操中的判断原则
把 JOIN 算法提示当成“精确手术刀”,比把它当成“全局开关”更符合 SQL Server 的工作方式。要指定单个表对,就把提示写在联接处;要验证是否生效,就回到执行计划;要判断该不该强制,则先看数据规模、索引、顺序性和版本支持。
如果只是为了“让它别走 HASH”或“我想强行用 LOOP”,但没有验证驱动表大小、索引可用性和计划合法性,那么提示很可能只是把问题从“优化器选得不理想”变成“查询直接不可用”。真正稳妥的做法,是把提示当作最后一步微调,而不是首选修复手段。









