Python Selenium Headless Chrome 网页抓取实战指南
本文详细介绍如何在Python中利用Selenium配合Headless Chrome进行网页内容抓取。文章涵盖Chrome及Chrome Driver的安装配置,解决国内源安装问题,并提供完整的Python代码示例,包括无头模式启动、页面加载超时设置及元素提取方法,适用于Linux环境下的自动化数据采集场景。
2026-10-13
6

本文详细介绍如何在Python中利用Selenium配合Headless Chrome进行网页内容抓取。文章涵盖Chrome及Chrome Driver的安装配置,解决国内源安装问题,并提供完整的Python代码示例,包括无头模式启动、页面加载超时设置及元素提取方法,适用于Linux环境下的自动化数据采集场景。
本文介绍在Python2环境下,利用Selenium截取网页元素并结合PIL库进行图像处理的方案。通过提取验证码或特定图片区域,计算其与本地图库中图片的相似度,从而自动匹配最相似的图片。代码涵盖截图、裁剪、灰度处理及相似度算法实现,适用于自动化测试中的图形识别场景。
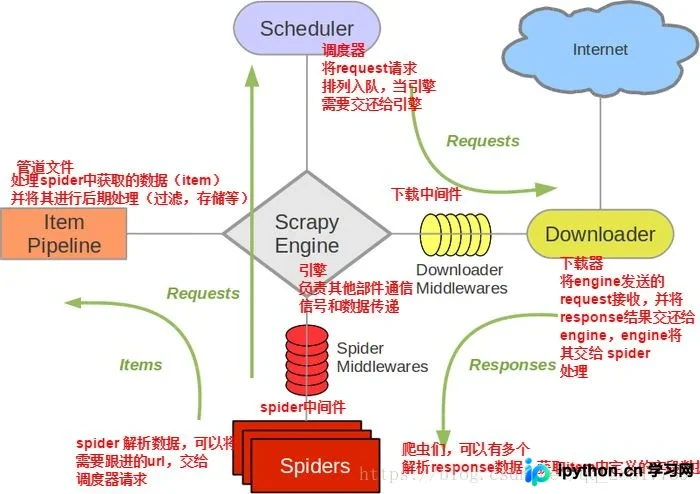
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的抓取难题。通过重写爬虫构造方法与关闭方法管理浏览器实例,并在下载中间件中拦截Response对象,利用Selenium渲染页面后篡改响应数据,从而在Spider中获取完整的动态内容。
本文深入解析Pyppeteer作为Selenium替代方案的用法。介绍其基于Python async机制的异步优势,详解launch方法的headless、args等关键参数配置,并通过实例演示如何自动处理Chromium依赖及结合pyquery解析JS渲染页面,实现高效网页数据抓取。
本文提供基于 Python Selenium 框架的淘宝自动抢购脚本示例。通过扫码登录实现自动化操作,支持精确至毫秒级的时间控制,可处理购物车结算及聚划算商品。该脚本仅作为学习自动化点击工具的示例,不涉及服务器端程序或收费软件,旨在帮助开发者理解 Selenium 在电商场景中的应用。
本文介绍使用 Python 和 Selenium 自动化操作浏览器,通过超级鹰平台识别图形验证码坐标,并自动完成点击验证及登录的全过程。内容涵盖驱动创建、页面交互、坐标转换及鼠标模拟点击等关键步骤,适用于解决网页自动登录中的验证码难题。
本文介绍在Python3.6与Selenium2.53.6环境下,利用xlrd库读取Excel文件进行自动化测试的方法。通过封装ExcelUtil类,实现从指定Sheet获取数据并转换为字典列表,结合DDT框架实现数据驱动测试,适用于Web自动化场景。
本文介绍如何使用Selenium结合PhantomJS模拟浏览器行为,以绕过豆瓣读书严格的反爬机制。针对直接请求导致的数据缺失和报错问题,通过模拟浏览器加载获取完整页面信息,并解析存储书籍数据。
本文介绍使用Python Selenium库实现自动化登录百度网盘,并批量读取包含分享链接和提取码的文本文件,自动打开链接、输入提取码并将资源保存至指定目录的完整流程与代码示例。
本文详细介绍Python Selenium中处理Select下拉选择框的两种核心方法:通过XPath直接定位元素,以及利用Selenium内置的Select模块进行标准化操作。重点解析select_by_index、select_by_value和select_by_visible_text三种选择方式,以及取消选择和获取选项属性的相关方法,适用于标准HTML select标签及非标准伪下拉框的自动化测试场景。
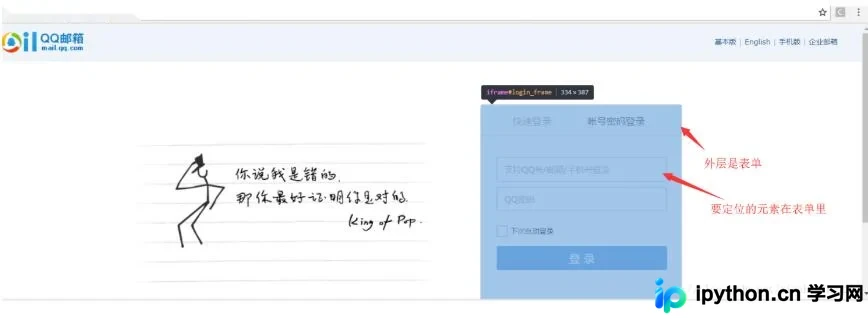
本文详解在Python3 Selenium自动化测试中处理Frame表单嵌套问题的方法。针对直接定位元素报错的情况,通过QQ邮箱登录实例,演示如何识别iframe结构并使用switch_to.frame()进行切换,从而成功定位并操作内部元素,提供完整可运行的代码参考。
本文介绍在Python Selenium自动化测试中如何处理常见的下拉框元素。通过导入selenium.webdriver.support.select模块,利用Select类对指定下拉列表进行定位,并演示如何使用select_by_visible_text方法精确选择如“菠萝”等特定选项,帮助开发者解决Web UI自动化中的表单交互问题。