Selenium中get_cookies()和add_cookie()的用法详解
本文详解Selenium中get_cookies()与add_cookie()函数的使用方法。通过获取当前浏览器Cookie并保存为JSON文件,后续爬虫任务可直接读取该文件并利用add_cookie()注入Cookie,从而绕过登录验证。该方法特别适用于验证码识别困难或需要高频定时爬取且不想频繁登录的场景,有效提升爬虫稳定性和效率。
2026-10-13
6

本文详解Selenium中get_cookies()与add_cookie()函数的使用方法。通过获取当前浏览器Cookie并保存为JSON文件,后续爬虫任务可直接读取该文件并利用add_cookie()注入Cookie,从而绕过登录验证。该方法特别适用于验证码识别困难或需要高频定时爬取且不想频繁登录的场景,有效提升爬虫稳定性和效率。
本文详细介绍Python中Selenium库的基本使用方法,涵盖从导入包、创建驱动对象到请求页面、获取源码及关闭浏览器的完整流程。重点解析find_element与find_elements的定位语法差异,以及如何通过ID、XPath等方式操作点击、输入和获取数据。此外,还包含Cookie处理、JS执行、窗口切换及弹窗处理等高级技巧,帮助开发者高效进行Web自动化测试。
本文详细介绍如何使用Python的Selenium库模拟浏览器行为,实现博客园的自动登录功能。文章从环境准备、ChromeDriver配置到具体代码实现,逐步解析打开浏览器、定位元素、输入账号密码及点击登录的全过程。同时针对可能遇到的滑动验证问题提供了应对建议,旨在为动态网页爬取和自动化测试提供实用参考。
本文详细介绍如何使用Python的Selenium库控制浏览器,结合PIL图像处理库与Tesseract OCR引擎,实现验证码图片的自动截取、预处理及文字识别,并自动填入登录表单完成登录操作。
本文介绍如何使用Python的Selenium库定位并截取登录页面的图片验证码,随后调用百度AI高精度文字识别API进行OCR解析。通过获取验证码坐标、截取局部图像及调用SDK,实现自动化登录流程中的验证码自动填充与提交,适用于Web自动化测试场景。
本文详细介绍如何利用Python结合Selenium库破解滑块验证码并实现自动登录。内容涵盖图像处理定位缺口位置、模拟人类滑动轨迹算法以及自动化浏览器操作。通过具体代码示例,展示如何计算位移距离、生成符合行为特征的滑动轨迹,并最终完成登录验证,为Web自动化测试提供实用参考。
本文介绍如何在Python中使用Selenium时彻底关闭ChromeDriver进程,避免残留进程导致系统卡顿。通过Service类管理驱动生命周期,使用quit()而非close(),以及利用os模块调用taskkill命令强制结束进程,提供完整代码示例与注意事项。
本文介绍如何使用Python和Selenium库自动化获取QQ群成员信息。通过模拟浏览器操作,自动登录并滚动加载页面,提取群成员昵称、QQ号等字段,最终导出为Excel文件。适用于拥有群主或管理员权限的场景,代码示例包含环境配置及核心抓取逻辑。
本文详细介绍如何使用Python、Selenium和PIL库实现网页特定元素的长截图功能。通过获取元素尺寸、循环滚动截取、裁剪及拼接图片,解决元素高度超过屏幕可视区域的问题。同时提供短元素截取的优化方案及iframe处理技巧,附带完整可运行代码。
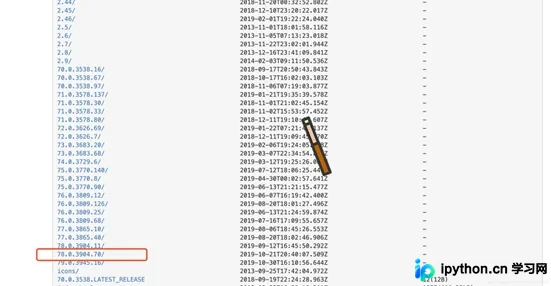
本文详细介绍在Mac系统中使用Python和Selenium进行浏览器自动化的基础配置。涵盖从安装Selenium库、获取与Chrome版本匹配的ChromeDriver驱动,到解压放置及编写简单自动化脚本的完整流程。通过百度首页搜索示例,演示如何控制浏览器、截图及获取页面数据,帮助初学者快速上手Web自动化测试。
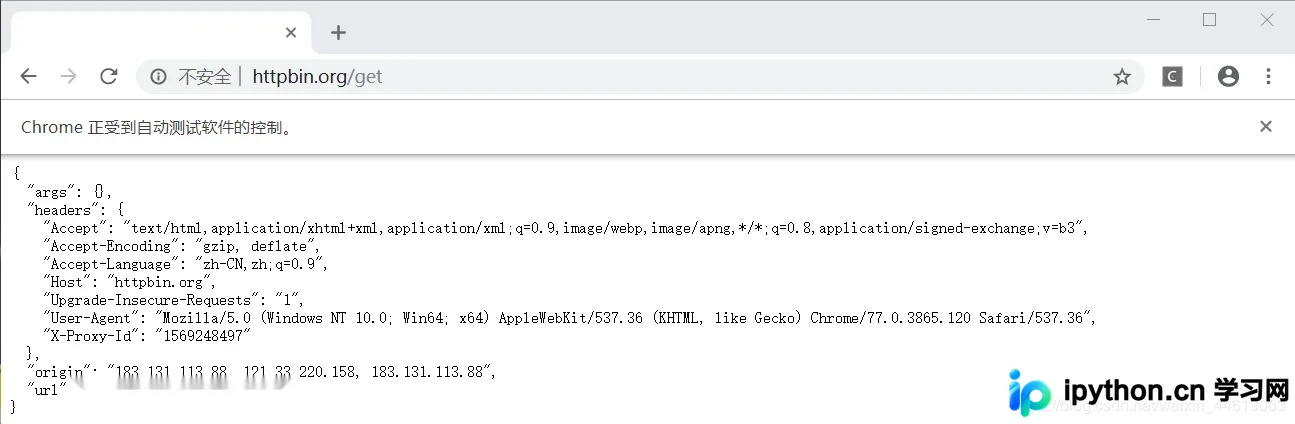
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
本文详解使用PyInstaller打包Selenium Python脚本时遇到的常见坑。针对打包后exe在其他机器闪退的问题,重点排查浏览器驱动与插件版本匹配及文件路径;针对运行出现CMD黑窗口的问题,通过修改service.py源码添加creationflags参数,并结合-F -w命令实现无头后台运行,确保程序稳定且界面简洁。