Python Selenium 实现 QQ 群成员数据抓取与清洗
本文介绍使用 Python Selenium 自动化抓取 QQ 群成员信息的完整流程。通过模拟浏览器登录、选择目标群组及动态滚动加载页面,提取群成员列表。代码重点展示了如何清洗数据,去除群主和管理员身份,并仅保存普通成员的 QQ 号至本地文件,适用于需要批量获取群成员联系方式的场景。
2026-10-13
6

本文介绍使用 Python Selenium 自动化抓取 QQ 群成员信息的完整流程。通过模拟浏览器登录、选择目标群组及动态滚动加载页面,提取群成员列表。代码重点展示了如何清洗数据,去除群主和管理员身份,并仅保存普通成员的 QQ 号至本地文件,适用于需要批量获取群成员联系方式的场景。
本文介绍使用Python3.7结合Selenium库实现淘宝网站密码登录的完整流程。重点解析如何应对登录时的滑动验证码挑战,通过定位元素、计算滑动距离及模拟轨迹,成功绕过验证机制。文章提供从环境配置到代码实现的详细步骤,帮助开发者掌握自动化登录技巧。
本文介绍使用Python 3.8.1与Selenium 3.141.0实现QQ邮箱登录滑块验证的自动化脚本。通过模拟人类移动轨迹,利用ActionChains控制滑块拖动,解决常见的人机验证问题。文章包含完整代码示例及关键参数说明,适用于同类滑块验证场景的参考与实现。
本文介绍使用Python Selenium库模拟人工操作,实现学习强国平台文章阅读、视频观看及每日答题的自动化积分获取。通过解析DOM元素、模拟点击与滚动,结合PyQt5界面,实现无人值守的积分刷取功能,旨在解决日常刷分耗时问题。
本文介绍如何使用Python Selenium库进行网页截图。通过演示get_screenshot_as_file和save_screenshot两个方法,展示如何将百度首页保存为指定格式的PNG图片,并生成带时间戳的文件名。
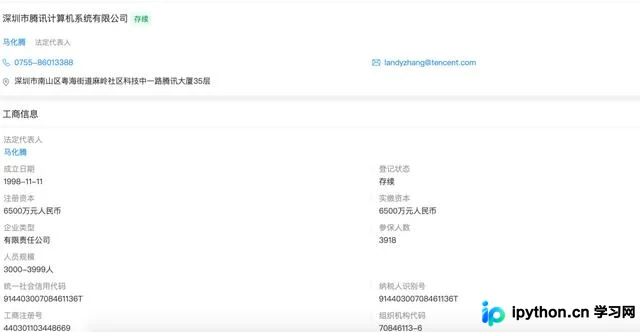
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
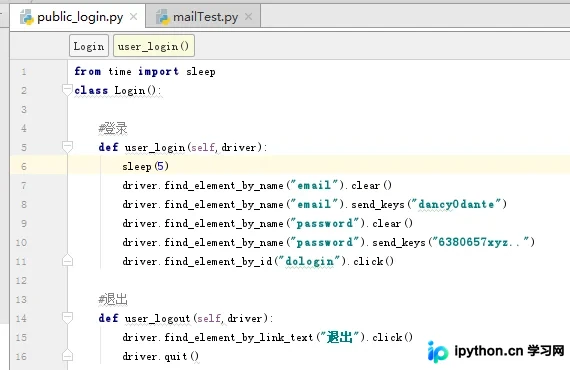
本文深入解析Python Selenium自动化测试的三种核心模型:线性测试、模块化驱动测试及数据驱动测试。详细对比各模型在开发成本、维护复杂度及脚本复用性方面的优劣,并通过具体代码逻辑说明如何实现参数化、文件读取(TXT/CSV/XML)及函数封装,旨在帮助测试人员提升脚本可维护性与执行效率。
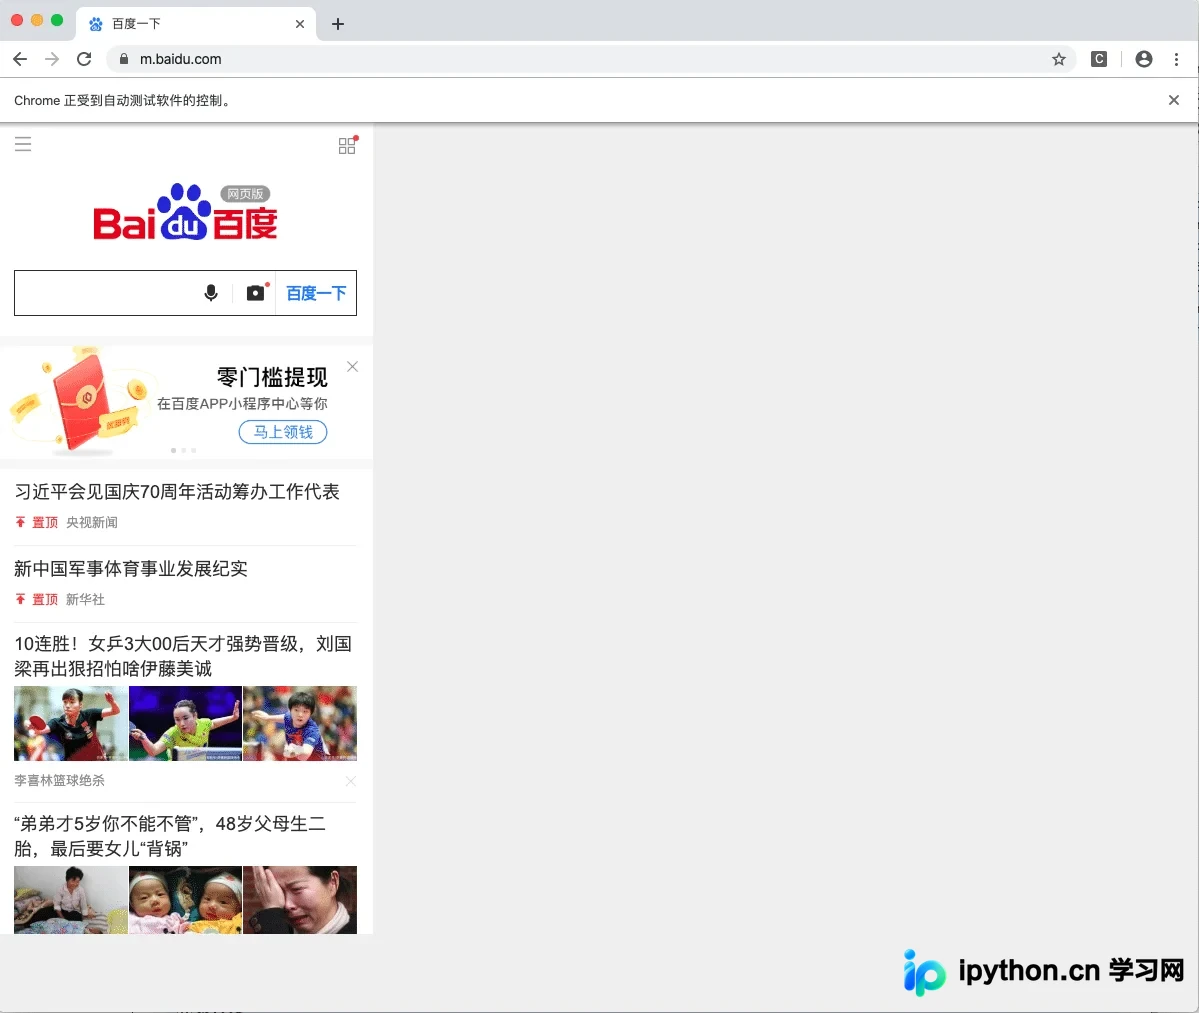
本文解析如何利用Selenium控制Chrome浏览器模拟移动端环境。通过ChromeOptions配置mobileEmulation,可调用预设设备名称(如iPhone X)或自定义设备指标(宽度、高度、像素比及User-Agent)。该方法适用于H5页面兼容性测试及降低移动端反爬策略影响,提供完整代码示例与参数说明。
本文详细介绍在Linux系统中安装Chrome浏览器及Chromedriver的方法,推荐使用淘宝镜像源加速下载。重点解析Python Selenium脚本配置,包括无头模式、沙箱参数及字体安装以解决中文乱码。同时针对截图时常见的TimeoutException异常,提供通过添加headless及禁用GPU等参数的具体解决方案。
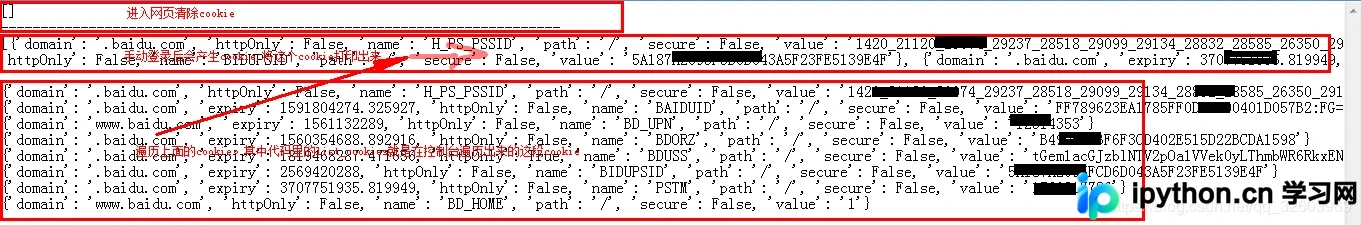
本文介绍如何利用Python3与Selenium库实现Cookie免密登录。通过清除现有Cookie、手动或程序化获取目标网站的Cookie信息,再将获取的Cookie添加至浏览器会话中,从而跳过密码登录步骤。文章提供了具体的代码示例,包括登录获取Cookie和后续免密登录两个场景,适用于爬虫和自动化测试场景。
本文详细介绍Python Selenium中ChromeOptions类的核心配置方法。涵盖禁止图片加载、添加代理IP、修改User-Agent、设置编码及禁用JavaScript等常用技巧,并提供关闭密码提示框、添加扩展插件等高级配置代码示例,帮助开发者提升爬虫稳定性与执行效率。
本文详细介绍在Windows系统下配置Python Selenium自动化测试环境的完整步骤。内容涵盖Python与pip的安装、Selenium库的部署、兼容版Firefox浏览器及对应Driver(geckodriver)的配置,并通过一个打开百度的Python脚本验证环境是否成功搭建。