

Python Selenium自动化测试三大模型详解:线性、模块化与数据驱动

本文深入解析Python Selenium自动化测试的三种核心模型:线性测试、模块化驱动测试及数据驱动测试。详细对比各模型在开发成本、维护复杂度及脚本复用性方面的优劣,并通过具体代码逻辑说明如何实现参数化、文件读取(TXT/CSV/XML)及函数封装,旨在帮助测试人员提升脚本可维护性与执行效率。
线性测试模型及其局限性
线性测试是自动化测试的基础模式。
其核心优势在于每个测试脚本均保持完整且独立,确保单一脚本与单一测试用例严格对应。
然而,该模式存在显著缺点:开发成本高昂,因大量重复操作导致脚本冗余;同时维护成本极高,一旦涉及重复操作的修改,需逐一更新所有相关脚本。
模块化驱动测试的优化方案
为解决线性测试的局限性,模块化驱动测试应运而生。
该模式将重复的操作逻辑独立封装为公共模块,当测试用例执行需要此类操作时直接调用。这种方式最大限度地消除了代码冗余,显著提升了测试用例的可维护性。
模块化驱动测试主要解决了线性测试中的两个关键问题:
第一,大幅提高了脚本的开发效率。
第二,简化了后续的维护复杂性。
尽管有上述优点,该模式在数据频繁变更的场景下仍存在缺陷。例如,测试不同用户登录场景时(如先张三后李四),虽然登录步骤一致,但登录数据不同,这会导致仍需编写大量重复的登录脚本。
针对此类问题,可通过定义类并将登录函数进行封装来解决。
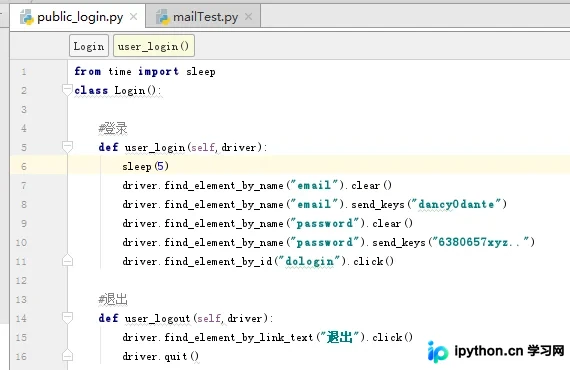
随后编写主程序调用该封装好的登录函数,实现逻辑复用。
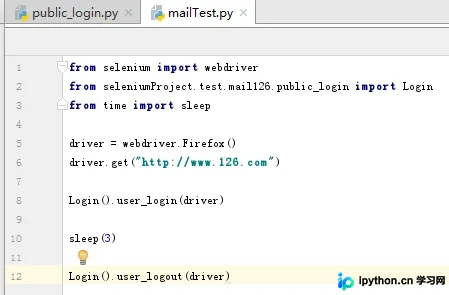
数据驱动测试的实现与文件处理
数据驱动测试是解决数据与逻辑耦合的高级方案。
其核心在于数据的参数化,即通过输入数据的差异导致输出结果的不同。无论是定义的数组、字典,还是外部文件(如Excel、CSV、TXT、XML等),均可视为数据驱动的一部分,其根本目的是实现数据与脚本的彻底分离。
该模式的优点在于进一步增强了脚本的复用性。
具体实现方式之一是通过参数化来实现数据驱动。
将待输入的值作为参数传入,使得脚本能够根据输入数据的不同执行不同的结果分支。
例如,将登录函数以传参方式进行封装。
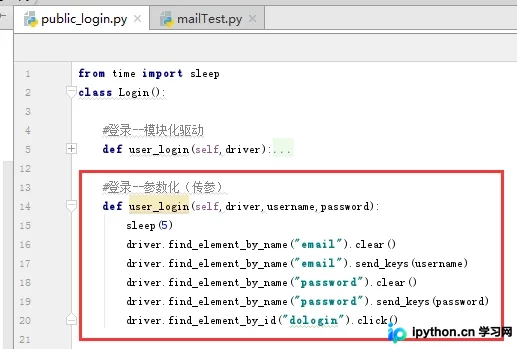
在主方法中调用该方法时,传入不同的参数即可实现多场景覆盖。
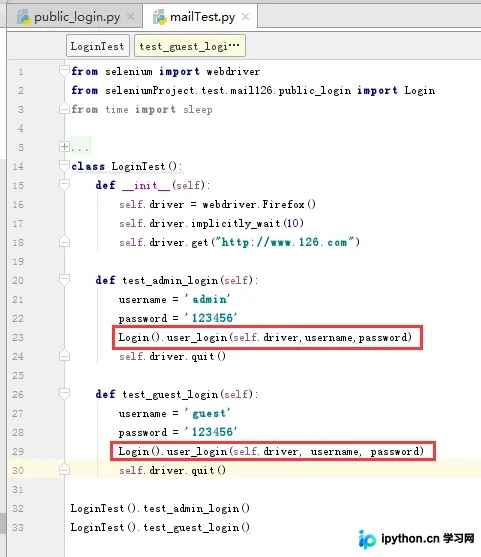
另一种应用是参数化搜索关键字。
将待搜索的关键字定义为一组数组,通过循环方式执行搜索。由于关键字不同,测试结果也会随之变化。
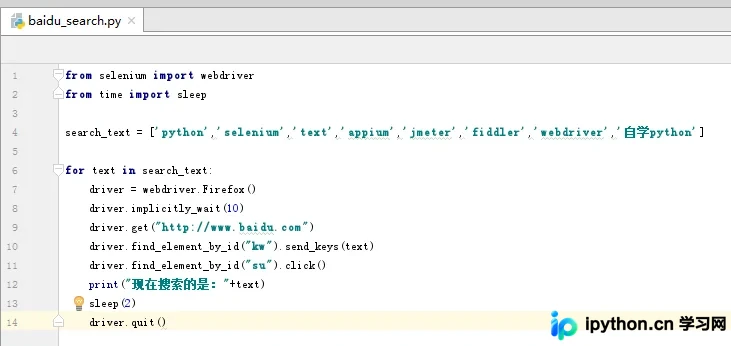
此外,数据驱动还支持读取TXT文件。
Python提供了多种读取TXT文件的方式:
read()方法用于读取整个文件内容。
readline()方法用于读取单行数据。
readlines()方法用于读取所有行的数据并返回列表。
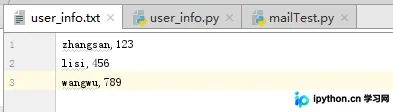
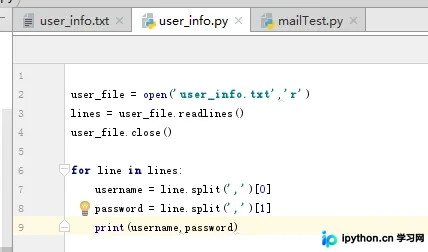
除了TXT,数据驱动同样适用于读取CSV文件。
同时,也支持读取XML文件。
使用parse()函数打开XML文件。
通过documentElement属性获取XML文件中唯一的根元素。
利用nodeName属性获取节点名称。
利用nodeValue属性获取节点值。
利用nodeType属性获取节点类型。
其中ELEMENT_NODE表示元素节点类型。
使用getElementsByTagName()方法可通过标签名获取标签,返回的对象以数组形式存储。
利用getAttribute()方法获取元素的属性值,其功能与webdriver中的get_attribute()类似。
利用firstChild属性返回被选节点的第一个子节点。
利用data属性获取该节点的数据,其功能与webdriver中的text方法类似。
以上即为Python Selenium自动化测试三大模型的核心内容,希望能为读者的学习与实践提供有益参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









