

Selenium解决网页懒加载与滚动加载问题的两种方案
本文介绍Selenium处理网页内容需滚动加载的两种方法:调整浏览器窗口高度延时加载,以及模拟下拉滚动操作。针对懒加载特性,强调page_source仅包含已加载内容,需通过模拟滚动触发加载。提示网速慢时需增加等待时间,确保获取完整HTML后再执行翻页或元素定位操作。
2026-10-13
6

本文介绍Selenium处理网页内容需滚动加载的两种方法:调整浏览器窗口高度延时加载,以及模拟下拉滚动操作。针对懒加载特性,强调page_source仅包含已加载内容,需通过模拟滚动触发加载。提示网速慢时需增加等待时间,确保获取完整HTML后再执行翻页或元素定位操作。
本文介绍使用 Python 的 Selenium 库抓取页面点击后弹出的窗口信息。通过 Firefox 浏览器配合 GeckoDriver,利用 XPath 定位元素并切换窗口句柄获取数据。针对自动化测试中点击按钮弹窗不显示的问题,提供使用模拟键盘 Enter 键替代 click() 的解决方案,并附带完整代码示例。
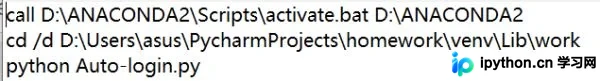
本文详解如何利用Python Selenium库模拟浏览器行为,实现学校每日健康自动登记。内容涵盖处理嵌套表单、提取验证码、应对弹窗及异常退出等核心难点,并结合Windows批处理文件与Anaconda环境配置定时任务,确保即使关机也能自动唤醒执行,提供一套完整的自动化解决方案供学习交流。
本文介绍如何在Python中使用os.chmod和stat.S_IWRITE移除文件的只读属性,并详细列举四种通过Selenium执行JavaScript移除Web端时间控件readonly属性的方法,包括原生JS和jQuery操作,帮助解决自动化测试中输入框无法编辑的问题。
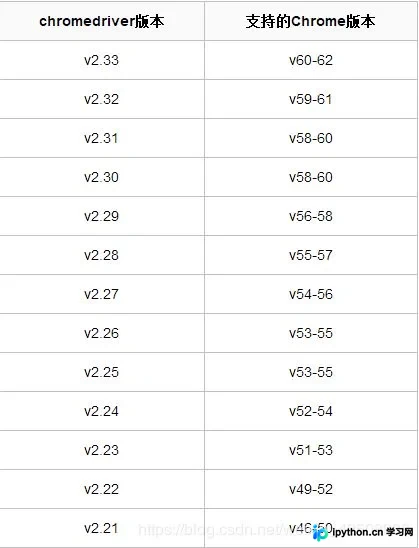
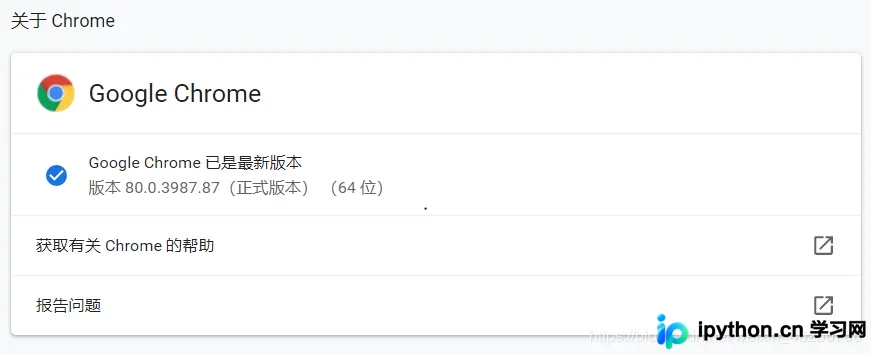
本文详解Selenium自动化测试中ChromeDriver找不到的常见原因及解决方案。重点介绍如何根据浏览器版本下载匹配的驱动,通过配置系统环境变量或直接在代码中指定executable_path路径来解决报错。针对即使配置环境变量仍报“cannot find Chrome binary”的情况,提供了具体的代码级路径指定方法,确保自动化脚本稳定运行。
本文介绍如何利用Python的Selenium库解决JavaScript渲染页面的数据抓取问题,获取实时确诊人数,并结合Pyecharts库将数据转化为交互式地图。文章详细讲解了ChromeDriver配置、页面等待机制及正则表达式提取数据的具体步骤,最后通过完整代码展示如何生成可视化图表。
本文介绍如何利用Python的Selenium库定位网页元素,结合Pillow库对动态生成的验证码图片进行截图和精准裁剪,并通过调用图鉴等第三方商业接口实现自动化识别。该方法适用于解决Web端图片验证码登录或注册场景,包含完整的代码实现与错误处理建议。
本文详细介绍在Windows系统中使用Python调用打印机打印文件的几种主流方法。包括通过os.system执行print命令、利用win32api和win32print库直接控制打印机、使用Selenium结合win32gui模拟浏览器打印操作,以及借助Ghostscript静默打印PDF文件的完整代码示例与参数解析。
本文介绍如何利用Python结合Selenium框架实现网课自动播放。内容涵盖自动登录、使用tesserocr库识别简单验证码、处理ElementNotInteractableException异常以及定时关闭课程弹窗。通过具体代码示例,帮助读者掌握网页自动化操作技巧,解决手动刷课效率低下的问题。
本文详细解析 Python Selenium 的浏览器窗口大小与位置控制方法,对比显式等待与隐式等待的执行逻辑。重点列举 Chrome 浏览器的高级启动参数,包括无头模式、代理、缓存路径、禁用插件及模拟移动设备等配置技巧,帮助开发者优化自动化测试脚本性能与兼容性。
本文详解Selenium中处理多窗口切换的核心方法。通过Java代码示例,演示如何使用getWindowHandle获取当前窗口句柄,利用getWindowHandles遍历所有窗口,并借助switchTo().window()精准切换至目标窗口进行操作。内容涵盖新浪网的实际测试场景,帮助开发者解决弹窗及关联页面操作难题。
本文详解Selenium中get_cookies()与add_cookie()函数的使用方法。通过获取当前浏览器Cookie并保存为JSON文件,后续爬虫任务可直接读取该文件并利用add_cookie()注入Cookie,从而绕过登录验证。该方法特别适用于验证码识别困难或需要高频定时爬取且不想频繁登录的场景,有效提升爬虫稳定性和效率。