

Python实现ComicReaper漫画自动爬取脚本详解

本文详细介绍使用Python 3开发ComicReaper漫画自动爬取脚本的全过程。通过解析HTML结构,利用re与urllib库提取章节标题与URL,并设置User-Agent和Referer请求头以模拟浏览器行为,实现从指定主页URL自动获取整本漫画章节目录的功能。
Python实现ComicReaper漫画自动爬取脚本详解
本文详细解析基于Python实现ComicReaper漫画自动爬取脚本的具体过程,文中通过示例代码进行了详尽介绍,对读者的学习或工作具有参考价值。
在实际手机阅读漫画时,频繁翻页容易误触页面上的广告,造成不便。
若能仅需指定一本漫画的主页URL,即可自动返回整本漫画内容,将极大提升体验。
这一需求促使我产生使用Python 3开发ComicReaper(漫画收割者)的想法。
本文演示所用的漫画链接为:http://www.manhuadb.com/manhua/2317
接下来概述整体处理流程。
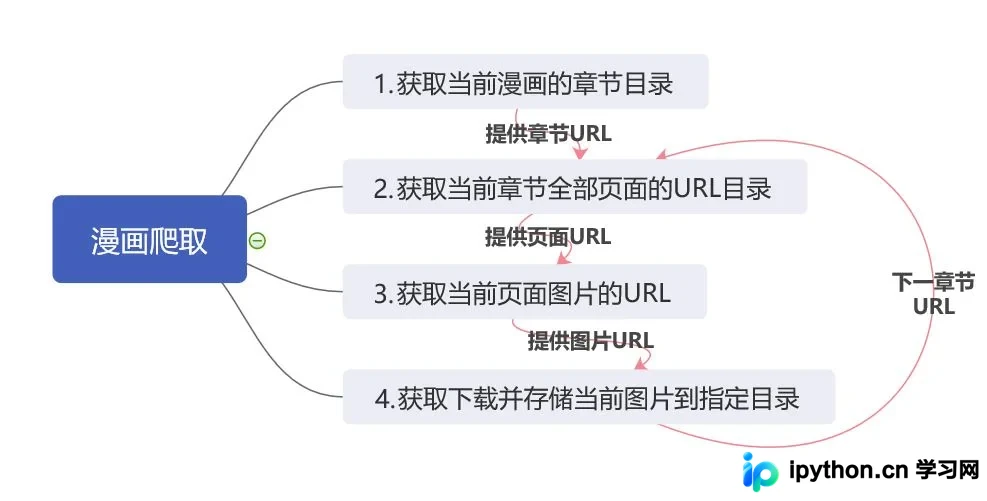
准备工作与请求头设置
现在开始具体实施步骤。
首先进行必要的准备工作。
使用字符串分别存储两个链接:一个是本次漫画网站站点的域名URL,另一个是当前要爬取的漫画的主页URL。
接着定义一个header字典,用于存储User-Agent和Referer字段(由于早期HTTP规范的拼写错误,为保持向后兼容,此处沿用了Referer这一拼写)。
关于首部字段User-Agent的作用。
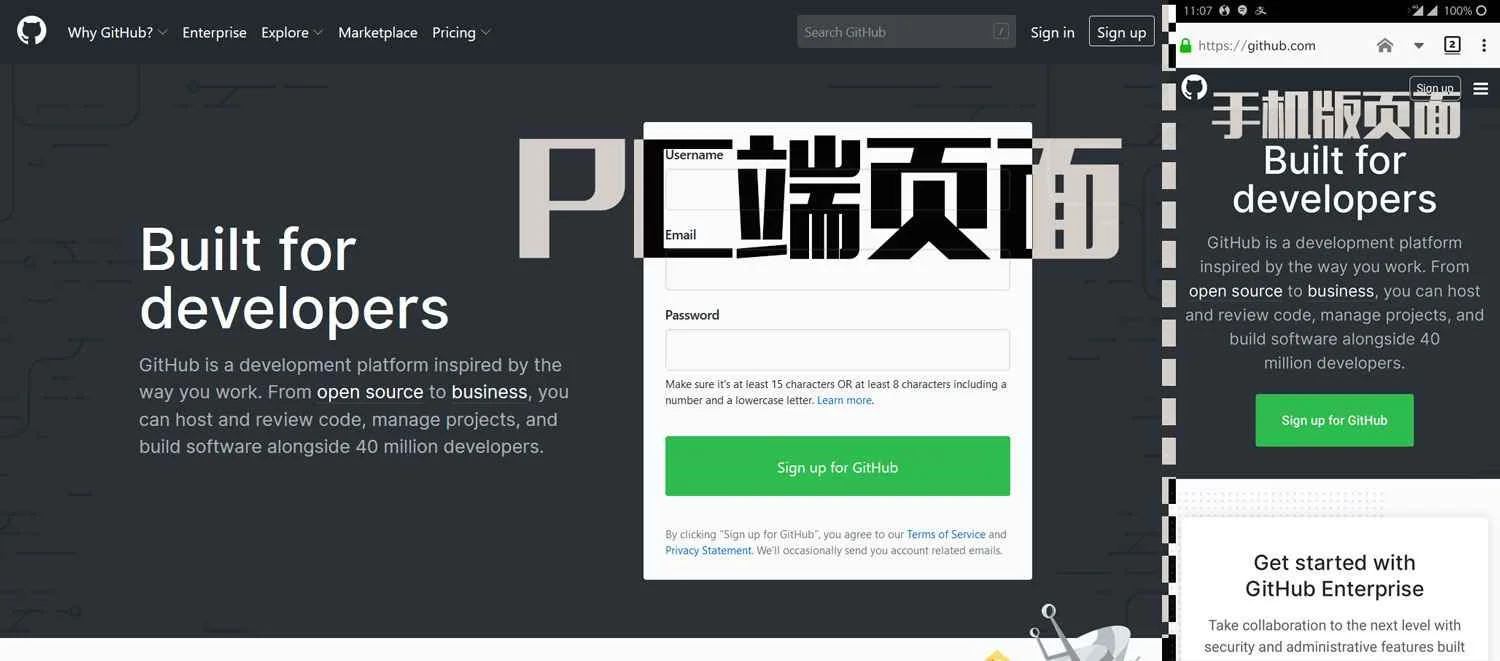
User-Agent字段用于告知服务器当前发起请求的浏览器类型。部分网站会根据浏览器类型提供不同版本的页面,例如针对手机浏览器的请求,服务器会返回手机版页面。
以请求GitHub主页为例,左侧展示的是通过笔记本电脑浏览器请求的页面,右侧则是通过安卓手机浏览器请求的页面,两者可能存在差异。
关于首部字段Referer的作用。
Referer字段用于告知服务器当前请求是从哪个Web页面发起的,通常用于防止盗链。
部分网站限制直接访问内部URL,要求必须通过主页点击链接跳转。因此,在发起请求前,将User-Agent字段设置为主页或来源页的标识,可模拟合法访问。
url_domainame = r'http://www.manhuadb.com'
url_host = r'http://www.manhuadb.com/manhua/2317'
header = {
  'User-Agent' : 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:70.0) Gecko/20100101 Firefox/70.0',
  'Referer' : ''
  }
获取章节目录的实现逻辑
进入获取章节目录的具体环节。
首先对后续操作进行具体的流程分析。
目标是获取当前漫画所有章节的标题与URL,其中标题用于后期存储时作为文件夹命名,URL用于跳转到当前章节的开始页面,并将这些信息存储在列表中。
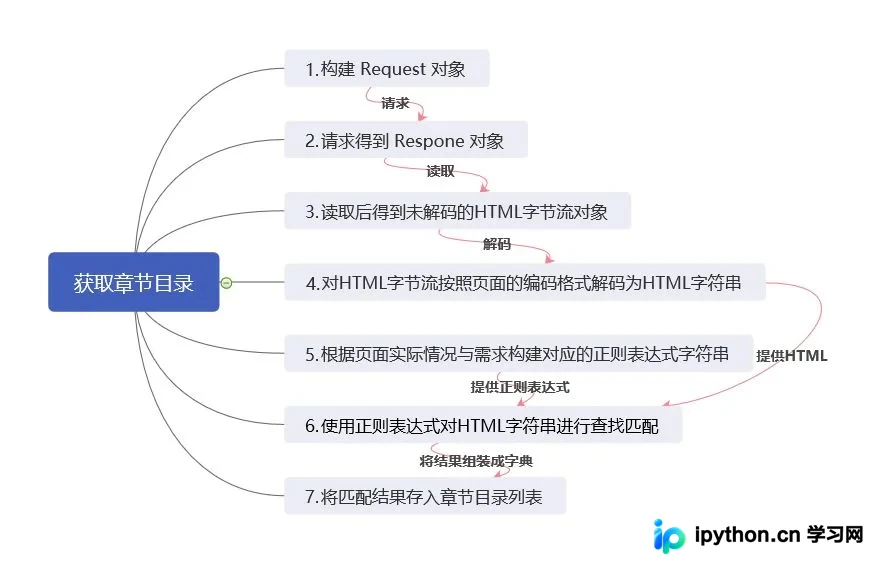
实现过程中将使用Python的两个库:re(正则表达式)与urllib。
 import re         # 导入正则表达式
 import urllib.request  # 导入 urllib.request
在浏览器中按下[F12]键打开开发者工具,对漫画的章节页面进行分析。
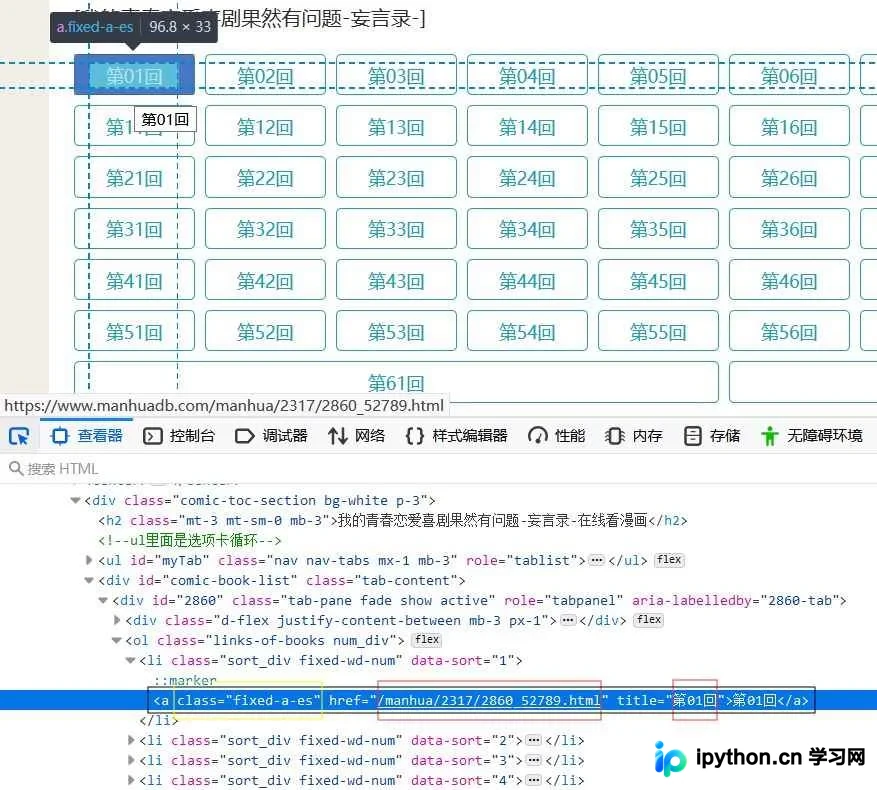
观察页面可见许多章节跳转链接,每个链接的<a>标签中包含了我们需要的标题和URL,分别对应<a>标签的title属性与href属性,我们将使用字典来存储这些数据。
在编码前需注意,整个HTML中包含大量链接和<a>标签,若单纯过滤所有<a>标签会获取大量无用数据。因此,必须精准过滤出章节跳转链接对应的<a>标签。观察发现,这些特定<a>标签均具有class属性且值为"fixed-a-es",这成为定位章节链接的关键依据,需将其加入正则表达式的匹配规则中。
基于上述分析,定义如下正则表达式匹配字符串:
pat = r'<a class="fixed-a-es" href="(.*?)" rel="external nofollow" rel="external nofollow" title="(.*?)"'对该正则表达式写法的具体解释如下:
- 在Python字符串常量开头加'r',表示该字符串中的'\'字符不作为转义字符使用,保留其反斜杠字符的本意。
- 在正则表达式中,'.'字符用于匹配任何字符(当使用're.S'标志时成立,否则仅匹配除'\n'外的任意字符)。
- 在正则表达式中,'*'字符表示其左边的匹配字符出现0次或若干次。
- 在正则表达式中,'(.*?)'组合表示非贪婪匹配,并将匹配内容捕获到分组中。
使用此正则表达式,即可匹配到title属性与href属性值中双引号内的内容。
具体实现为chapterIndexReaper函数,主要功能是“收割”当前漫画的所有章节,并将其存储为字典列表。
相关代码如下:
#获取一本漫画的所有章节的目录
def chapterIndexReaper(url_host, header):
  # 定义一个临时字典, 用于临时存储一个章节的标题与url
  dic_temp = {
    'Title' : '',
    'Url' : ''
    }
  # 章节字典列表, 存储当前漫画的所有章节字典
  set_dic = []
  # 构建Request对象
  req = urllib.request.Request(url = url_host, headers = header)
  # 读取所请求的req并用utf-8编码来进行解码, 所得到的的字符串赋值给html
  html = urllib.request.urlopen(req).read().decode('utf-8')
  # 爬取漫画章节标题与url的正则表达式
  pat = r'<a class="fixed-a-es" href="(.*?)" rel="external nofollow" rel="external nofollow" title="(.*?)"'
  # 使用pat在html中进行进行匹配(re.S参数是为了让"."除了能够匹配本身规定的字符,
  # 另外也能匹配"\n"), 返回一个结果列表res
  res = re.findall(pat, html, re.S)
  for i in res:
    dic_temp['Title'] = i[1]
    dic_temp['Url'] = url_head + i[0]
    # 向当前的章节字典列表的后面追加新的章节, 注意, 此处要使用浅拷贝
    # (因为dic_temp是一个临时变量, 需要创建它的副本并追加到set_dic中去,
    # 否则当dic_temp刷新时set_dic中的元素会相应发生改变)
    set_dic.append(dic_temp.copy())
  return set_dic
以上为本文的全部内容,希望对读者有所帮助,欢迎继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









