Python正则表达式:解决贪婪匹配问题,实现最短匹配
本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
2026-10-14
6

本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
本文介绍如何使用Python正则表达式实现一个简易计算器。通过递归处理括号、优先计算乘除、最后处理加减,逐步解析复杂数学表达式。代码展示了核心逻辑,包括括号匹配、符号转换及数值累加,适合学习正则表达式在字符串解析中的应用。
本文介绍在Python中从混合列表或字符串中过滤数字的多种方法。包括使用正则表达式匹配非纯数字项、利用try-except捕获类型转换异常、调用string内置方法判断字符属性,以及使用strip去除两端数字。此外,还展示了filter结合str.isdigit/isalpha/isalnum保留特定字符类型的技巧,适用于数据处理与清洗场景。
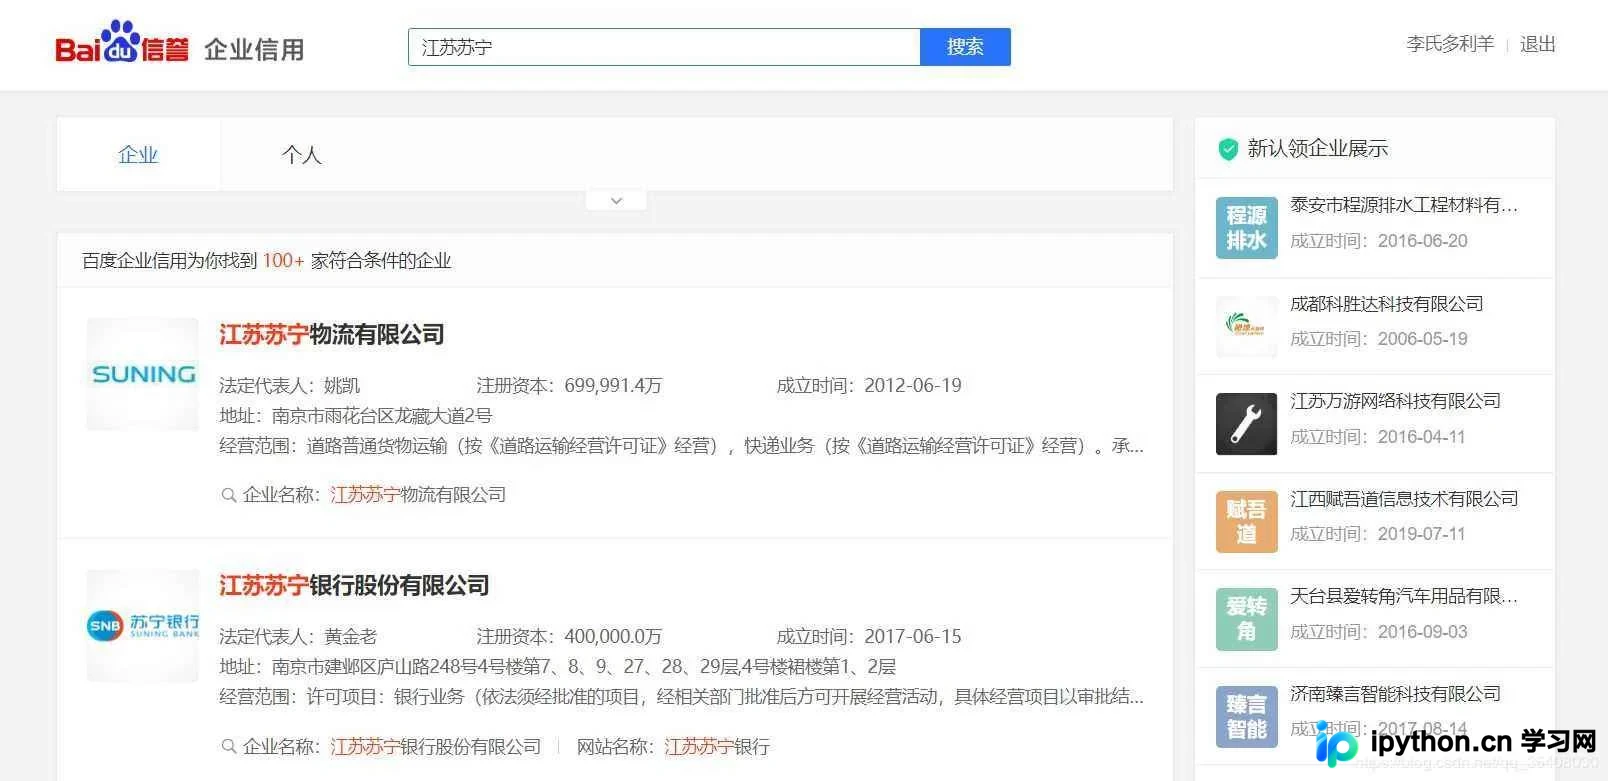
本文介绍如何使用Python爬虫从百度企业信用网站获取企业基本信息。通过分析页面JavaScript动态生成的数据,利用正则表达式提取resultList字段并转换为JSON对象,从而获取企业名称、法人、注册资本等详细信息。文章提供完整源码及调用示例,适用于学习参考,请勿用于恶意爬取。
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
本文深入解析Python中正则表达式的高级应用,涵盖非贪婪模式、分组匹配、反向引用、命名分组及先行断言等核心概念。通过具体代码示例,演示如何精确控制匹配行为,解决HTML标签匹配、特定格式提取等实际问题,并介绍相关标记参数,帮助开发者提升文本处理效率。
本文介绍Python中校验IP地址合法性的三种常用方法。第一种不使用正则表达式,通过分割字符串并逐段验证数字范围实现;第二种利用正则表达式进行模式匹配;第三种结合正则查找与数值范围判断。文章提供了相应的代码示例,帮助开发者快速实现IP合法性检查功能。
本文详解使用Python实现密码验证程序的完整思路。程序需处理多行输入,对每行密码进行三项核心校验:长度必须超过8位;需包含大小写字母、数字及特殊符号中的至少三种;严禁存在长度超过2的重复子串。通过结合循环遍历与正则表达式,可有效判断密码是否符合规范并输出OK或NG结果。
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文介绍如何使用Python脚本批量去除指定文件夹中所有Python文件的注释。通过结合正则表达式匹配单行及多行注释,并读取INI配置文件指定源与目标路径,实现自动化清理。脚本支持忽略特定格式的注释行,并将处理后的文件保存至新目录,适用于代码优化或清理场景。
本文介绍如何利用Python3的PyPDF2库读取PDF文件内容,并通过正则表达式精准提取特定数据。代码演示了遍历页面、合并文本、匹配股票代码与数值,以及将结果保存为CSV格式的全过程,适用于需要批量处理PDF文档数据的场景。
本文深入解析Python中正则表达式模块re的match()与search()函数的核心区别,通过代码示例展示两者在匹配位置与返回结果上的差异。此外,针对Jupyter Notebook环境中主函数调用类文件时常见的模块未找到问题,提供了基于Ipynb_importer.py的完整解决方案,帮助开发者顺利实现notebook间的模块引用与运行。