Python正则表达式re.search()基础用法详解
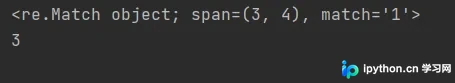
本文详细介绍Python中re.search()函数的基本用法。涵盖其三个核心参数:pattern、string及可选的flags标志位。通过多个代码示例演示如何匹配字符串、获取匹配位置span()、提取内容group(),以及使用re.I忽略大小写。同时讲解结合compile预编译提升效率的方法,并深入解析group()中数字索引与命名分组的使用区别。
2026-10-15
6

本文详细介绍Python中re.search()函数的基本用法。涵盖其三个核心参数:pattern、string及可选的flags标志位。通过多个代码示例演示如何匹配字符串、获取匹配位置span()、提取内容group(),以及使用re.I忽略大小写。同时讲解结合compile预编译提升效率的方法,并深入解析group()中数字索引与命名分组的使用区别。
本文详解Python中文件流的读写操作,涵盖使用try-except进行异常捕获、while循环检测文件末尾以及for循环遍历行的多种读取方式。同时深入解析字符串处理模块,包括strip()去除首尾字符、replace()替换指定子串及re.sub()结合正则表达式批量删除字符的实用技巧,帮助开发者高效处理文本数据。
本文介绍如何利用Python的Requests库进行网页请求,结合正则表达式解析HTML结构以提取文件链接,并实现批量下载开源网站的代码与数据。文章提供了完整的Python 3.x环境配置说明,包含requests、re及用于构建图形界面的gooey库。通过示例代码展示如何判断路径类型、创建目录及递归下载文件,支持自定义保存路径与目标URL,适合需要自动化获取开源资源的技术人员参考。
本文详细解析Python中re.search()函数的使用方法,对比其与find()函数的异同。通过逐步构建正则表达式,演示如何从简单字符查找进阶到复杂IP地址(0-255范围)的精准匹配,涵盖分组、量词及边界处理等核心技巧,帮助开发者掌握正则表达式在字符串处理中的实际应用。
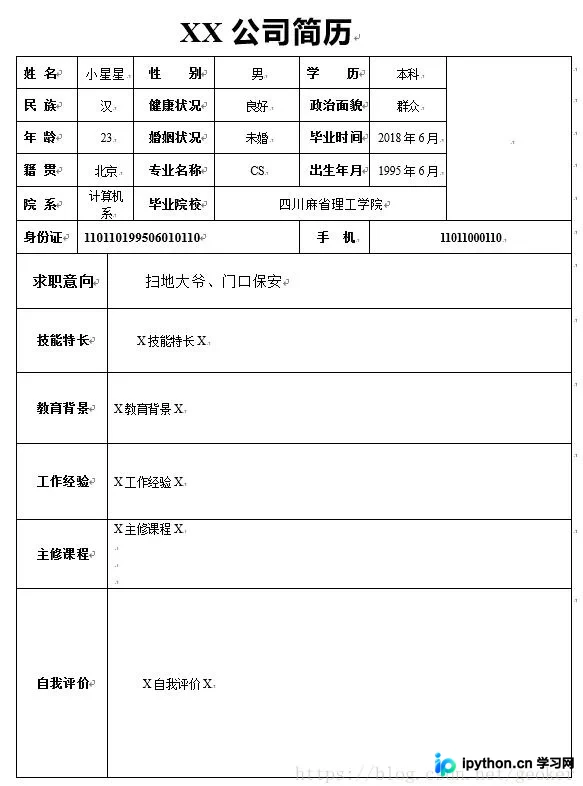
本文介绍如何利用Python自动处理大量Word表格简历。通过解析docx文件内部的zip结构和document.xml,结合正则表达式提取姓名、学历等关键字段,并批量写入txt或Excel文件。文章提供完整代码示例及常见权限错误解决方案,帮助开发者高效完成数据整理任务。
本文介绍如何在Python中利用正则表达式从文本中提取中文年份,并通过字典映射将其转换为阿拉伯数字。通过定义匹配规则和使用re.findall函数,结合自定义的中文数字到阿拉伯数字的映射字典,实现如“一九四九”到“1949”的自动转换,适用于文本清洗和历史数据解析场景。
本文介绍在Python3中判断输入字符串是否为合法点分十进制IP地址的方法,并提供三种实现方案。若合法则转换为大写16进制格式输出,否则输出Error。内容涵盖正则匹配、列表解析及基础循环判断,适用于Python基础学习与网络编程场景。
在 Python 中使用正则表达式时,默认的 . 点符号无法匹配换行符,导致跨行文本获取失败。本文指出该限制并提供正确解决方案:使用 [\s\S]*、[\d\D]* 或 [\w\W]* 等字符类组合来匹配包括换行符在内的任意字符,确保能完整提取多行文本内容。
本文详细介绍Python中re模块的两个核心函数:re.sub用于字符串匹配替换,支持计数及复杂处理;re.compile将正则预编译为对象以提升效率。通过具体代码示例展示参数用法及Lambda表达式在替换中的应用,帮助初学者掌握常见正则操作。
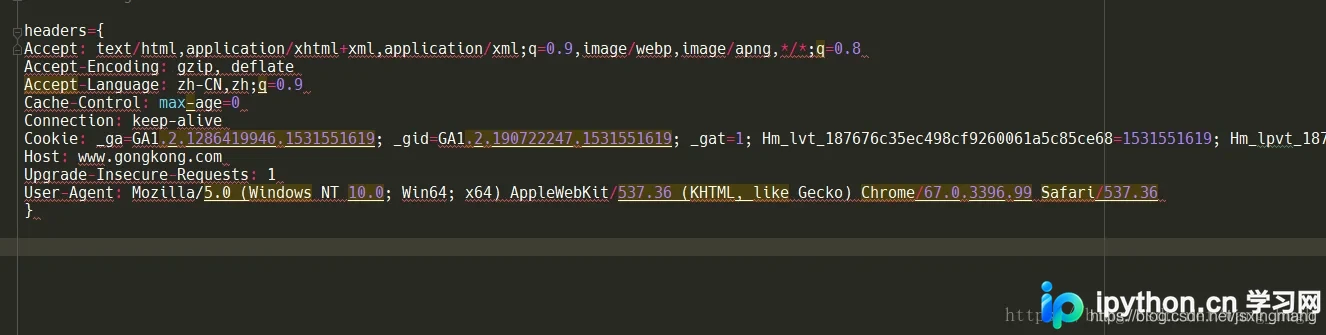
本文介绍如何在 PyCharm 中利用正则替换功能,快速将浏览器复制的 Request Headers 文本转换为标准的 Python 字典键值对格式。通过 Ctrl+R 调用正则工具,配合特定正则表达式与替换规则,可一键完成引号添加与格式整理,大幅提升爬虫开发效率。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
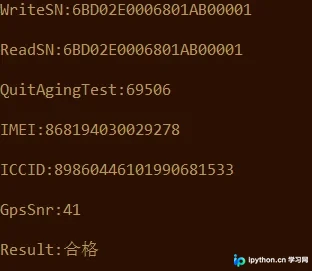
本文详解如何使用Python脚本批量处理10000份产品Log文件,自动提取SN、IMEI和ICCID信息并生成Excel表格。通过遍历目录、读取文件内容并结合正则表达式匹配关键字,实现高效的数据自动化采集,适用于大规模日志数据分析场景。