Python爬虫爬取图片的简单代码
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
2026-10-14
6

本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
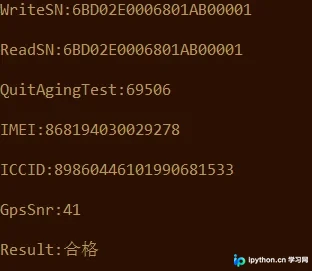
本文详解如何使用Python脚本批量处理10000份产品Log文件,自动提取SN、IMEI和ICCID信息并生成Excel表格。通过遍历目录、读取文件内容并结合正则表达式匹配关键字,实现高效的数据自动化采集,适用于大规模日志数据分析场景。
本文详细解析Python中regex库的常见用法,涵盖直接调用、编译及匹配操作。通过具体代码实例展示如何对字符串和字符进行正则搜索与匹配,帮助开发者掌握regex在项目中的实际应用技巧。
本文详解如何利用Python正则表达式从文本中精准提取版本号。通过解析正则模式r'\d+\.(?:\d+\.)*\d+',结合re模块的findall与group方法,实现从源文件读取并写入目标文件的全流程。文章还深入对比了捕获组与非捕获组的区别,帮助开发者避免常见陷阱,提升文本解析效率。
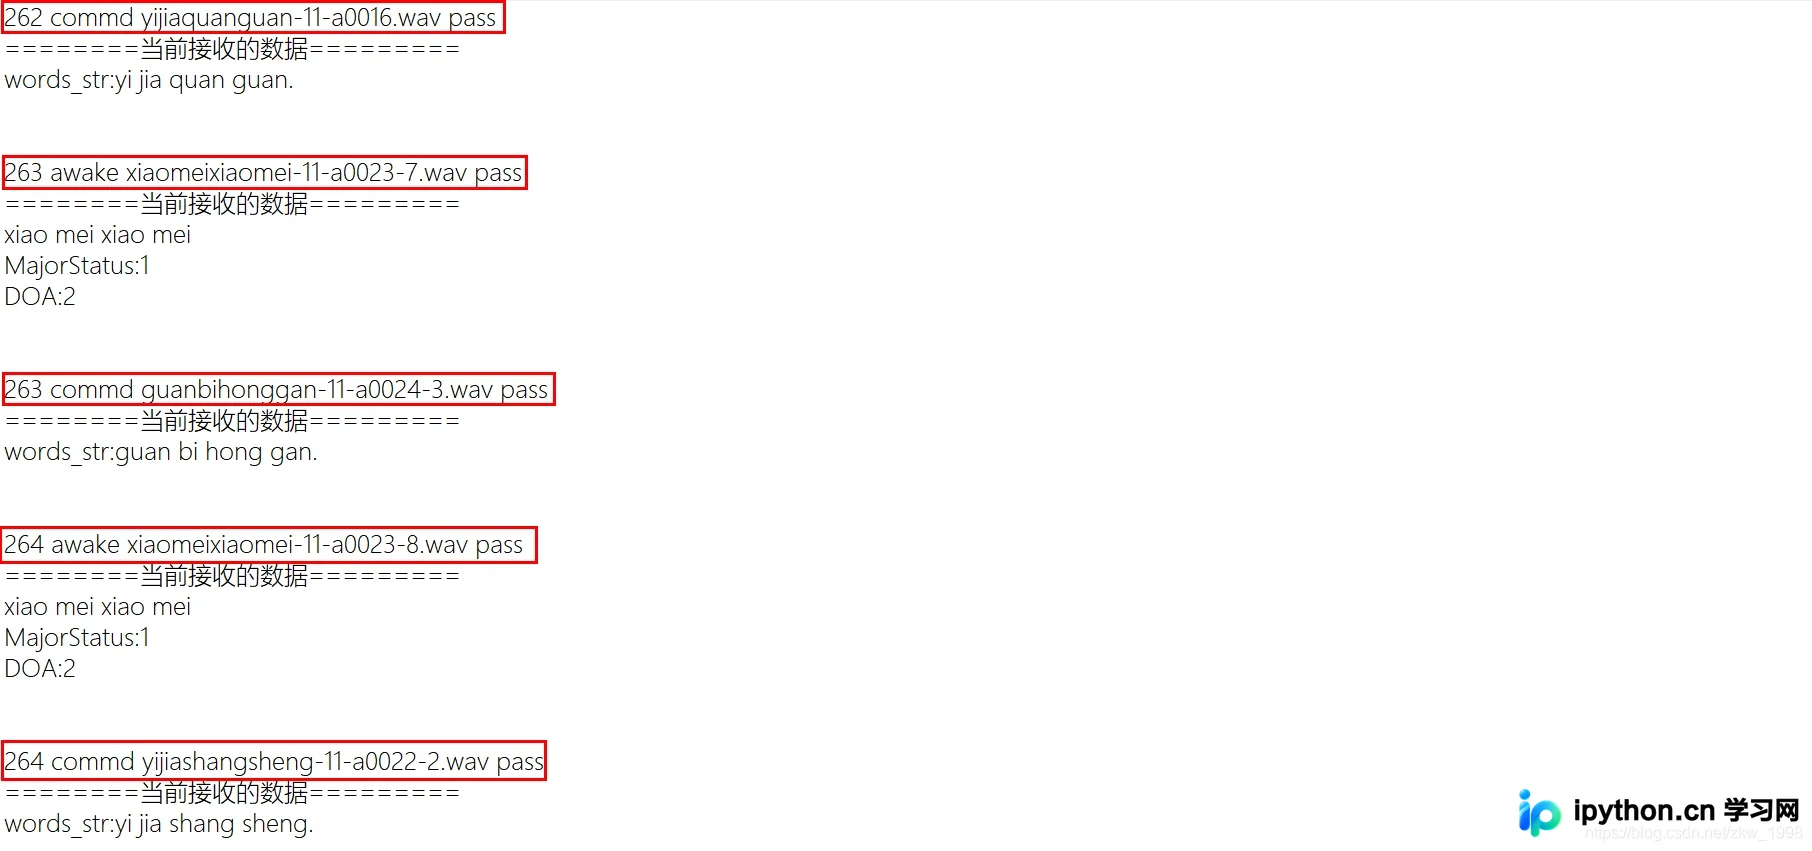
本文通过Python代码示例,演示如何利用正则表达式提取包含特定关键词(如pass)的文本行,并进一步展示如何清洗数据,去除行号、特定前缀及文件扩展名。同时补充了\d、\w、\s等常用正则元字符的匹配规则,适用于日志分析与文本清洗场景。
本文介绍如何在Python中利用正则表达式从TXT文件中提取包含换行符的特定字符串。通过分步策略,先截取目标区域前缀,再精准定位两个换行符之间的内容,结合[\s\S]模式实现跨行匹配,最终获取所需文本。
本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
本文解析Django中通过正则表达式配置URL匹配的方法,对比传统动态URL与静态URL在SEO上的差异。详细演示如何利用re_path实现顺序传参(*args)与关键字传参(**kwargs),并说明后者在参数位置变换时的稳定性优势,帮助开发者优化路由配置。
本文详细解析使用Python爬取豆瓣电影Top250数据的完整流程。通过结合urllib获取网页、BeautifulSoup解析DOM以及正则表达式提取关键信息,实现了电影链接、标题、评分等数据的自动化采集,并将结果保存至Excel文件。
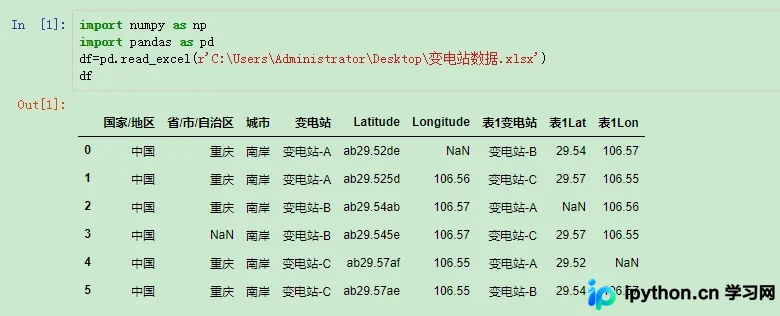
本文详细解析Pandas中replace()函数的多种用法,涵盖全表替换、指定列替换、字典与列表形式替换以及正则表达式匹配。重点讲解inplace参数的影响及str.replace在部分字符替换中的应用,帮助开发者高效完成数据清洗任务。
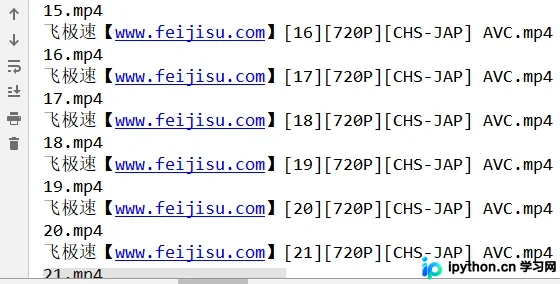
本文介绍如何利用Python批量修改动漫视频文件名。通过导入os和re模块,结合正则表达式提取文件名中的集数信息,实现自动重命名。主要涉及os.listdir获取文件列表、os.chdir切换目录、os.path.abspath获取绝对路径以及os.rename执行重命名操作,适用于需要整理大量文件命名的场景。