

Python爬虫利用cookie实现模拟登录实例详解
本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
2026-10-13
6

本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
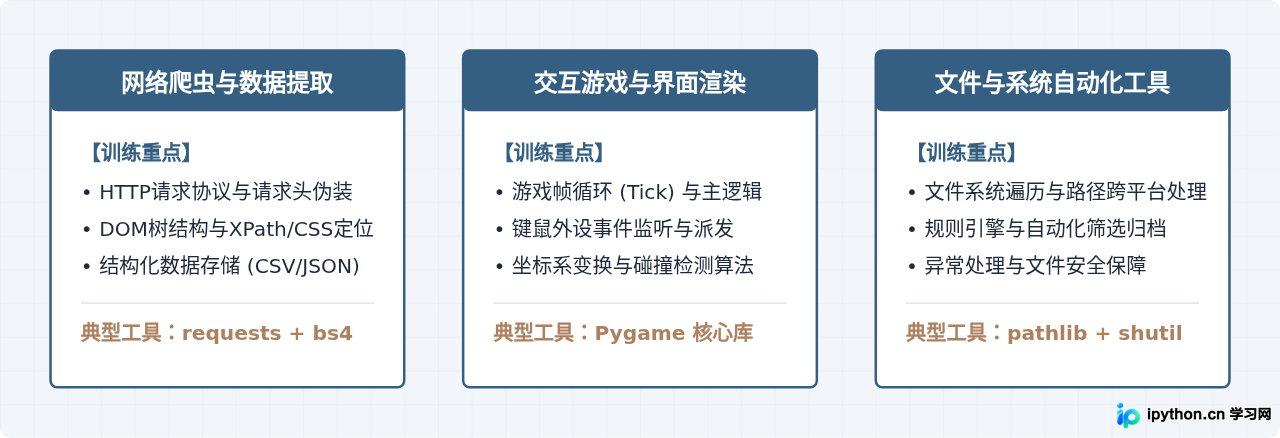
精选爬虫、游戏与自动化三大方向的Python入门练手项目源码,包含完整的实现逻辑、代码注释、运行验证与踩坑说明,帮助读者快速掌握实际开发技能。
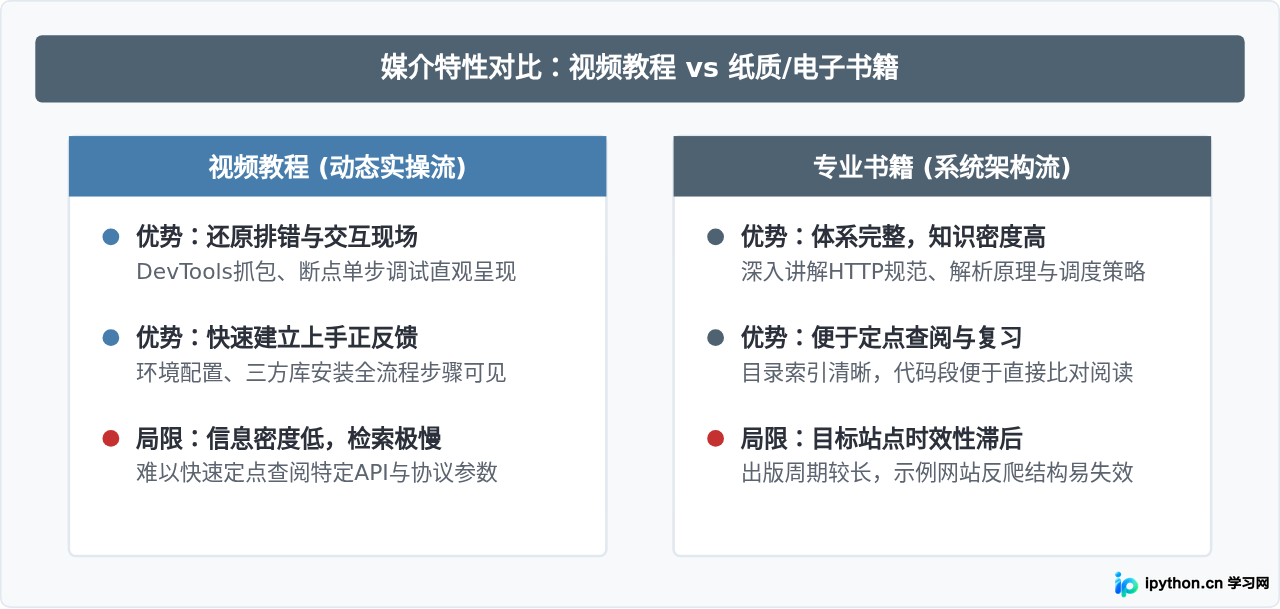
针对自学Python爬虫时买书与看视频的优劣势对比,提供阶段性搭配策略、筛选标准与避坑指南,帮助初学者高效选择适合自己的学习资料。
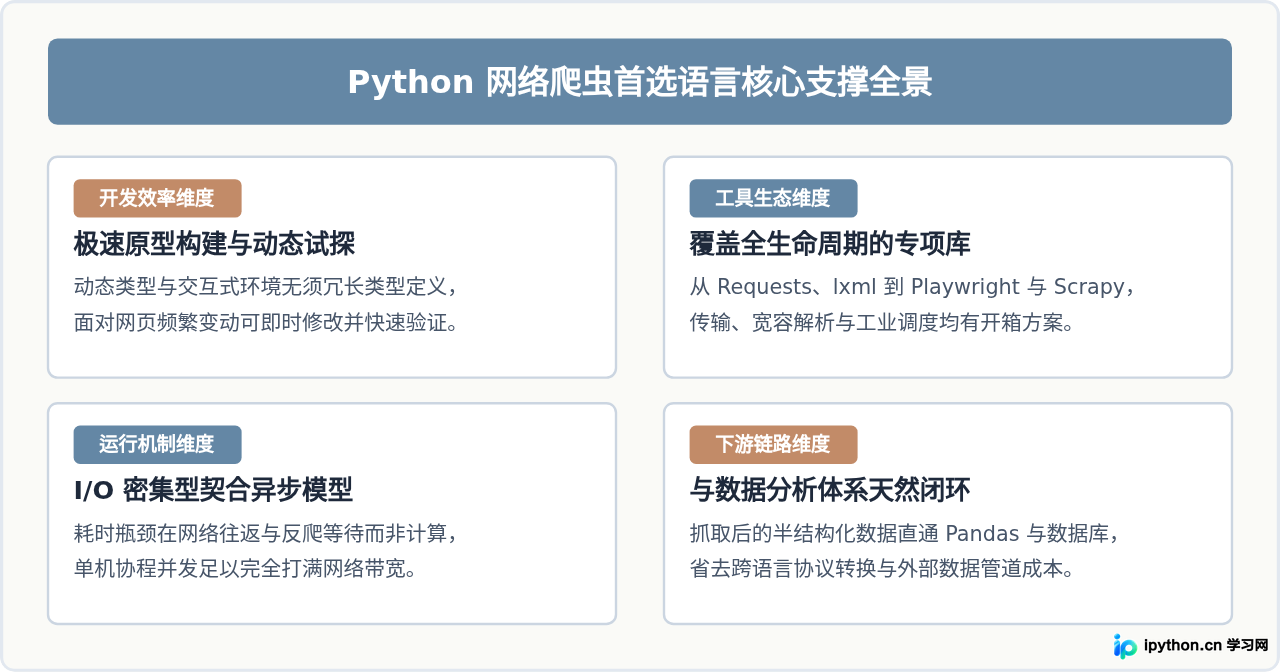
深入解析为什么Python成为网络爬虫开发的首选语言,从原型开发敏捷度、全流程专项工具生态、I/O密集型任务特性及下游数据协同等维度展开系统剖析,并提供技术选型指南。
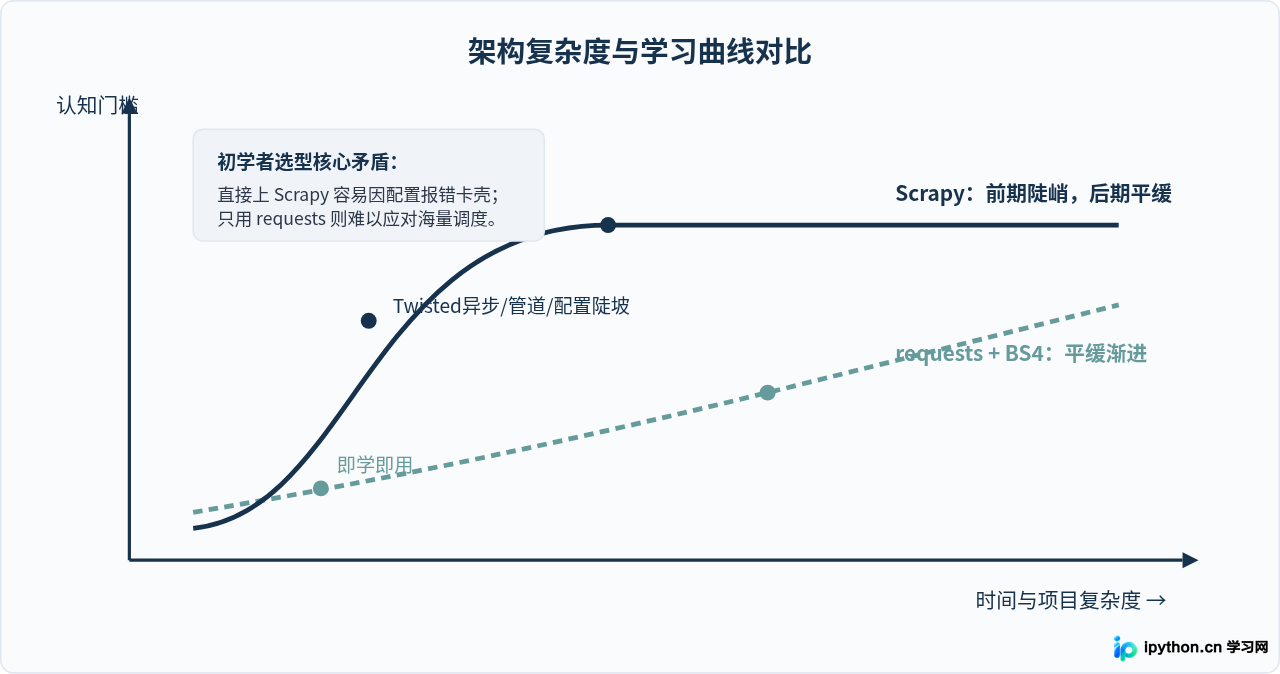
针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
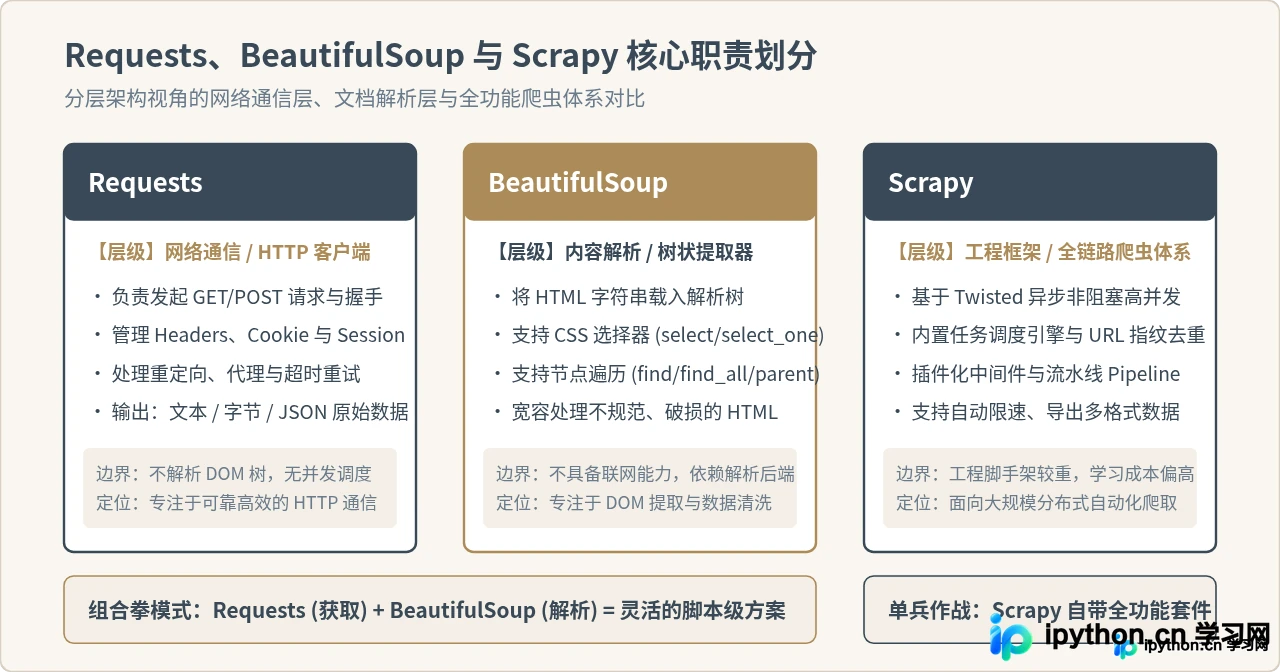
深入对比 Python 爬虫三大主流工具 Requests、BeautifulSoup 与 Scrapy 的定位差异、工作原理与适用场景,提供选型决策树与实践代码。
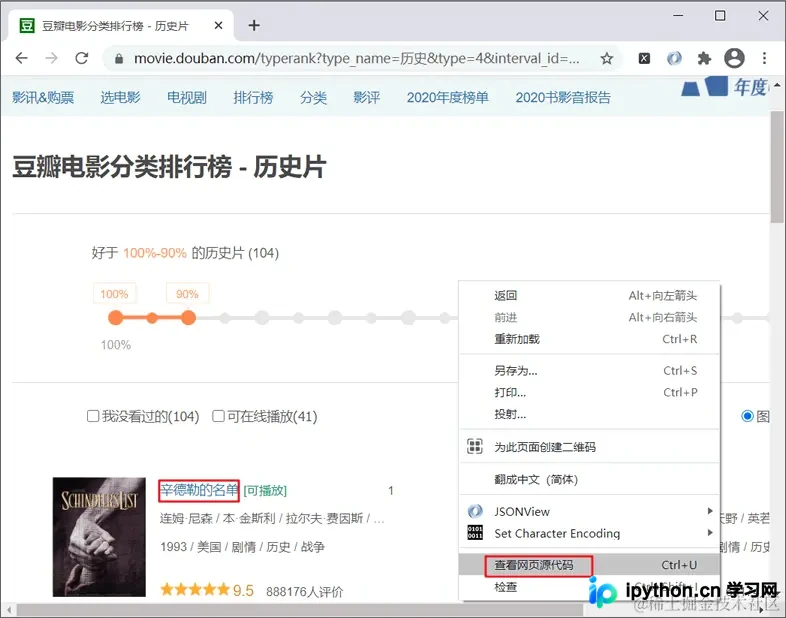
本文详解如何利用Python爬虫抓取豆瓣电影网站的动态加载数据。通过浏览器开发者工具分析网络请求,识别Ajax异步加载机制,提取关键查询参数与接口地址。文章提供了完整的代码实现,包括类型映射、分页抓取及数据保存逻辑,帮助开发者掌握动态网页数据抓取的核心技巧。
本文介绍如何利用Python脚本自动抓取MeterSphere平台的场景执行报告数据。通过遍历场景ID调用API接口,结合正则表达式过滤特殊字符与提取关键字段(如投保单号、报价单号、断言结果),最终将解析出的成功状态与详细报文按规则写入Excel报表,实现测试报告的自动化汇总与归档。
针对网站频繁访问同一IP导致封禁的问题,本文详细说明如何通过requests库构建代理池、在HTTP请求中切换IP,并结合随机User-Agent、控制请求间隔与完善异常重试机制,有效提升Python数据采集任务的稳定性与存活率。
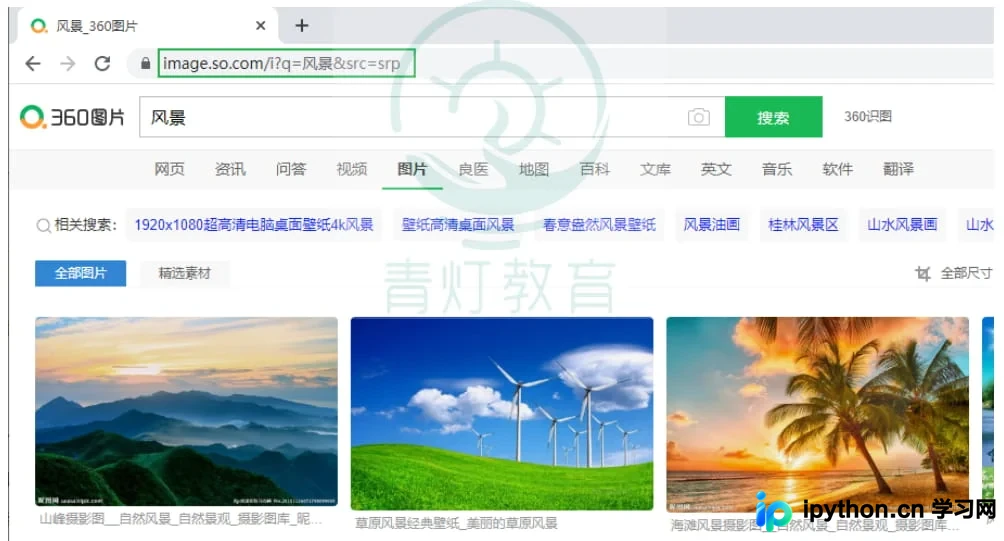
在使用 Python requests 模块进行网页抓取时,准确处理 URL 地址中的参数是成功获取数据的关键。本文将详细拆解查询参数与请求参数的区别,并演示如何使用 params 和 data 关键字自动完成数据的拼接与编码,避免手动字符串拼接导致的字符集错误。
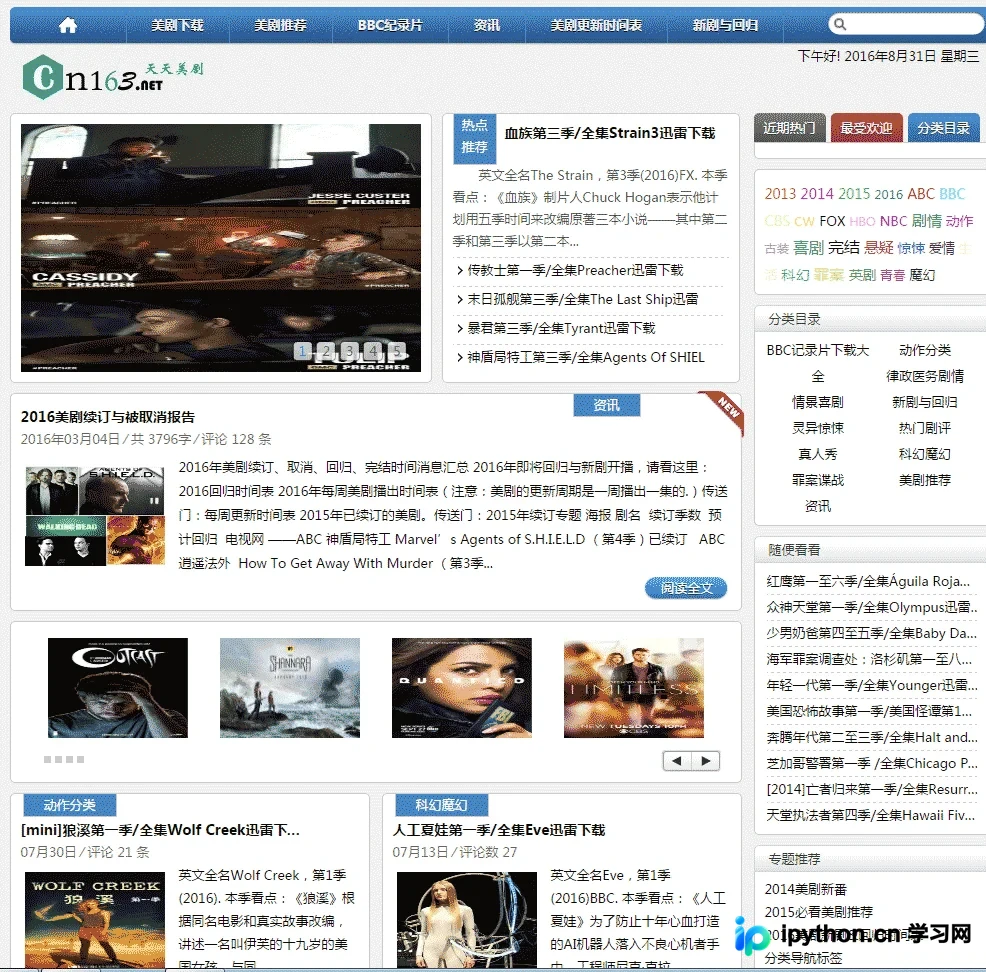
本文介绍如何使用Python编写爬虫程序,自动抓取美剧网站上的所有剧集下载链接。通过遍历URL编号、利用status_code过滤无效页面,并结合正则表达式提取ed2k链接,最终将结果按剧名保存为txt文件。文章还探讨了文件命名中的特殊字符处理及多线程在Python GIL限制下的实际效果。
本文演示如何使用现代Python工具编写网页爬虫,以豆瓣电影Top100为例,讲解构建URL地址池、伪造请求头、利用BeautifulSoup稳定解析HTML结构,并将提取到的电影名称与相关图片安全保存至本地。全文已修复原代码的版本缺陷,提供更可靠的执行逻辑与反爬规避建议。