Python爬虫中自动创建文件夹的实现方法
本文介绍在Python爬虫开发中如何自动创建目标文件夹。通过os.path.exists判断路径存在性,若不存在则使用os.makedirs创建多级目录。同时补充了Python中处理文件名、后缀、目录分割及遍历重命名等常用文件操作技巧,帮助开发者更高效地管理爬虫数据存储。
2026-10-13
6

本文介绍在Python爬虫开发中如何自动创建目标文件夹。通过os.path.exists判断路径存在性,若不存在则使用os.makedirs创建多级目录。同时补充了Python中处理文件名、后缀、目录分割及遍历重命名等常用文件操作技巧,帮助开发者更高效地管理爬虫数据存储。
本文介绍使用Python标准库urllib实现网页图片抓取的完整流程。通过构造请求头、解析HTML获取图片链接并保存至本地文件夹,演示了基础爬虫逻辑。针对目标网站已启用反爬算法导致无法获取有效图片的情况,文章记录了这一现象及尝试调整格式后的结果,仅供Python初学者参考学习。
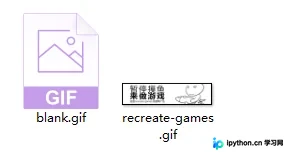
本文详细解析使用Python爬虫登录GitHub的技术流程。通过分析登录页面,提取CSRF Token与初始Cookie,利用Requests库发送GET请求获取必要参数,随后构造POST请求提交用户名和密码完成身份验证。最后演示如何携带登录后的Cookie访问个人详情页,实现自动化信息查看。
本文介绍使用Python编写爬虫程序调用有道翻译接口的完整示例。通过构造HTTP请求、设置请求头及参数,实现文本翻译功能。代码包含用户交互循环及JSON结果解析,适用于学习网络请求与数据处理的基础场景。
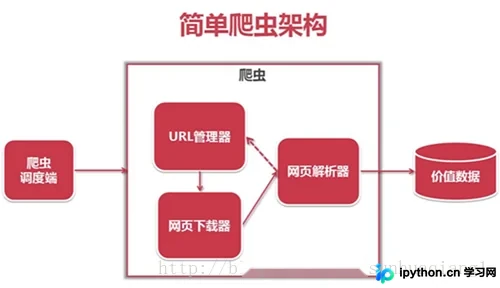
本文深入解析Python爬虫的核心架构,详细阐述URL管理器、HTML下载器及HTML解析器的功能与实现。通过完整代码示例,展示如何构建爬虫调度程序,实现网页数据的抓取、解析与输出。适合希望掌握Python爬虫基础原理与实战开发的开发者参考。
本文详解Python爬虫中BeautifulSoup的异常处理机制,涵盖HTTPError捕获404/500错误、空网页判断及AttributeError处理缺失标签。通过完整代码示例,展示如何编写健壮的爬虫程序,避免程序崩溃,提升代码健壮性。
本文介绍了一个基于Python的小型爬虫系统实现,涵盖URL管理、HTML下载、解析及输出模块。通过正则表达式提取链接,利用BeautifulSoup解析文本内容,并支持将抓取结果保存为HTML表格或TXT文件。代码展示了从初始URL到批量文档下载的全流程,适合Python初学者理解爬虫架构与核心逻辑。
本文详细讲解Python爬虫的核心流程,涵盖数据下载、解析与保存三大环节。通过对比urllib、Requests及Selenium等工具,结合淘宝图片抓取实例,演示如何利用正则表达式提取数据,并处理反爬策略与动态网页加载问题,为初学者提供实用的技术参考。
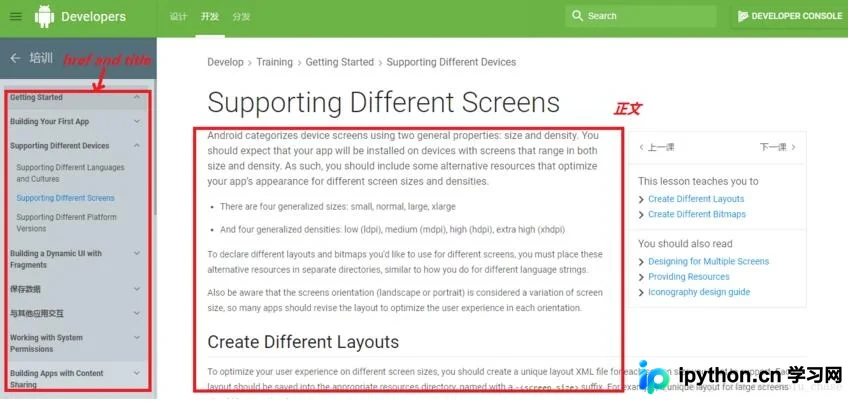
本文介绍如何利用Python编写爬虫程序,从指定网页提取标题、正文及导航链接,并通过BeautifulSoup解析HTML。结合Requests库获取内容,使用wkhtmltopdf工具将生成的HTML文件转换为PDF格式,实现离线阅读与记忆。
本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
本文介绍Python爬虫在请求包含中文或特殊符号的URL时常见报错问题,通过urllib.parse.quote函数进行安全编码处理,保留可打印字符,解决请求失败问题。
本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。