

解决Python网页爬虫之中文乱码问题

发布时间:2026-10-13| 6人浏览过
本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。
Python作为开发工具功能强大,但也存在固有局限。在近期进行网页爬虫开发时,我遇到了一个典型问题:从中文网站抓取的内容常出现乱码。此前在爬取学校网页时也曾遭遇此状况,当时未获解决,一直悬而未决。如今问题已攻克,特此分享解决方法,供各位参考交流。
Python中文乱码的成因在于:Python解析网页时默认采用Unicode编码,而多数网站数据为UTF-8格式。解析后,Python再次以Unicode格式输出,若与系统编码格式不一致,便会导致中文显示乱码。明确这一原因后,解决思路便清晰了。以下提供具体代码实现,测试对象仍为经典的百度首页。
# -*- coding: utf-8 -*-

import urllib2
import re
import requests
import sys

import urllib
#设置编码
reload(sys)
sys.setdefaultencoding('utf-8')
#获得系统编码格式
type = sys.getfilesystemencoding()
r = urllib.urlopen("http://www.baidu.com")
#将网页以utf-8格式解析然后转换为系统默认格式
a = r.read().decode('utf-8').encode(type)
print a
最终运行结果中,中文内容显示正常,乱码问题得以彻底解决。
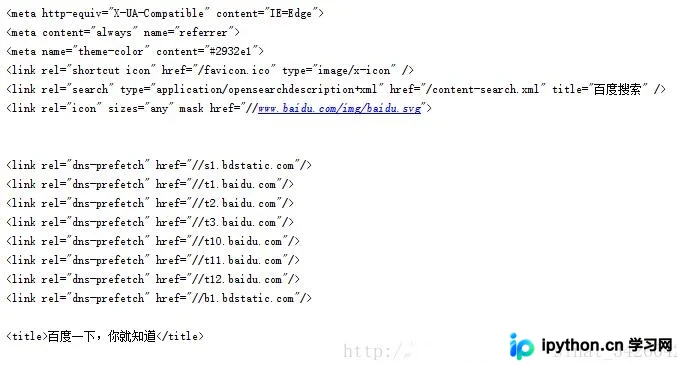
以上关于解决Python网页爬虫中文乱码问题的分享到此结束,希望能为各位提供有益参考。欢迎继续支持本站,获取更多技术内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









