

Python爬虫实战:批量抓取豆瓣电影Top250并导出Excel
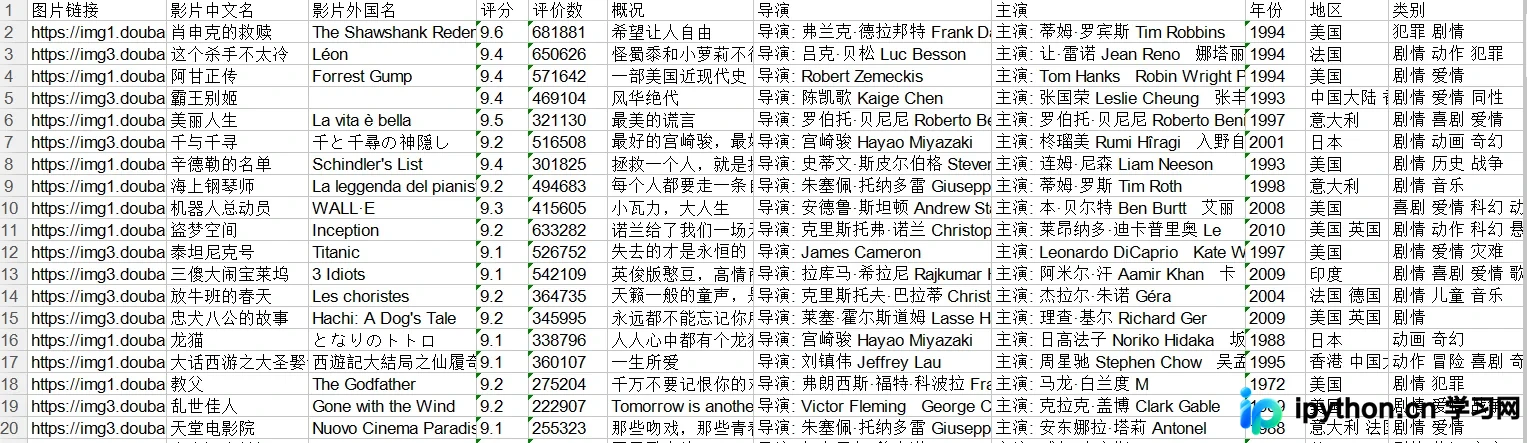
本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。
2026-10-13
6

本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。
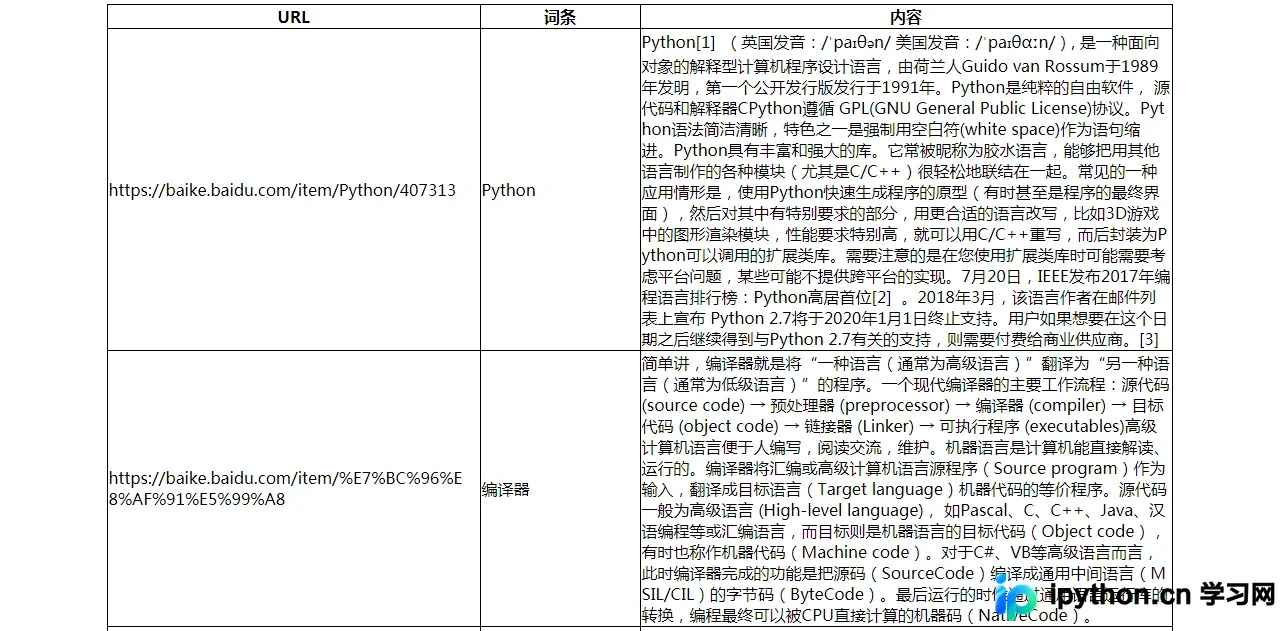
本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
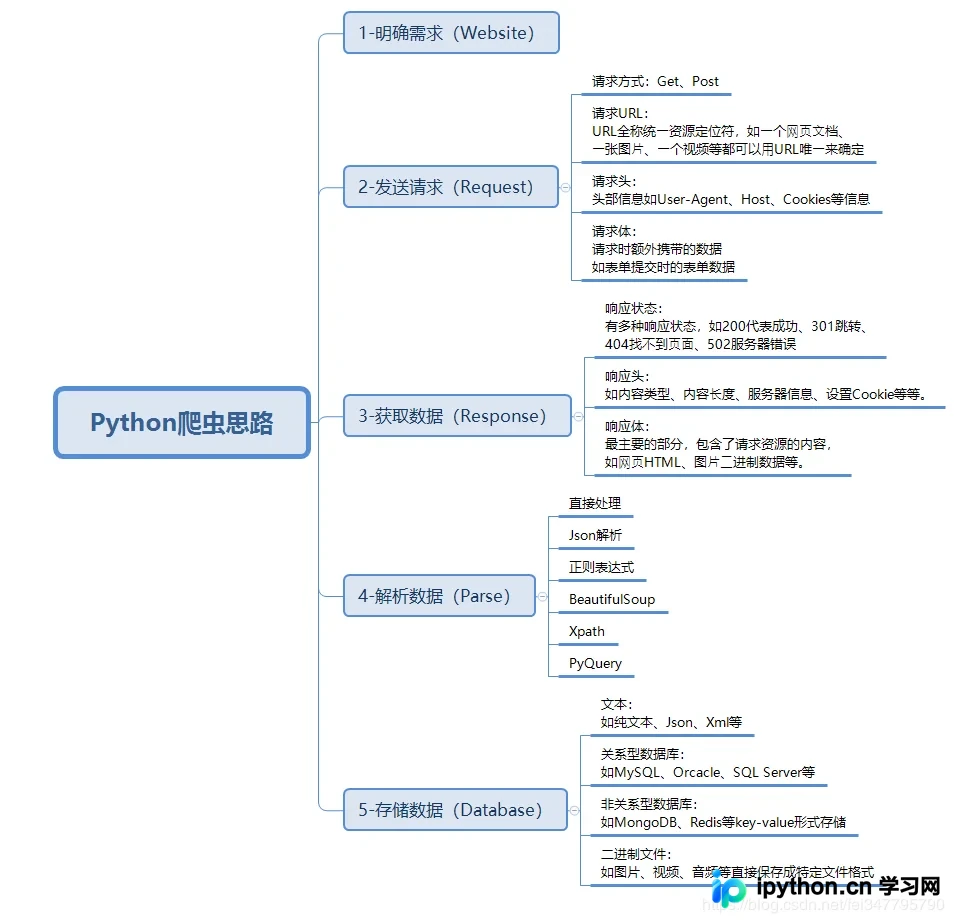
本文系统介绍Python爬虫的基本概念、应用场景及合法性边界。详细解析常见的反爬虫手段,如IP限制与数据投毒,并梳理Python在爬虫开发中的核心优势。重点列举了请求处理、多线程、正则解析、JSON处理及DOM解析等关键模块,为开发者提供清晰的技术选型参考。
本文介绍Python中fake-useragent库的安装与使用方法,展示如何随机生成各类浏览器UserAgent以辅助爬虫开发。重点解析缓存异常FakeUserAgentError的解决方案,包括禁用服务器缓存及添加本地数据文件的高级配置,帮助开发者规避网络请求失败问题。
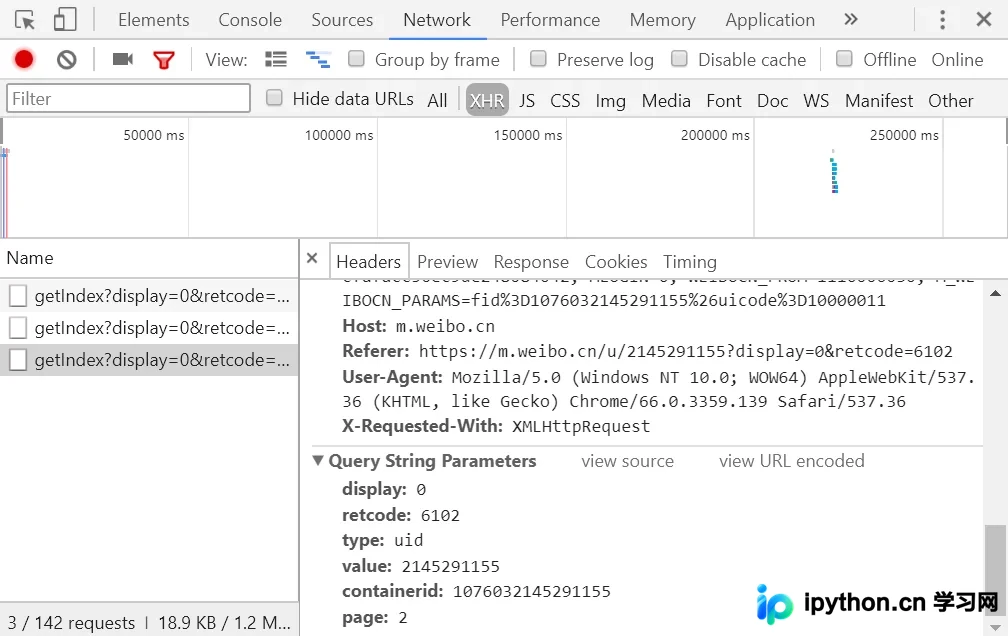
本文通过Python代码演示如何抓取马云的微博内容。首先利用浏览器开发者工具分析Ajax请求,识别GET请求中的关键参数及分页机制。接着解析返回的JSON数据,提取cardlistInfo中的总数量及cards中的微博正文、点赞、评论和转发数。最后结合Requests与PyQuery库,实现批量获取并保存微博信息至本地文件。
本文详细解析利用Python爬虫技能实现经济收益的两种主要路径。针对在校大学生,建议从少量数据抓取入手,掌握基础库、HTML解析及存储技术,避免承接高风险监控或大规模项目。对于在职IT人员,凭借丰富的工程经验与流程熟悉度,可挑战大规模抓取、监控及移动端模拟登录等高收益任务。文章提供了针对性的技术建议与项目选择策略,帮助不同阶段的技术人员合理评估难度与收益。
本文通过Python爬虫实战,展示如何从简单的5行代码逐步完善,最终实现爬取3000多家上市公司信息。文章涵盖环境配置、异常处理、灵活性优化及多进程加速等技巧,帮助初学者快速掌握爬虫开发流程。
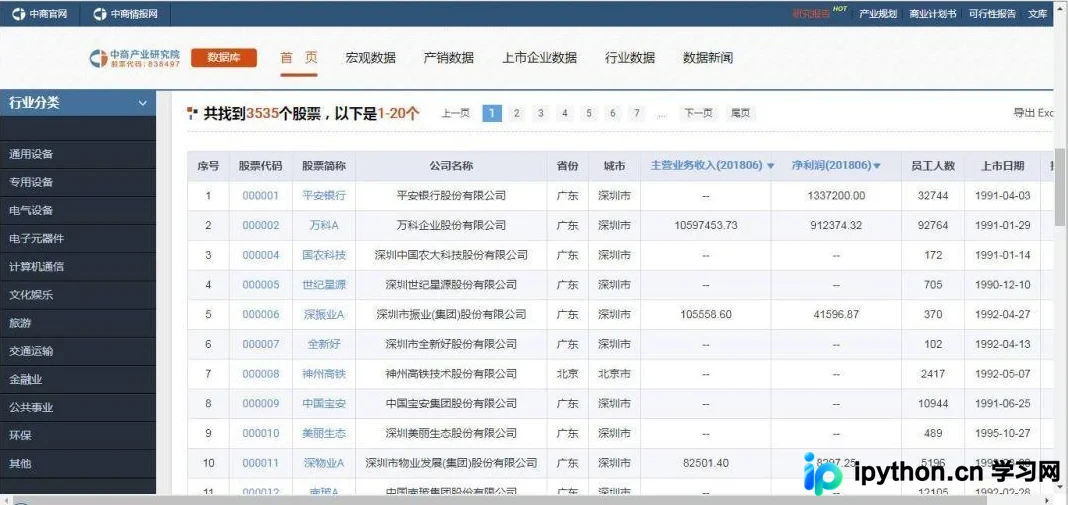
本文介绍如何使用Python爬虫结合百度地图API,通过小区名称获取经纬度,再反向解析为结构化地址。代码支持传入DataFrame批量处理,并优化了含“号”的小区名称精度,提高数据获取效率。
本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。
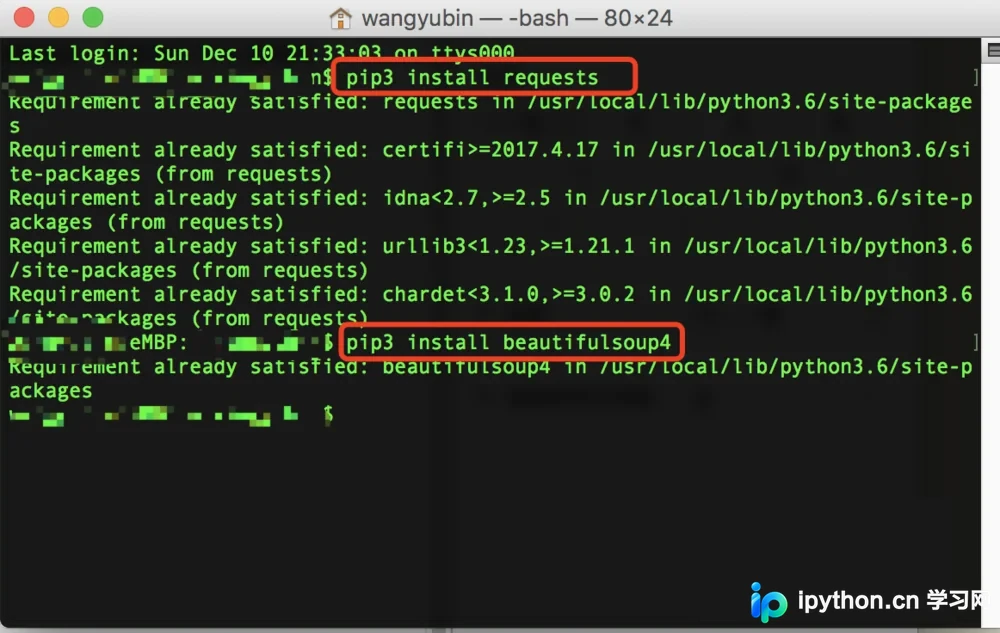
本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
本文详细介绍Python爬虫中处理非200状态URL的重试机制。提供Python 2.7与3.5版本的同步requests实现及异步aiohttp方案,并封装可复用的重试装饰器。代码涵盖错误捕获、递归重试逻辑及异常处理,适用于需要提高爬虫稳定性的场景。
本文分享一段Python爬取链家租房信息的完整代码,涵盖从网页请求、数据解析到数据库存储的全流程。通过封装获取列表页链接与详情页信息的函数,结合SQL Server数据库操作,实现自动化数据采集。代码包含关键逻辑说明及错误处理思路,适合Python初学者参考学习。