Python爬取智联招聘数据分析师岗位信息实战
本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
2026-10-13
6

本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。
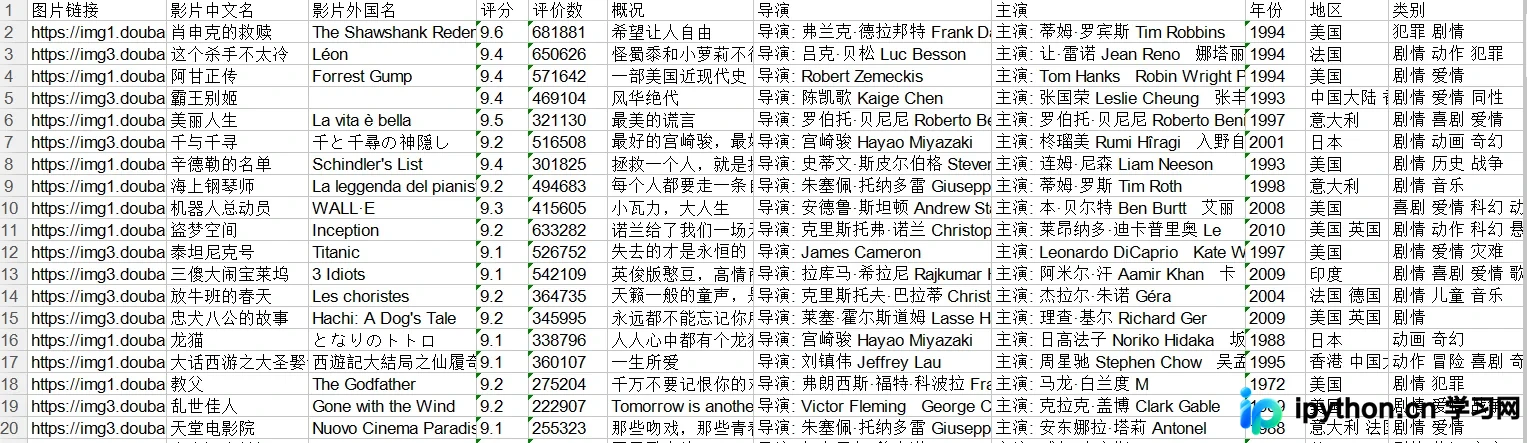
本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。
本文深入讲解Python爬虫中requests库的高级应用。通过GET与POST请求实例,演示如何构造Headers与Params;结合拉钩网案例解析数据抓取逻辑;详细介绍代理IP配置方法以规避封禁;最后通过人人网登录示例,阐述利用Session对象保持会话状态及Cookie管理的完整流程。
本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
本文详细介绍使用Python采集猫眼电影《无名之辈》近两万条用户评论的全过程。通过移动端接口获取数据,利用jieba进行分词,结合pyecharts和matplotlib制作观众城市分布热点图、TOP20来源柱状图及评论词云。文中还包含对pyecharts源码的修改以解决城市简称匹配问题,提供完整代码供学习参考。
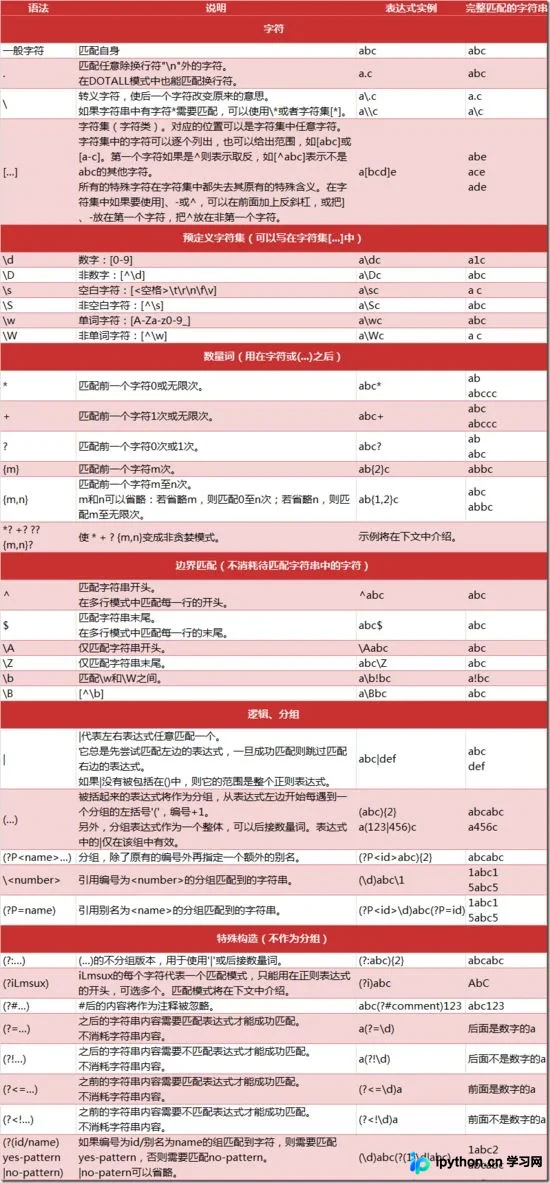
本文详解Python中re模块的核心用法,涵盖match与search的区别、贪婪与非贪婪匹配、分组提取及编译优化。通过HTML解析、字符串替换等实例,演示如何高效利用正则表达式进行数据抓取与处理,助力爬虫开发。
本文详解如何在Python爬虫中利用单例模式高效获取高匿IP代理。针对网站反爬机制,通过复用代理对象避免频繁请求被封禁,结合User-Agent随机切换提升成功率。文章提供基于快代理的完整代码实现,涵盖Python 3.6环境下的代理获取、解析及单例类设计,助开发者稳定运行爬虫任务。
本文介绍使用Python编写爬虫程序调用有道翻译接口的完整示例。通过构造HTTP请求、设置请求头及参数,实现文本翻译功能。代码包含用户交互循环及JSON结果解析,适用于学习网络请求与数据处理的基础场景。
本文介绍Python爬虫在请求包含中文或特殊符号的URL时常见报错问题,通过urllib.parse.quote函数进行安全编码处理,保留可打印字符,解决请求失败问题。
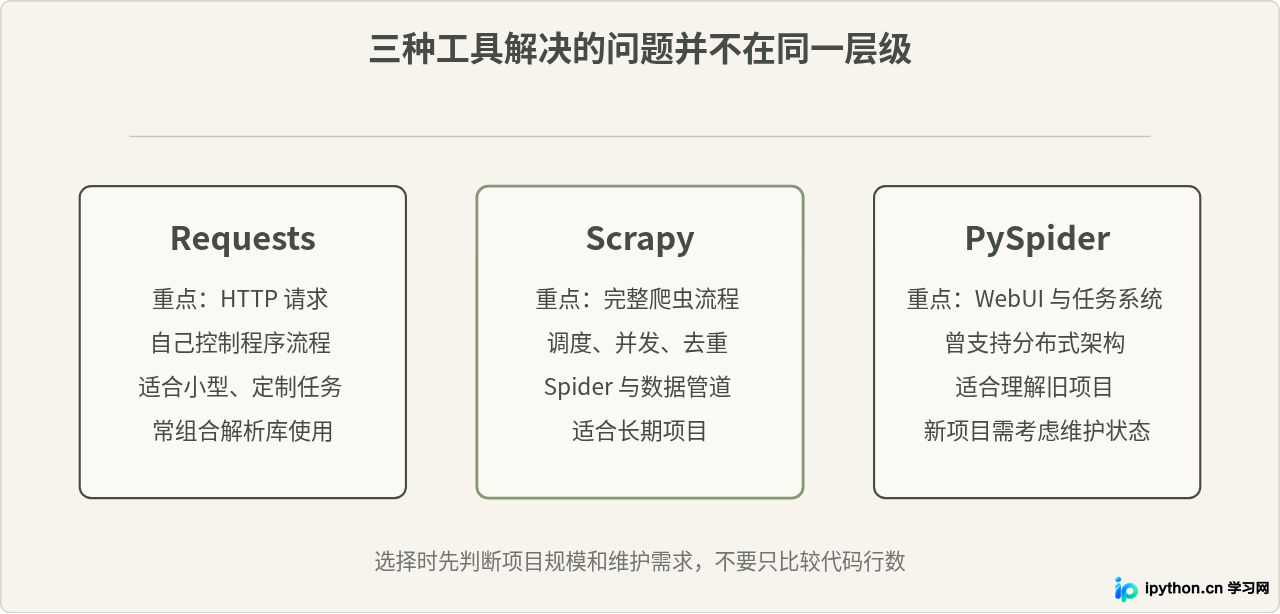
对比Python爬虫常见的Requests、Scrapy与PySpider,从学习成本、并发抓取、任务调度、数据处理、项目维护和适用场景等方面说明区别,并给出不同爬虫项目的选择方法。