

Python爬虫开发与项目实战:从静态抓取到分布式架构

发布时间:2026-10-11| 1人浏览过
本书系统讲解Python网络爬虫开发,从基础原理到Scrapy框架应用,深入解析动态网页抓取与JS加密分析。涵盖单机爬虫至分布式架构设计,通过9个实战项目演示反爬突破与数据去重方案,适合希望掌握大规模数据采集技术的开发者。
网络爬虫的核心价值与演进
在大数据时代,互联网信息呈现爆炸式增长,传统搜索引擎在特定领域或实时数据获取上存在局限性。网络爬虫作为自动化数据采集工具应运而生,成为获取非结构化数据的关键手段。本书从爬虫的基本原理出发,结合Python编程语言与Web前端基础知识,帮助读者建立完整的知识体系。
技术栈与核心框架
爬虫开发涉及多个技术环节,本书按照由浅入深的逻辑进行编排:
- 基础入门:从Python语法与Web前端基础讲起,确保读者具备必要的编程与网页解析能力。
- 核心框架:重点介绍Scrapy爬虫框架,掌握其组件结构与异步处理机制。
- 动态解析:针对JavaScript渲染的动态网页,讲解动态爬虫原理及JS加密分析方法。
- 高级架构:探讨大规模数据场景下的分布式爬虫设计,并介绍PySpider等分布式框架。
实战项目与难点突破
理论结合实践是本书的核心特点。全书包含9个完整的爬虫项目,覆盖从静态网站到动态网站、从单机处理到分布式部署的全流程。重点解决以下关键技术难点:
- 反爬虫突破:详细讲解如何应对IP限制、验证码识别及行为检测等反爬措施。
- 数据去重:设计高效的数据去重方案,避免重复抓取与存储冗余。
- 加密分析:对前端JS加密逻辑进行逆向分析与模拟。
- 分布式开发:实现多节点协同工作,提升数据采集效率。
通过系统化的实战驱动,读者能够逐步掌握爬虫开发所需的核心技能与工程化思维。
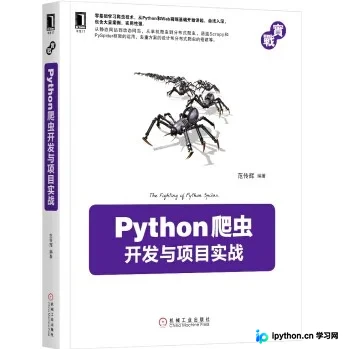
以上就是Python爬虫开发与项目实战的详细内容,更多关于Python爬虫、Scrapy框架及分布式爬虫的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









