50行Python代码实现高考志愿信息抓取与Excel导出
本文介绍如何使用仅50行Python代码批量抓取高考志愿信息。通过结合requests-html解析网页与openpyxl处理Excel,实现从URL列表读取、网页内容提取到数据写入的全流程。文中详细讲解了处理非结构化HTML、正则表达式分割学校名称及表格切片等关键技术点,并提供了完整的错误处理与代码示例,帮助开发者快速完成数据自动化任务。
2026-10-13
5

本文介绍如何使用仅50行Python代码批量抓取高考志愿信息。通过结合requests-html解析网页与openpyxl处理Excel,实现从URL列表读取、网页内容提取到数据写入的全流程。文中详细讲解了处理非结构化HTML、正则表达式分割学校名称及表格切片等关键技术点,并提供了完整的错误处理与代码示例,帮助开发者快速完成数据自动化任务。
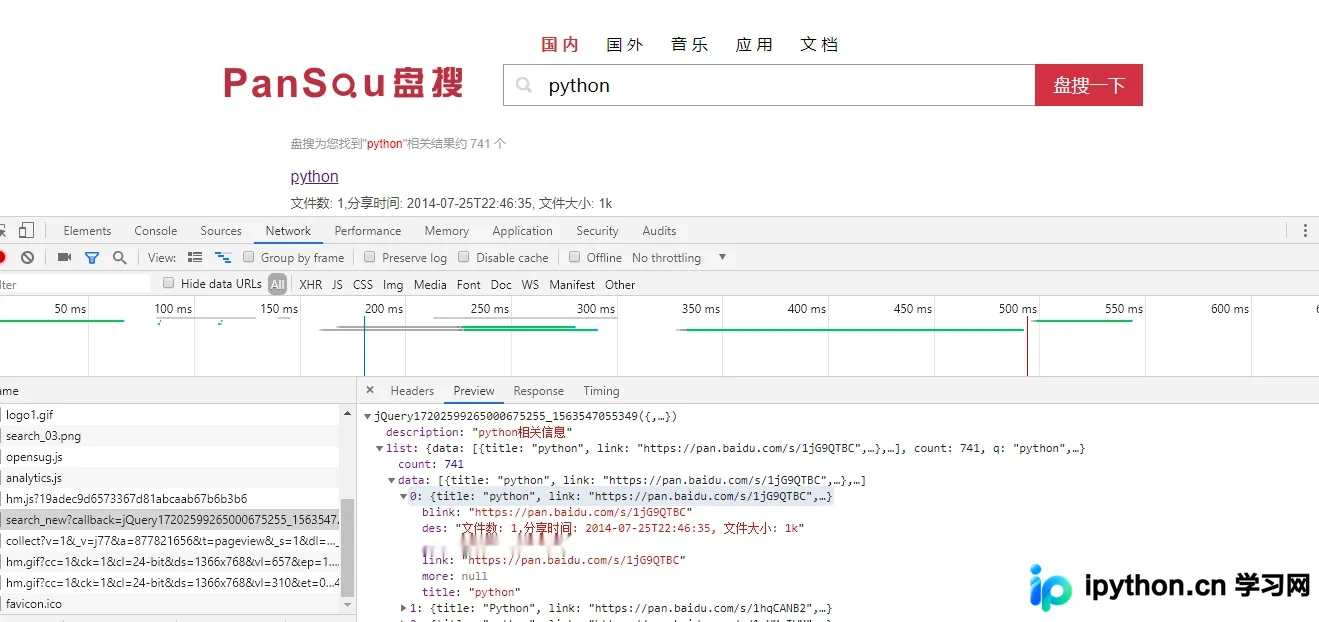
本文介绍如何使用Python编写爬虫,从盘搜网站筛选出有效的网盘链接。通过解析接口获取JSON数据,结合多线程技术提高爬取效率,并保存结果至CSV文件。代码包含详细的请求头设置、异常处理及文件写入逻辑,适合初学者练习网络爬虫开发。
本文介绍如何在Python3中使用requests库发送HTTPS请求时,通过关闭证书验证(verify=False)避免控制台输出InsecureRequestWarning警告。提供了针对Python2和Python3的具体代码解决方案,包括使用urllib3.disable_warnings()方法,帮助开发者清理控制台输出并简化调试过程。
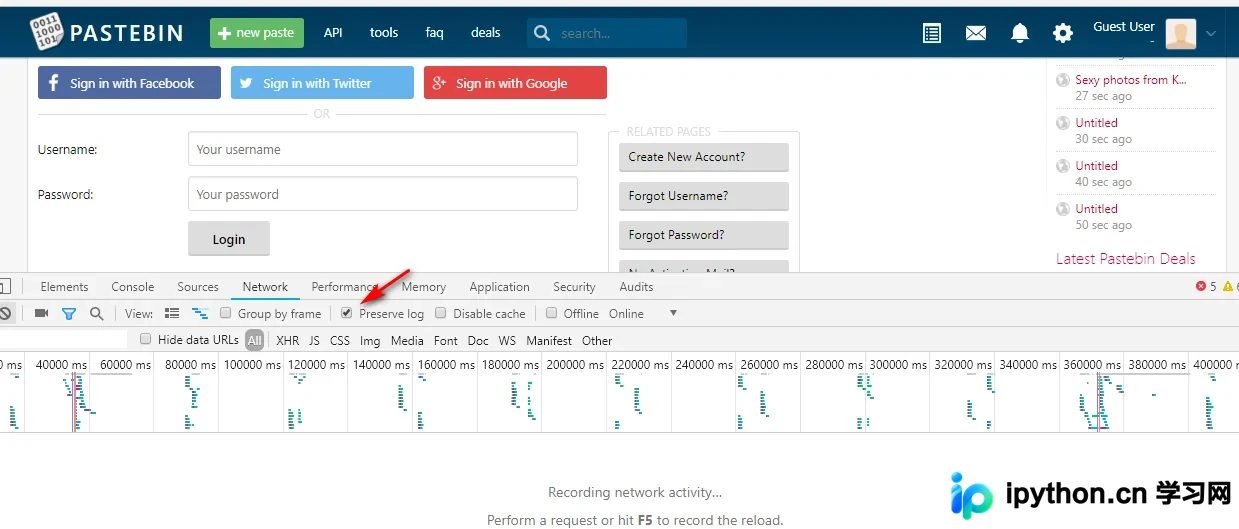
本文详细介绍如何使用Python脚本模拟登录Pastebin网站,并通过API自动创建Paste。教程涵盖通过Chrome开发者工具分析登录请求、处理表单数据提交、获取Session会话以及提取API密钥的关键步骤,提供完整的代码示例供开发者参考。
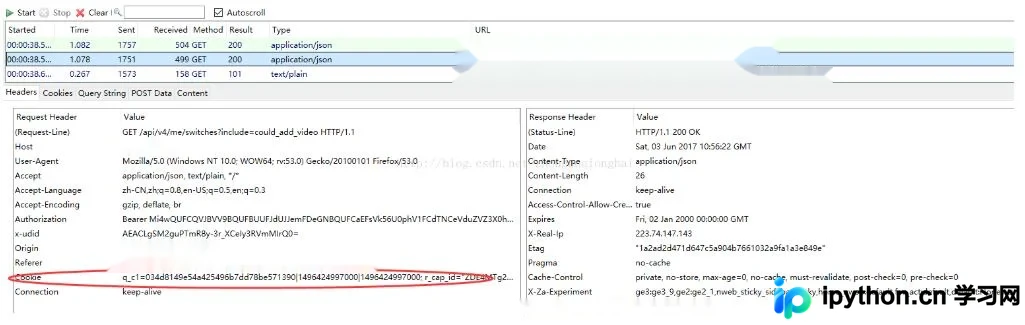
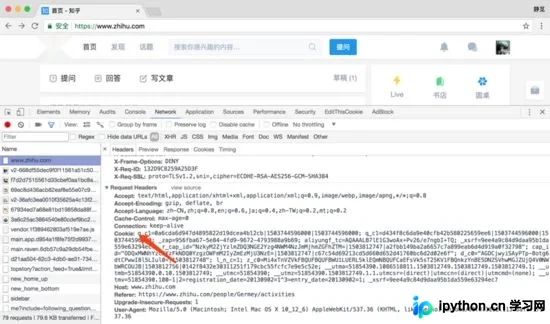
本文介绍了如何使用Python通过获取浏览器Cookie来模拟登录知乎。主要步骤包括使用Firefox和Httpfox插件获取GET请求的Cookie,将其正确格式化为Python代码中的字符串,并通过发送请求验证登录状态。该方法适用于需要模拟用户访问知乎的场景。
本文介绍了如何使用Python调用百度地图地理编码API,通过传入经纬度参数获取对应的地址信息。示例代码展示了构造请求参数、发起GET请求并解析JSON响应的方法,重点演示了如何提取城市名称。
本文详细介绍Python中requests库的安装方法及基本使用。作为比urllib更简洁的第三方HTTP库,requests支持GET、POST等多种请求方式。文章通过具体代码示例,演示了如何发起基础请求、处理带参数URL、解析JSON响应以及上传文件,帮助开发者快速掌握网络交互的核心技能。
本文深入解析Python3中requests库的高级功能,涵盖文件上传、Cookies管理与会话维持、SSL证书验证与忽略、代理设置(含SOCKS)、超时控制、身份认证及Prepared Request等核心用法。通过具体代码实例,帮助开发者掌握高效、稳定的网络请求技巧,适用于复杂爬虫场景。
本文详解如何利用Python的requests库爬取包含复杂参数的Post接口。针对部分网站要求同时传递Query字符串参数与空的JSON Body以触发反爬机制的特殊场景,提供了具体的代码实现方案。文章分析了请求头配置、参数序列化及raw格式提交的关键点,帮助开发者解决此类逆向工程难题。
本文深入解析Python中requests模块的核心用法,涵盖GET请求的参数传递、响应内容解析及请求头设置,以及POST请求的数据、JSON、文件上传和Cookie处理。通过具体代码示例,演示如何高效进行网络交互,并包含超时控制等关键配置,帮助开发者快速掌握HTTP请求处理技巧。
本文提供Python实现的百度贴吧图片爬取完整示例。代码涵盖贴吧名称、页码范围输入,利用urllib构造请求URL,通过lxml解析HTML获取图片链接,并使用requests下载图片保存至本地。示例包含完整的类定义与执行逻辑,供Python学习者参考。
本文详解使用Python3的Requests库和正则表达式爬取知乎热门话题的方法。重点解决作者匿名导致的数量偏差、标题与内容不匹配等问题,并通过正则处理HTML标签。最后演示如何将抓取到的标题、作者及内容完整保存至本地TXT文件,附带文件打开模式说明。