

Python获取网络图片的多种方法及实现详解
本文详细整理了Python中获取网络图片的几种常用方法,包括使用urllib库直接下载、通过Request添加请求头模拟浏览器访问,以及利用requests库进行流式或分块下载。此外,还展示了如何结合正则表达式从网页源码中提取图片链接并保存。文中提供了完整的示例代码,涵盖文件读写、目录创建及异常处理,适合需要批量获取或整理网络图片资源的开发者参考。
2026-10-13
6

本文详细整理了Python中获取网络图片的几种常用方法,包括使用urllib库直接下载、通过Request添加请求头模拟浏览器访问,以及利用requests库进行流式或分块下载。此外,还展示了如何结合正则表达式从网页源码中提取图片链接并保存。文中提供了完整的示例代码,涵盖文件读写、目录创建及异常处理,适合需要批量获取或整理网络图片资源的开发者参考。
本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。

本文详细介绍如何利用Python3的Requests库结合正则表达式,实现从百度图片批量抓取指定关键词图片的功能。教程涵盖通过开发者工具分析网络请求、提取目标URL、解析HTML源码以及编写下载脚本的完整流程,帮助初学者掌握基础的网络数据抓取技术。
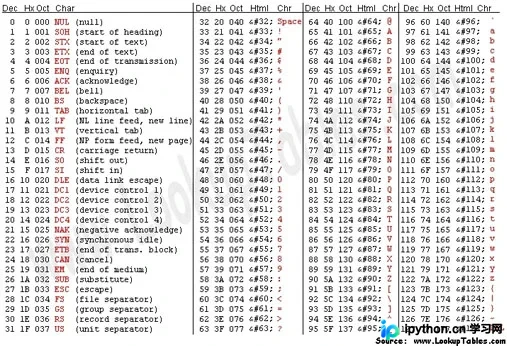
本文深入解析Python中json.dumps处理中文时的编码机制。重点讲解ensure_ascii参数对非ASCII字符转义的影响,结合requests库发送数据时的常见错误,剖析Unicode码点转换原理及源码实现逻辑,并提供服务器端识别转义字符串的正确解码方法。
本文介绍如何使用Python的BeautifulSoup4和Requests库爬取酷狗音乐。核心难点在于解析接口返回的Hash值以获取真实播放链接。代码通过正则表达式提取Hash和文件名,构造播放接口URL并解析JSON数据,最终将音频内容保存为MP3文件至本地目录。
本文介绍如何使用Python获取图片的物理尺寸(即文件大小),而非图像分辨率。通过示例代码展示如何下载图片并计算其字节、KB及MB大小,明确物理尺寸与宽高的区别,帮助开发者准确处理文件存储与传输场景。
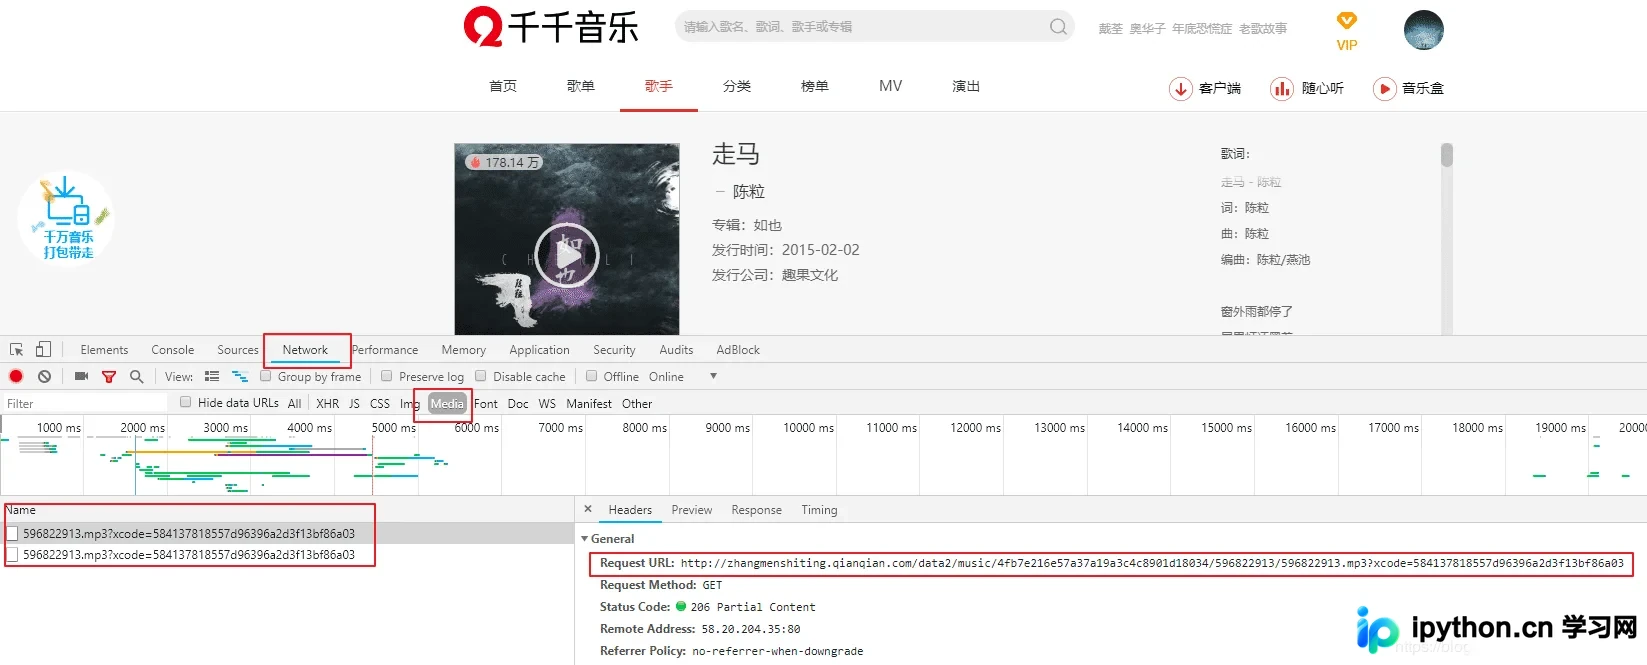
本文详细介绍如何利用Python批量下载在线音乐。通过requests库发送请求,结合正则表达式提取歌曲ID与真实播放链接,解析隐藏的API接口数据。文章涵盖环境配置、网页分析、URL拼接及完整代码实现,帮助开发者掌握从获取数据到保存文件的全流程操作。
本文详解如何利用Python的requests库获取网页数据,结合BeautifulSoup解析HTML结构,提取One推送的文字与图片链接。通过封装下载函数并遍历DOM节点,实现自动化获取每日图文内容并保存至本地,为Python网络爬虫初学者提供完整代码示例与操作参考。
本文介绍使用 Python 编写爬虫脚本以自动增加博客访问量的方法。通过 requests、lxml 和 fake_useragent 等模块,模拟浏览器行为获取文章列表并逐页访问。代码包含详细注释,旨在供学习参考,实际使用需注意反爬机制及平台规则。
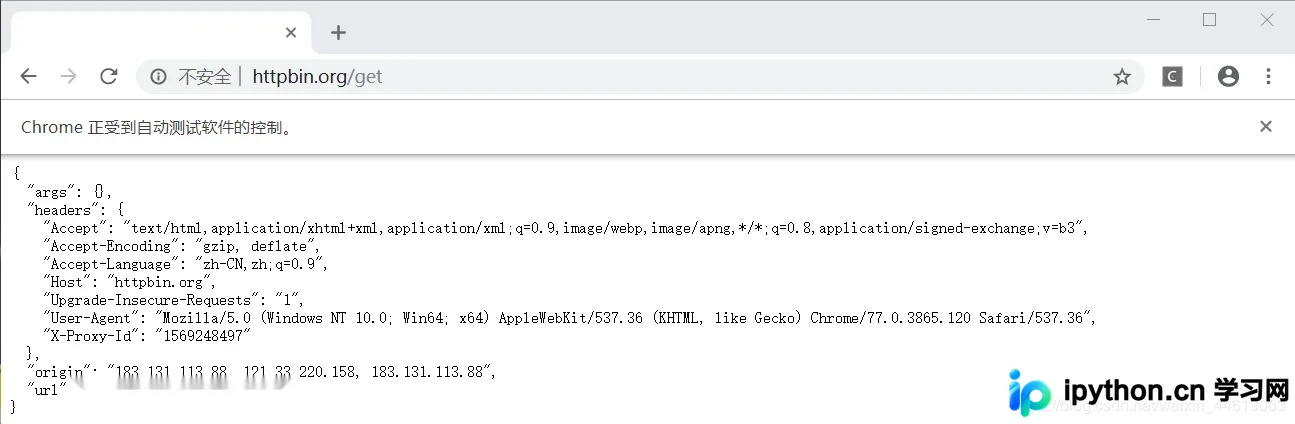
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
本文介绍如何使用Python构建代理IP池的第一步:获取IP。通过结合Requests和PyQuery库,利用自定义的ProxyMetaclass元类自动识别以crawl开头的方法,实现从多个免费代理网站批量抓取IP和端口。代码采用生成器模式返回数据,便于后续存储与检测,为反爬策略提供灵活的IP轮换方案。
本文详解如何利用Python的browsercookie模块自动从Chrome、Firefox等主流浏览器中提取已保存的Cookie,解决爬虫登录验证难题。通过安装配置、代码示例及requests库结合使用,实现无需手动输入账号密码即可访问需登录状态的网页内容,提升数据采集效率。