Python爬虫实现美剧资源批量抓取与保存
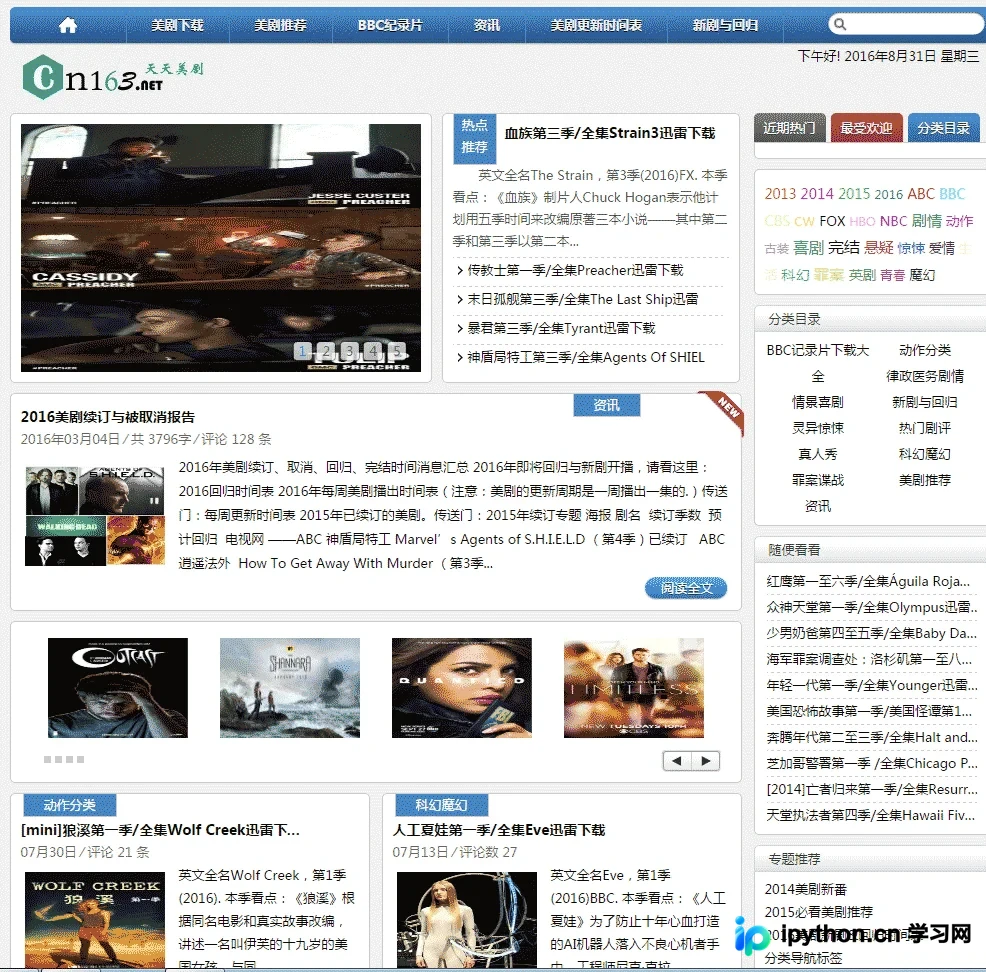
本文介绍如何使用Python编写爬虫程序,自动抓取美剧网站上的所有剧集下载链接。通过遍历URL编号、利用status_code过滤无效页面,并结合正则表达式提取ed2k链接,最终将结果按剧名保存为txt文件。文章还探讨了文件命名中的特殊字符处理及多线程在Python GIL限制下的实际效果。
2026-10-12
6

本文介绍如何使用Python编写爬虫程序,自动抓取美剧网站上的所有剧集下载链接。通过遍历URL编号、利用status_code过滤无效页面,并结合正则表达式提取ed2k链接,最终将结果按剧名保存为txt文件。文章还探讨了文件命名中的特殊字符处理及多线程在Python GIL限制下的实际效果。
本文演示如何使用现代Python工具编写网页爬虫,以豆瓣电影Top100为例,讲解构建URL地址池、伪造请求头、利用BeautifulSoup稳定解析HTML结构,并将提取到的电影名称与相关图片安全保存至本地。全文已修复原代码的版本缺陷,提供更可靠的执行逻辑与反爬规避建议。
本文基于Python 3与Requests库重构原版抓取逻辑,通过遍历MV编号区间、配置请求头伪装、正则表达式解析页面结构,并实现自动建目录与流式文件保存。针对静态页面解析瓶颈提供完整代码框架与异常处理方案,适用于学习网络请求与数据批量落盘的标准化流程。
本文详解如何在Python中安全有效地模拟HTTP POST数据提交并自动处理Cookie。通过对比现代requests库与内置urllib模块的实操代码,展示自动维持登录状态、自定义请求头及参数编码的完整流程,帮助开发者快速适配Web接口调用需求。
本文介绍Python中推荐的HTTP客户端库requests,通过一个模拟登录的示例展示其简洁用法。仅需少量代码即可实现会话保持、POST提交登录凭证及后续页面抓取,是Python数据采集的高效工具。
简要说明使用 Python 结合 requests 和 BeautifulSoup 库,通过模拟请求与 HTML 解析,批量获取京东商城特定分类下商品详情页链接的方法。提供完整代码、运行条件及反爬注意事项,适合初学者掌握基础网页数据提取流程。
本文详解如何利用Python的Requests库抓取通过Ajax异步加载的数据。通过浏览器开发者工具定位接口URL、参数及请求头,构造HTTP请求获取JSON数据并解析。相比Selenium模拟浏览器,该方法更高效直接,适用于需要高效获取动态渲染内容的场景。
在使用Python处理网络请求时,直接缓存全量响应会迅速耗尽系统内存。本文针对该痛点,利用requests的流式传输机制与分块读取技术,详细演示如何通过拦截服务端返回的Content-Length头信息,实时计算已下载占比。结合终端控制符循环刷新界面,最终输出平滑的动态进度条与实际运行耗时,兼顾稳定性与可视化效果。
本文详细介绍Python中Requests库的安装方法及常见用法。涵盖GET请求的参数传递与限制,POST请求的多种Body格式(JSON、Form、Binary)及文件上传实现。同时解析Response对象处理、Cookie获取与发送技巧,提供完整代码示例,帮助开发者快速掌握网络请求核心技能。
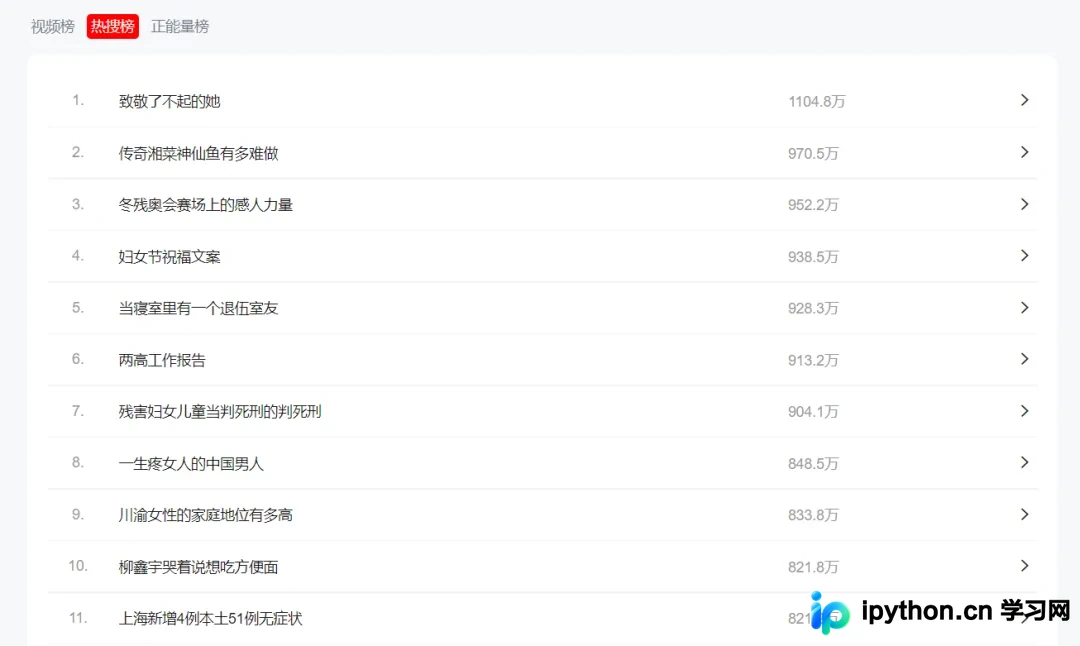
本文详细介绍如何使用Python爬取抖音热搜榜数据。通过对比requests和selenium两种方法,演示如何获取排名、热度、标题及链接,并利用lxml解析数据保存至Excel。最后结合Windows任务计划程序实现每小时自动运行,打造高效的热榜监控工具。
在软件授权或防篡改场景中,常需通过比对网络时间与本地时间来校验有效期。本文介绍两种Python实现方案:一是利用内置http.client模块解析HTTP响应头,手动转换时区;二是结合requests与arrow库同步服务器时钟偏差。文章提供完整可运行代码及关键参数说明,适用于本地部署与服务端对时的场景。
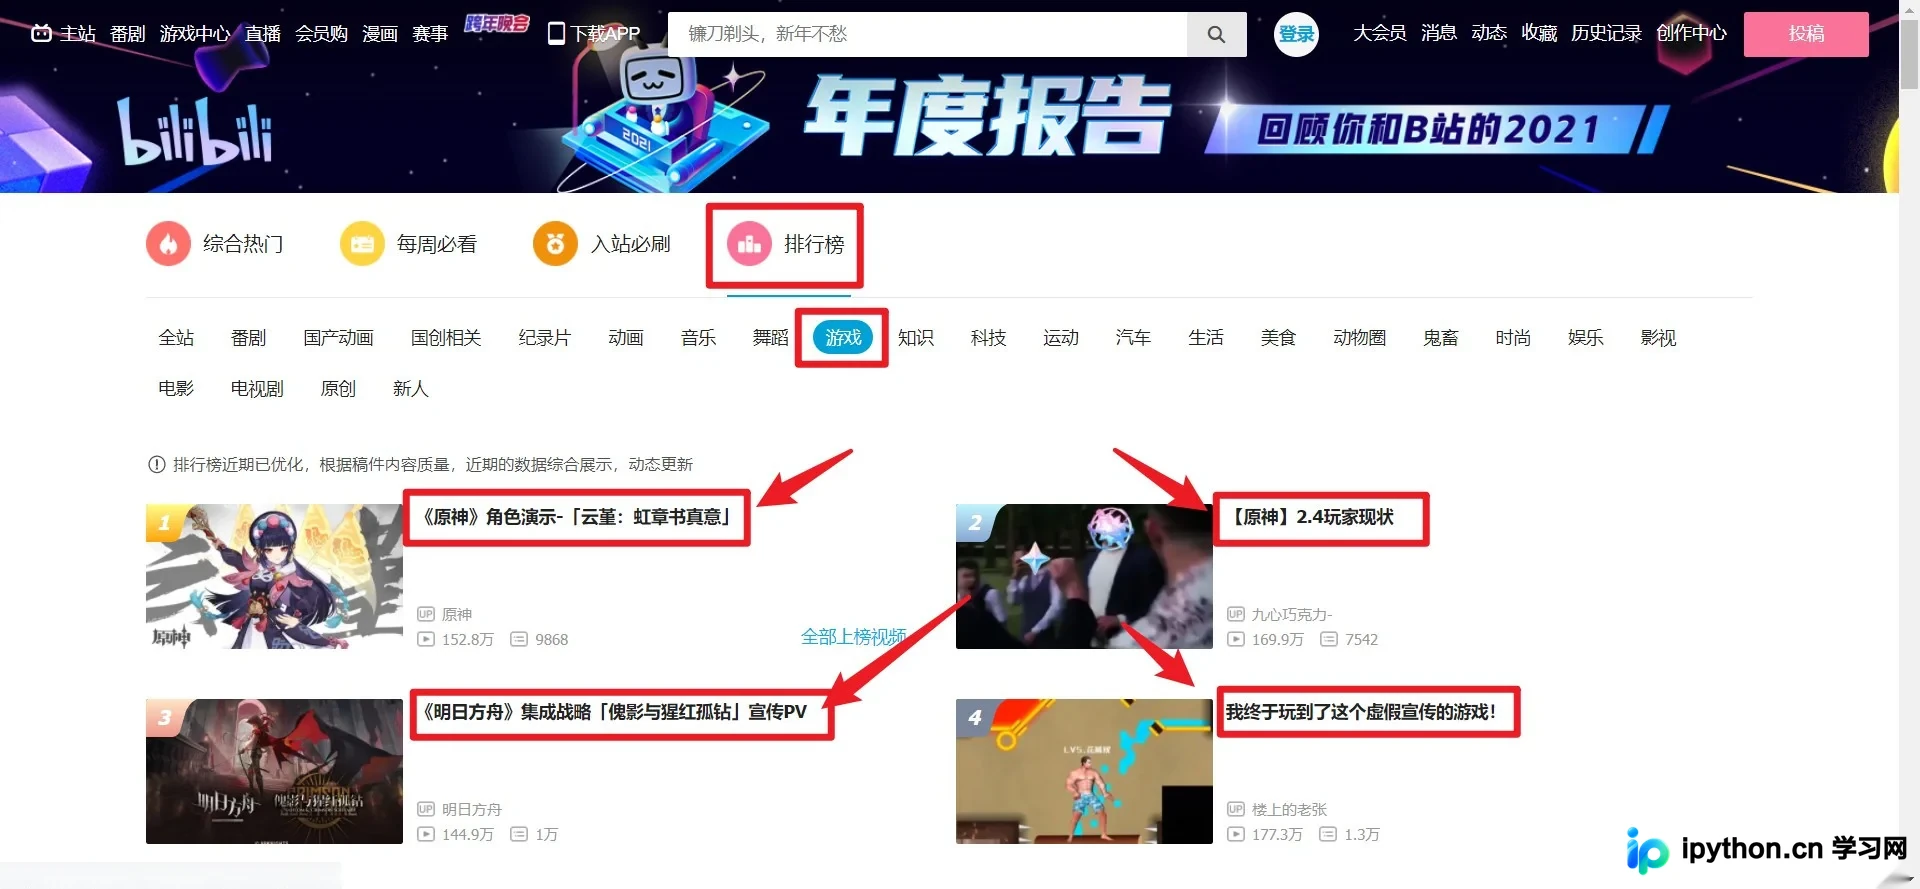
本文介绍如何使用Python的Requests和BeautifulSoup库,从Bilibili游戏排行榜页面抓取视频标题及对应链接。通过逐步优化代码,解决HTML解析、链接协议补全(http:)及数据提取问题,最终实现简洁高效的数据爬取,适合Python初学者参考学习。