

Python开发网站目录扫描器的实现
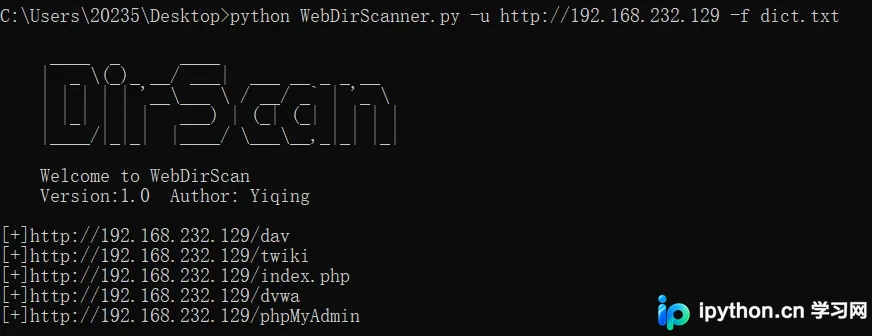
本文介绍如何使用Python开发一个网站目录扫描器。通过多线程技术提高扫描效率,利用requests库发送HTTP请求,并随机生成User-Agent以模拟不同浏览器。脚本支持指定目标URL、字典文件及线程数,最终将发现的目录结果保存为HTML文件。
2026-10-12
6

本文介绍如何使用Python开发一个网站目录扫描器。通过多线程技术提高扫描效率,利用requests库发送HTTP请求,并随机生成User-Agent以模拟不同浏览器。脚本支持指定目标URL、字典文件及线程数,最终将发现的目录结果保存为HTML文件。
本文详解如何在Python3中利用requests模块实现文件下载进度的实时显示。通过设置stream参数启用流式传输,结合Response.iter_content分块读取数据,并自定义ProgressBar类利用\r控制光标刷新,从而在控制台输出美观的下载进度条。
本文详细介绍如何在Python中使用requests模块发起HTTP请求。涵盖GET和POST两种常用方法,演示如何导入模块、选择请求方式及处理响应报文。通过百度访问示例说明HTML解析与编码设置,通过登录接口示例讲解字典参数传递与JSON响应处理,并展示如何获取响应头、编码格式及状态码等关键信息。
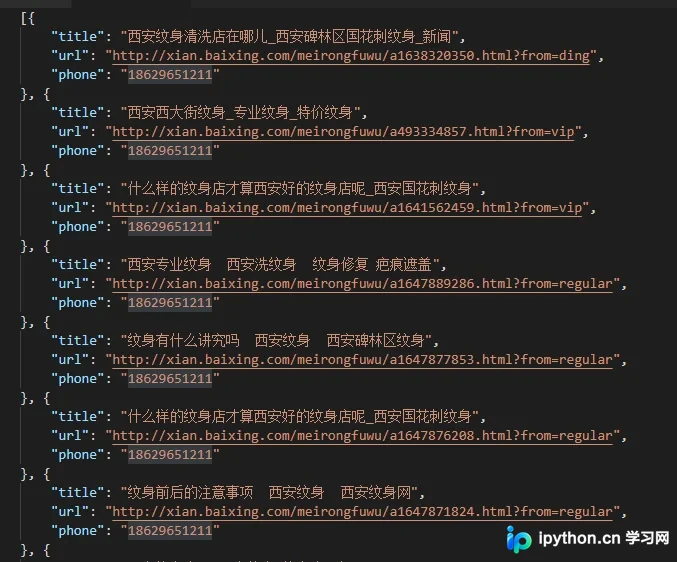
本文介绍如何使用Python3结合requests、lxml和json模块,爬取百姓网列表数据并保存为JSON格式。文章详细讲解了环境准备、代码实现及文件保存步骤,适合初学者参考学习。
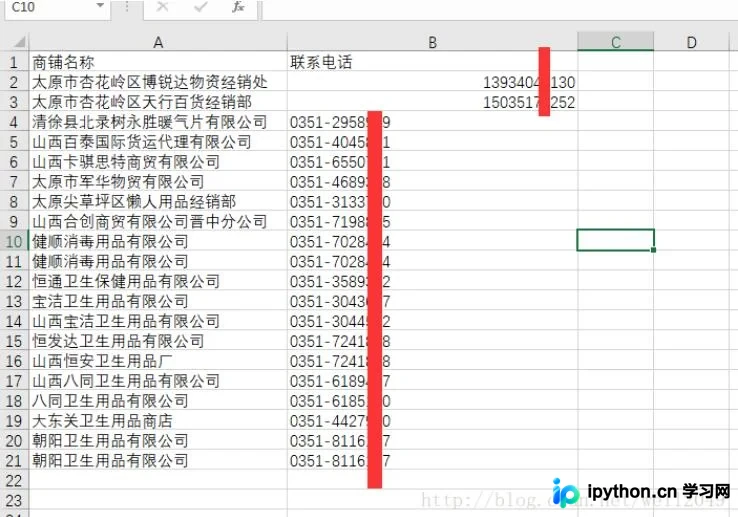
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
本文介绍使用Python多线程技术实现大文件分片下载并合并的完整流程。通过计算文件大小并设定步长,利用requests库的Range请求头并发获取数据块,最后按顺序写入文件完成合并。
本文介绍如何使用 Python 的 requests 库来测试代理 IP 是否生效。通过配置代理字典和请求头,向icanhazip.com发起GET请求,并打印返回的IP地址。若返回的IP与代理IP一致,则说明代理设置成功。
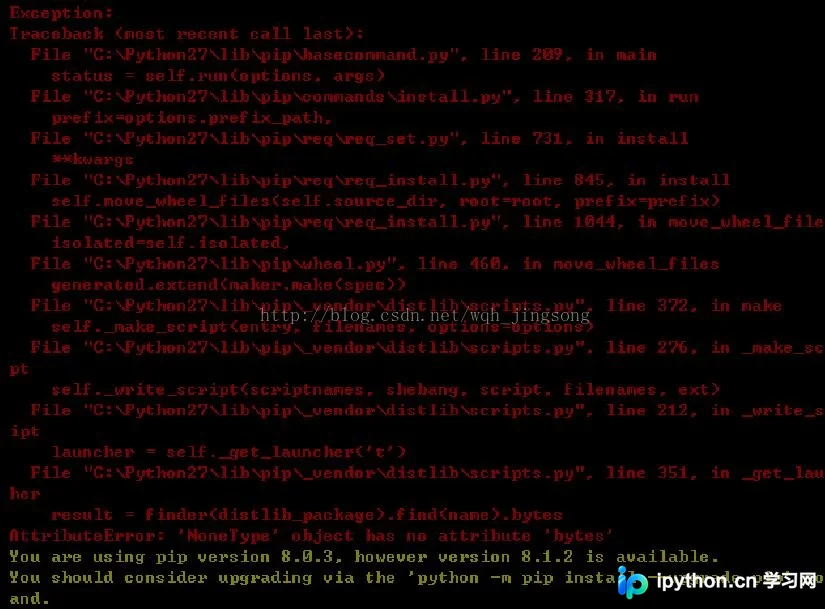
本文介绍在 Python 2.7.10 及以上版本中,如何解决自带 pip 版本滞后导致的下载缓慢问题。通过切换到安装目录并使用 python -m pip 命令升级 pip,以及多次尝试安装 requests 包,确保环境配置成功。
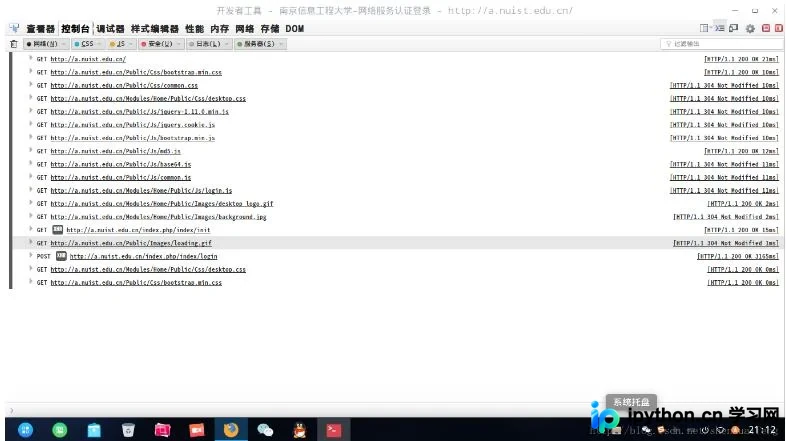
本文详细讲解如何利用Python和requests库实现校园网自动登录。通过Firefox浏览器和Firebug插件监控网络请求,分析POST请求的Header和Body参数。重点解析密码字段的Base64编码过程,并提供完整的Python登录脚本,帮助读者掌握网络请求模拟与数据构造技巧。
本文汇总了Python中使用requests库访问HTTPS网站时常见的SSL相关报错,包括InsecurePlatformWarning、certificate verify failed及bad handshake。针对CentOS旧环境或Python 2.7.5等场景,提供了升级Python、调整verify参数、重装特定版本certifi以及使用安全安装模式等具体解决步骤。
本文介绍如何使用Python多线程技术批量检测代理IP的有效性。通过读取本地IP文件,利用requests库发起HTTP请求,并结合threading模块实现并发测试。示例代码展示了线程池管理、结果去重及有效IP写入文件的完整流程,帮助开发者快速验证代理池质量。
本文介绍了如何在 Python 2.7 环境中利用 requests 库检测指定网页是否正常访问。通过设置超时参数获取 HTTP 状态码,判断返回码是否为 200,并据此输出访问成功或失败的提示信息及相应的退出状态码,适用于简单的连通性检查场景。