

Python 脚本实现 App 自动签到:逆向分析请求与积分获取
本文详解如何利用 Python 和 Requests 库实现某 App 的自动签到功能。通过浏览器开发者工具抓包分析登录与签到接口,解析请求参数与响应结构,解决密码加密固定值问题,最终编写脚本实现每日自动获取积分,并通过 Crontab 实现定时执行。
2026-10-13
6

本文详解如何利用 Python 和 Requests 库实现某 App 的自动签到功能。通过浏览器开发者工具抓包分析登录与签到接口,解析请求参数与响应结构,解决密码加密固定值问题,最终编写脚本实现每日自动获取积分,并通过 Crontab 实现定时执行。
本文详细解析使用Python进行网页爬虫的完整流程,涵盖BeautifulSoup库的核心用法、requests库发送带Header的请求、页面元素定位与数据提取,以及本地文件夹创建与图片文件保存的具体实现。通过一个完整的妹子图抓取案例,展示从建立连接到处理多页图片的实际操作,帮助开发者快速掌握基础爬虫技术。
本文介绍在Python中验证代理IP可用性的几种方法。通过urllib2构建代理 opener、使用requests库简化代码,以及利用telnetlib进行端口连通性测试。重点解析如何判断代理是否有效,并将可用IP存入Redis以便后续爬虫调用,帮助解决IP被封问题。
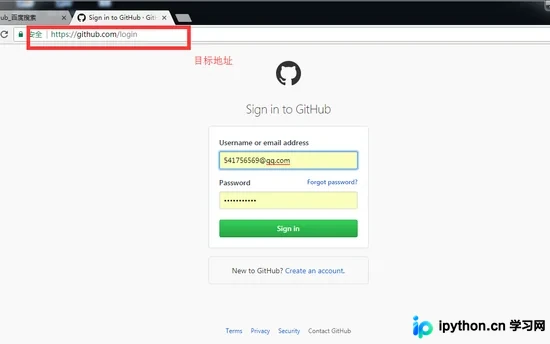
本文详细解析使用Python爬虫登录GitHub的技术流程。通过分析登录页面,提取CSRF Token与初始Cookie,利用Requests库发送GET请求获取必要参数,随后构造POST请求提交用户名和密码完成身份验证。最后演示如何携带登录后的Cookie访问个人详情页,实现自动化信息查看。
本文提供使用Python爬取哈尔滨天气信息的完整代码示例。环境基于Windows7与Python3.4,需安装requests和BeautifulSoup4库。文章详细解析了open函数的file、mode、buffering、encoding、errors及newline等参数用法,并附带可执行的爬虫代码,涵盖获取HTML、解析数据及写入CSV文件的全过程,适合Python初学者参考学习。
本文详细讲解如何使用Python的requests库进行接口测试。内容涵盖环境搭建、GET/POST请求参数传递(JSON与Form)、响应信息解析(text/content/json)、状态码及Headers获取。进阶部分深入介绍Cookies与Headers的手动设置、Session对象的跨请求状态保持机制,以及连接与读取超时的配置方法,帮助开发者掌握自动化接口测试的核心技能。
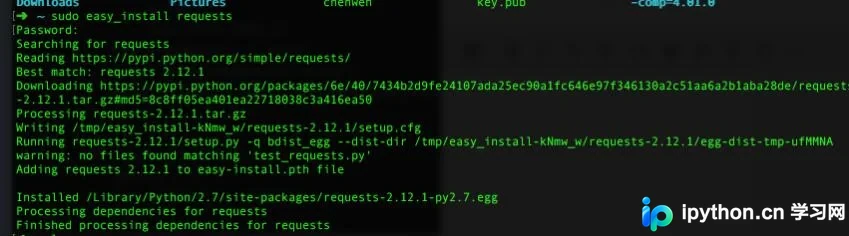
本文介绍在macOS系统中安装Python网络请求库requests的方法。通过执行sudo easy_install requests命令,用户可快速完成安装。安装成功后,即可在Python项目中正常使用requests进行网络请求操作。
本文介绍在Mac系统中通过Homebrew安装Python 3后,利用自动生成的pip3工具快速安装requests和Scrapy第三方库的方法。文章简要说明了从Python 2过渡到Python 3的需求,并提供了具体的命令行安装步骤,帮助用户解决Mac环境下Python库配置问题。
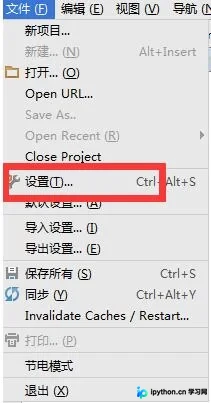
本文介绍在PyCharm中无需使用pip即可安装第三方库的方法。通过文件设置进入Project Interpreter,利用内置搜索功能添加模块。注意Python 3.x环境下可能无法直接搜索到如urllib2等仅适用于2.x版本的库,需根据实际需求调整解释器或查阅相关资料。
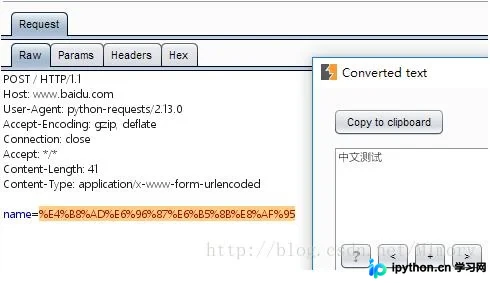
本文详解Python中requests模块处理中文参数的三种方式:字典自动编码、字符串原样输出及格式化导致bytes类型的问题。通过具体代码示例与注意事项,帮助开发者解决HTTP请求中中文参数编码异常,提供手动编码与自动编码的最佳实践建议。
本文介绍在Python中利用requests库处理HTTP 302重定向以获取文件真实链接的两种方案。通过设置allow_redirects参数控制head请求行为,或直接使用get方法自动跟随重定向,从而准确获取最终URL及响应头信息。
本文介绍在 Python 项目中处理 URL 重定向以获取真实地址的方法。通过 requests 库发送请求并提取最终 URL,同时补充了包含最大重试次数限制和状态码检查的完善代码,确保在网络异常时能自动重试,提高获取真实链接的稳定性。