

Python requests模块中文参数编码的三种处理方案

本文详解Python中requests模块处理中文参数的三种方式:字典自动编码、字符串原样输出及格式化导致bytes类型的问题。通过具体代码示例与注意事项,帮助开发者解决HTTP请求中中文参数编码异常,提供手动编码与自动编码的最佳实践建议。
在使用Python的requests模块发起HTTP请求时,开发者常遇到中文参数未被自动进行URL编码的情况,且该模块并未提供如Python3中urllib.parse.quote("中文")那样的手动编码接口。经过研究,发现requests模块对中文参数主要存在三种不同的处理机制。
一、requests模块自动URL编码参数
若希望参数能够自动完成URL编码,需将请求参数定义为字典类型。具体实现示例如下:
import requests

proxy = {"http":"http://127.0.0.1:8080",
 "https":"http://127.0.0.1:8080"}

def reTest():
 url = "http://www.baidu.com"
 pdict = {"name":"中文测试"}
 requests.post(url = url,data = pdict,proxies = proxy)
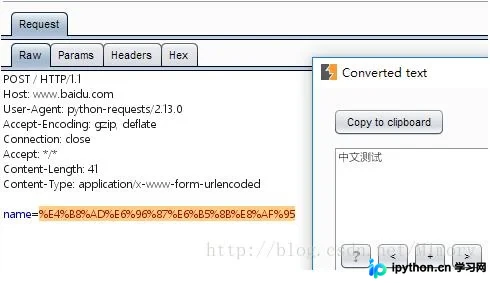
运行效果如图所示,中文内容已被正确进行URL编码处理。
二、参数原样输出,无需编码处理
当使用字典定义参数时,requests模块会自动对参数进行URL编码。但在某些特定场景下,可能不需要进行编码,而是要求参数保持原样输出。此时,直接将参数定义为字符串即可实现该需求。
import requests

proxy = {"http":"http://127.0.0.1:8080",
 "https":"http://127.0.0.1:8080"}

def reTest():
 url = "http://www.baidu.com"
 pstr1 = "name=中文".encode("utf-8")
 requests.post(url = url,data = pstr1, proxies = proxy)
注意:参数必须采用utf-8编码,否则程序会报错提示:Use body.encode('utf-8') if you want to send it encoded in UTF-8。
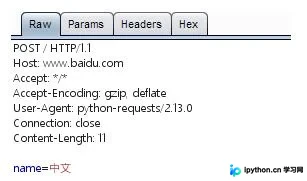
最终效果如图所示,参数以原样形式输出。
三、使用format或%格式化导致参数变为bytes类型
在某些情况下,直接定义的字符串参数中包含变量,需要通过format或%运算符进行格式化控制。此时会发现,格式化后的参数类型变成了bytes。
import requests

proxy = {"http":"http://127.0.0.1:8080",
 "https":"http://127.0.0.1:8080"}

def reTest():
 url = "http://www.baidu.com"
 pstr2 = "name={0}".format("中文".encode("utf-8"))
 requests.post(url = url,data = pstr2, proxies = proxy)
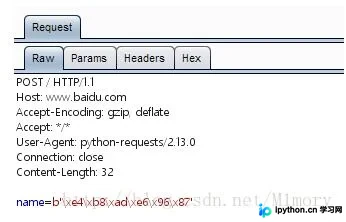
参数类型已转换为bytes。
针对此类请求场景:
1. 若参数需要进行URL编码,当参数数量较少时,建议使用dict定义。若参数数量较多,使用dict较为繁琐,可针对具体参数使用urllib.parse.quote("中文")手动进行encode编码。
2. 若中文参数需要原样输出,可在格式化完成后进行编码处理。例如:pstr2 = "name={0}".format("中文").encode("utf-8")。
以上关于Python中requests模块参数编码的不同处理方法即为全部内容,希望能对各位有所帮助,也欢迎大家继续关注本站以获取更多信息。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









